ปัญหาที่แก้
- ตอนนี้คนใช้เอไอไม่มีทางรู้แน่ว่าคำตอบมาจากโมเดลที่เลือกไว้จริงหรือเปล่า
- บริการตัวกลางที่ส่งต่องานให้โมเดล อาจแอบสลับไปใช้รุ่นถูกกว่าเพื่อลดต้นทุน
- คนร้ายที่เจาะเซิร์ฟเวอร์ก็อาจแก้คำตอบกลางทางได้
- Anthropic บอกว่าดูจากคุณภาพคำตอบอย่างเดียว เชื่อถือไม่ได้
ทำงานยังไง
- ใช้เทคนิคเข้ารหัสที่เรียกว่า zkSNARK แบบเดียวกับที่ใช้ในเครือข่ายคริปโตอย่าง Starknet
- ขั้นแรก ผู้ให้บริการประกาศลายนิ้วมือของน้ำหนักโมเดลไว้ก่อน โดยไม่ต้องเปิดเผยน้ำหนักจริง
- พอตอบคำถาม ผู้ให้บริการสร้างไฟล์พิสูจน์ว่าโมเดลที่ประกาศไว้ให้คำตอบนี้ออกมาจริง
- ใครมีลายนิ้วมือ คำถาม และคำตอบ ก็ตรวจเองได้ ไม่ต้องมีตัวโมเดลและไม่ต้องใช้การ์ดจอ
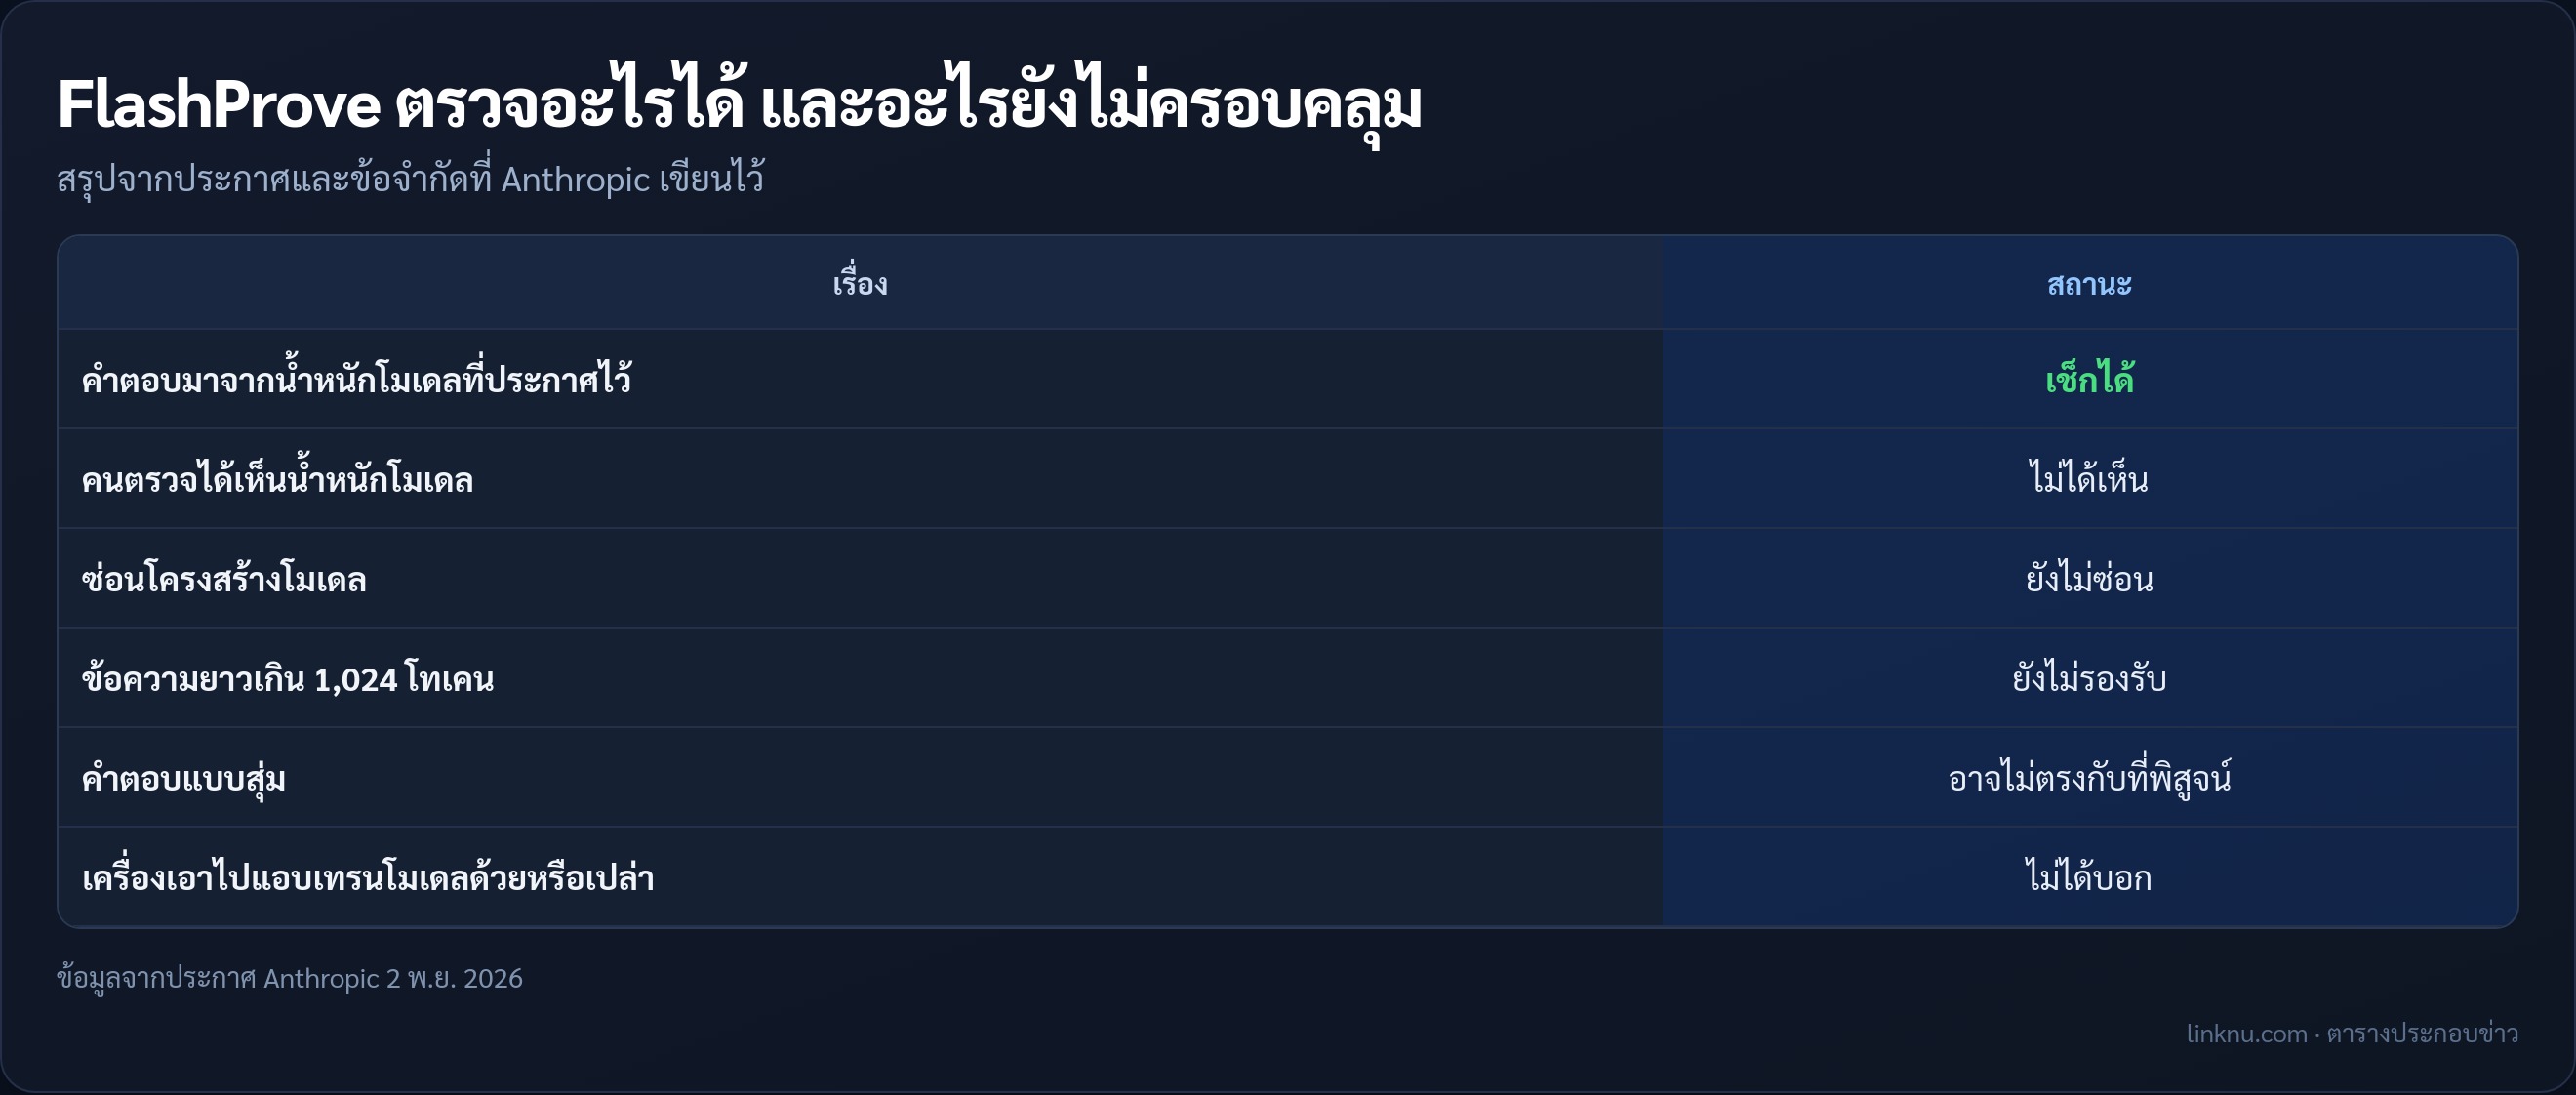
- ไฟล์พิสูจน์ไม่เผยน้ำหนักโมเดล ไม่เผยค่าระหว่างคำนวณ และไม่บอกว่าโมเดลเรียกใช้ส่วนย่อยไหน
- จะปลอมไฟล์พิสูจน์ได้ ต้องแก้โจทย์คณิตศาสตร์ที่เชื่อกันว่าแทบเป็นไปไม่ได้
- Anthropic บอกว่า Claude ช่วยคิดวิธีปรับปรุงจนเร็วกว่าระบบโอเพนซอร์สเดิมมาก
ตัวเลขจากการทดลองของ Anthropic
- ทดลองกับ Llama 4 Maverick โมเดลขนาด 400B พารามิเตอร์ แบบ 4 บิต
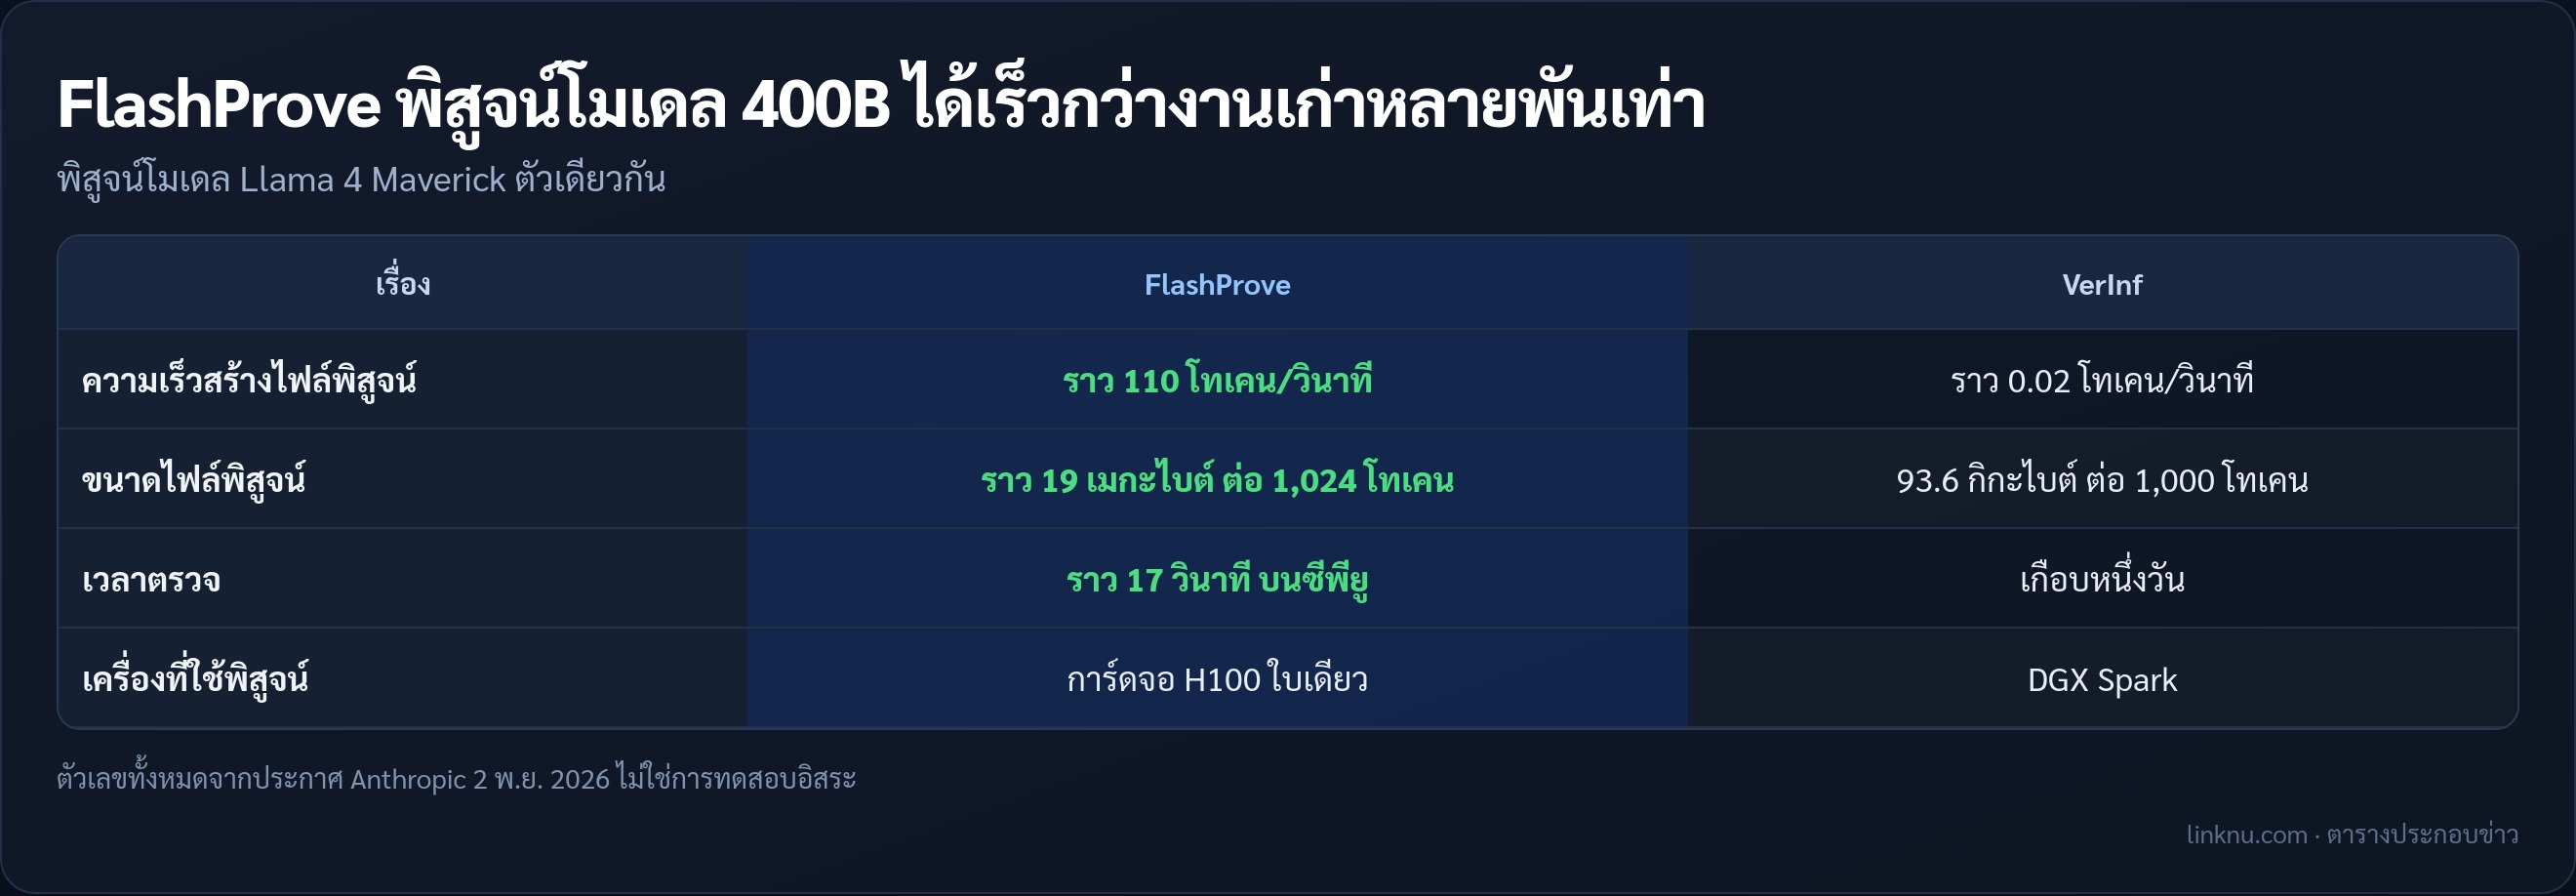
- การ์ดจอ H100 ใบเดียวสร้างไฟล์พิสูจน์ได้ราว 110 โทเคนต่อวินาที
- ไฟล์พิสูจน์ราว 19 เมกะไบต์ ต่อคำขอยาว 1,024 โทเคน
- ฝั่งคนตรวจใช้ซีพียู 24 เธรด ตรวจหนึ่งไฟล์ราว 17 วินาที ถ้าเธรดเดียวราว 21 วินาที
- ใช้เวลาการ์ดจอมากกว่ารันโมเดลปกติบน vLLM ราว 70–95 เท่า
- ขั้นประกาศลายนิ้วมือทำครั้งเดียวต่อโมเดล ใช้ราว 39 นาที และใช้ได้ราว 16 ล้านคำขอ
เทียบกับงานเก่า
- งานก่อนหน้าที่พิสูจน์โมเดลตัวเดียวกันคือ VerInf ทำได้ราว 0.02 โทเคนต่อวินาที
- VerInf ใช้ 14.3 ชั่วโมงต่อ 1,000 โทเคน ไฟล์พิสูจน์ใหญ่ 93.6 กิกะไบต์ และตรวจเกือบหนึ่งวัน
- ตัวเลขฝั่งงานเก่ามาจากที่ Anthropic สรุปไว้ในประกาศ
เอาไปใช้ทำอะไรได้
- ทีมประเมินอิสระมั่นใจได้ว่ากำลังทดสอบโมเดลตัวเดียวกับที่เปิดให้คนใช้จริง
- ลูกค้าที่ใช้ผ่านบริการตัวกลาง เช็กได้ว่าได้โมเดลที่จ่ายเงินซื้อ
- บริษัทเช็กได้ว่าเซิร์ฟเวอร์ตัวเองถูกเจาะหรือถูกสลับโมเดลหรือเปล่า
- หน่วยงานกำกับตรวจได้ว่าผู้ให้บริการใช้แต่โมเดลที่ผ่านการอนุมัติ
ที่ยังทำไม่ได้
- เป็นต้นแบบงานวิจัย ยังไม่ใช่ของพร้อมใช้จริง
- ตอนนี้รับข้อความได้แค่ 1,024 โทเคน สั้นมากเมื่อเทียบกับแชตทั่วไป
- พิสูจน์เฉพาะแบบที่โมเดลเลือกคำที่น่าจะเป็นที่สุดทุกครั้ง ถ้าตอบแบบสุ่ม ผลอาจไม่ตรง
- ซ่อนน้ำหนักโมเดลได้ แต่ยังไม่ซ่อนโครงสร้างโมเดล
- ออกแบบมาสำหรับโมเดลแบบผสมผู้เชี่ยวชาญ หรือ MoE
- ยังไม่กันการแอบจับเวลาเพื่อเดาข้อมูลโมเดล
- ตัวตรวจแบบเร็วยังไม่มีการรับรองทางคณิตศาสตร์
ของที่ปล่อยออกมา
- โค้ดตัวสร้างไฟล์พิสูจน์ และตัวตรวจสองแบบ
- ตัวตรวจแบบเร็วเขียนด้วย C++ ส่วนอีกตัวพิสูจน์ความถูกต้องไว้ด้วย Lean
- บทพิสูจน์ใน Lean รายงานเทคนิค และเอกสารสเปกที่ Claude เขียน
- ใช้สัญญาอนุญาต Apache 2.0 เอาไปใช้และต่อยอดได้
- โค้ดอยู่ที่ github.com/anthropics/FlashProve
- ไม่ได้แจกน้ำหนักโมเดล คนอยากลองต้องโหลด Llama เองตามสัญญาของ Meta
ทีมวิจัย
- งานนี้มาจากทีมเรดทีมแนวหน้าของ Anthropic
- Roy Rinberg จาก Anthropic
- Alex Allain จาก Anthropic
- Alessandro Chiesa จาก EPFL
- Chiesa ยังสังกัดบริษัทคริปโต StarkWare ด้วย
- Miranda Christ จาก MIT
- มีนักวิจัยจากมหาวิทยาลัย EPFL และโครงการทุนวิจัยของ Anthropic ร่วมด้วย
ภาพใหญ่
- Anthropic เคยตั้งเป้าว่าจะมีต้นแบบตรวจที่มาของคำตอบโมเดลภายใน 30 ก.ย. 2026
- บริษัทบอกว่าทำได้แล้วผ่านอีกโปรเจกต์ ที่เซ็นรับรองคำตอบแล้วคำนวณซ้ำบนเซิร์ฟเวอร์ที่ไว้ใจได้
- FlashProve คือการไล่เป้าเดียวกันด้วยวิธีเข้ารหัสล้วน ๆ ไม่พึ่งฮาร์ดแวร์พิเศษ
สรุป
ต่อไปเวลาจ่ายเงินใช้โมเดลแพง อาจขอใบเสร็จทางคณิตศาสตร์ได้ว่าได้ของจริง แต่ตอนนี้ยังช้ากว่ารันปกติหลายสิบเท่า และรับข้อความได้สั้น ๆ เท่านั้น
แหล่ง: Anthropic · 2 พ.ย. 2026