เปิดตัวอะไร
- ชื่อเต็มคือ Nemotron 3.5 Transcribe เปิดให้โหลดบนฮักกิ้งเฟซและโมเดลสโคปตั้งแต่ 28 ต.ค. 2026
- เป็นโมเดลภาษาที่ฟังเสียงได้ รับไฟล์เสียงพร้อมคำสั่งเป็นข้อความ แล้วตอบกลับเป็นข้อความ
- งานหลักคือถอดเสียง แปลเสียงไปกลับกับภาษาอังกฤษ ติดป้ายผู้พูด และตอบคำถามจากไฟล์เสียง
- รับไฟล์เสียงยาวได้ถึง 1 ชั่วโมง แยกผู้พูดได้สูงสุด 8 คน
- ใช้คำสั่งภาษาคนคุมรูปแบบได้ เช่น ให้ใส่ชื่อผู้พูด ให้แปลเป็นอังกฤษ หรือให้สรุปว่าที่ประชุมตกลงอะไรกัน
- ใส่รายการศัพท์เฉพาะให้ช่วยสะกดถูก เช่น ชื่อยาหรือศัพท์การแพทย์ ได้โดยไม่ต้องฝึกโมเดลใหม่
ภาษาไทยได้แค่ไหน
- บริษัทจัดภาษาไทยไว้ระดับพร้อมใช้งานจริง ใช้ได้ทั้งถอดเสียง แปลไปกลับกับอังกฤษ แยกผู้พูด และเสียงที่พูดปนสองภาษา
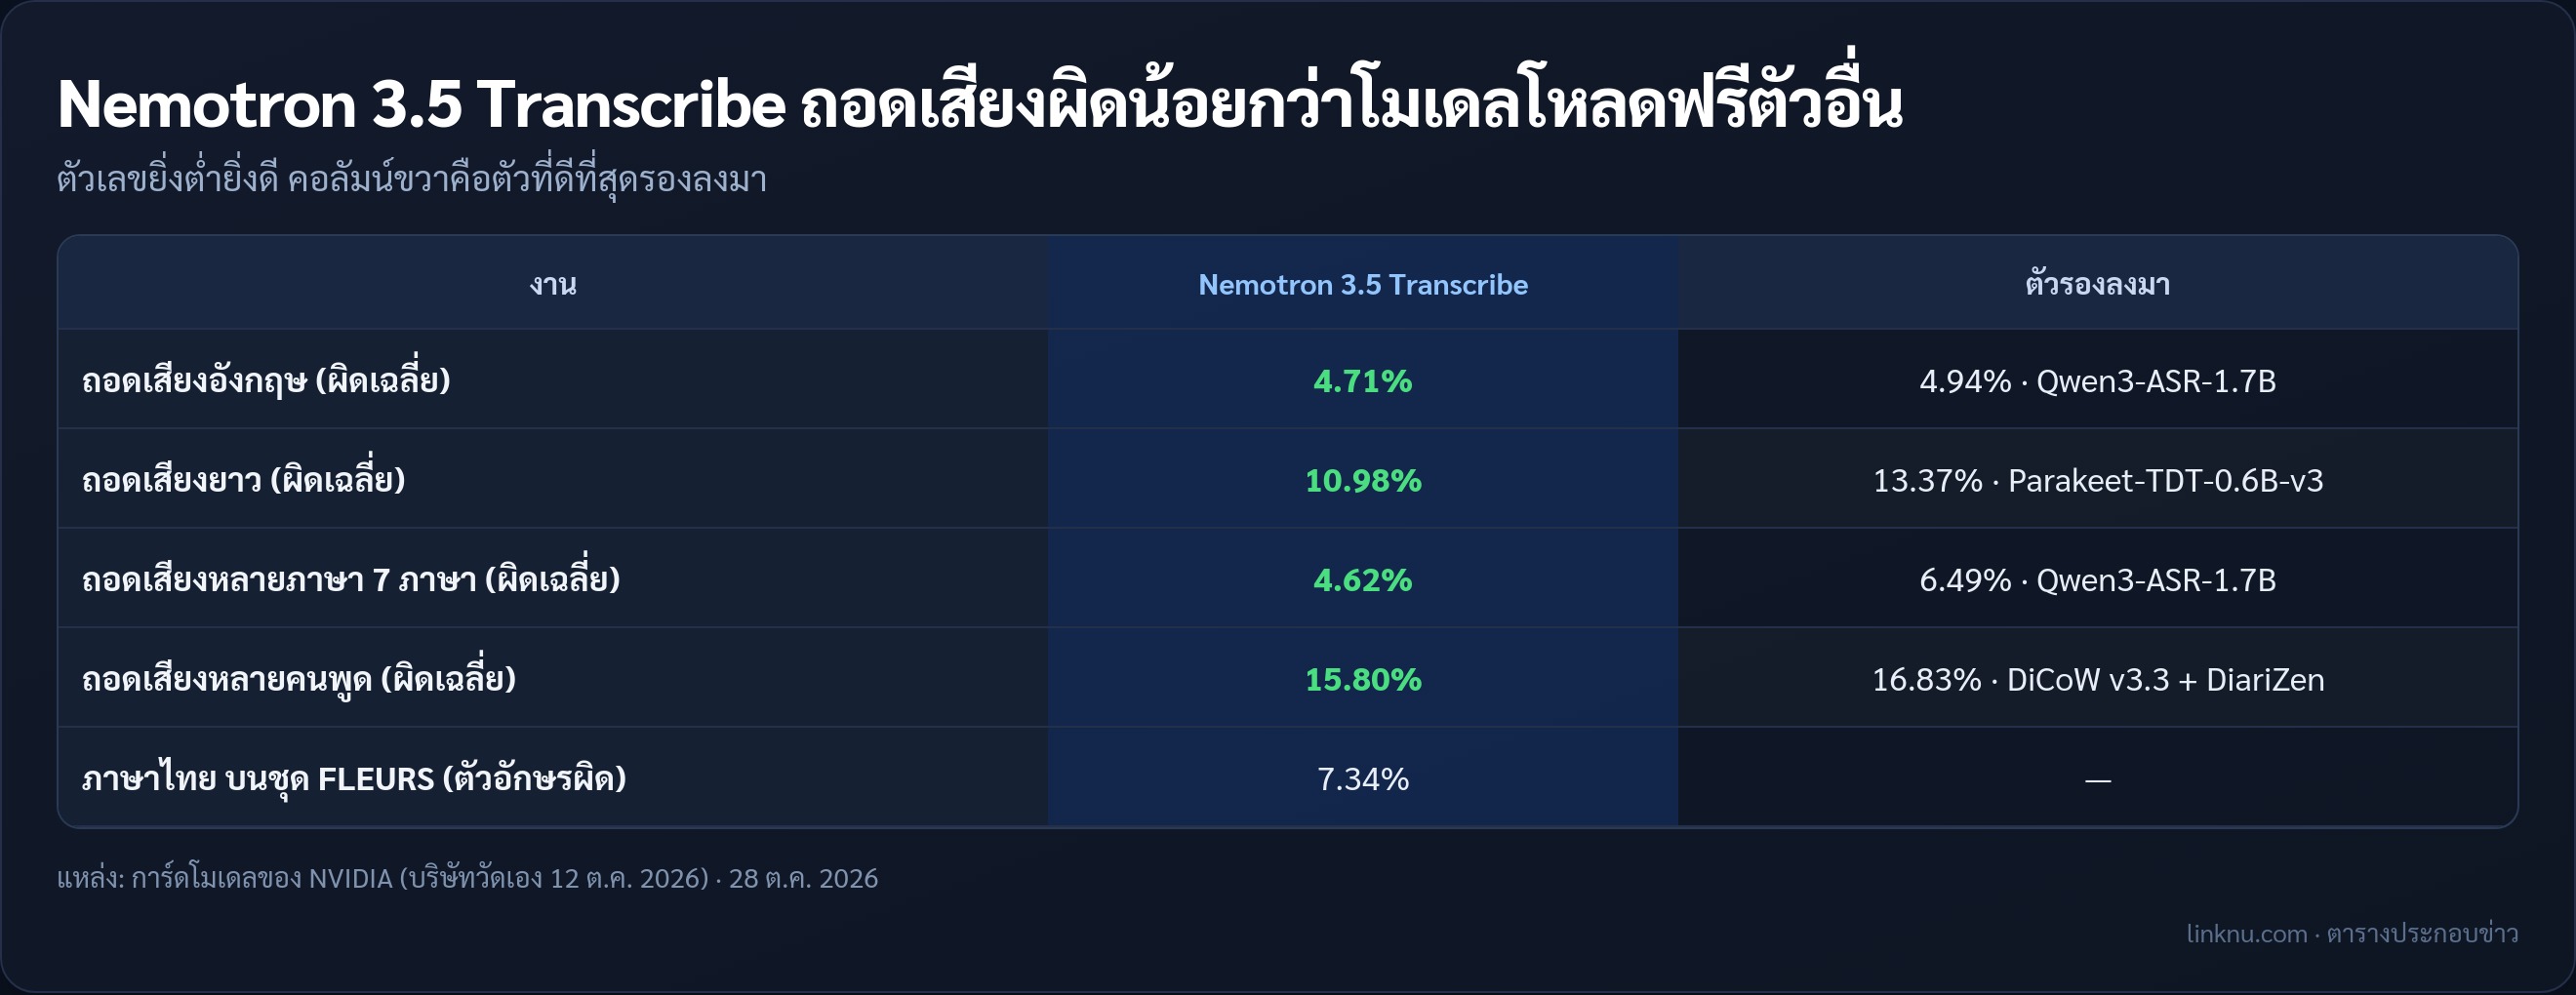
- อัตราตัวอักษรผิดของภาษาไทยบนชุดทดสอบ FLEURS อยู่ที่ 7.34% ตามการ์ดโมเดล
- ส่วนการตอบคำถามจากไฟล์เสียง บริษัททดสอบเฉพาะภาษาอังกฤษ ภาษาอื่นอาจยังทำได้ไม่ดี
ตัวเลขที่บริษัทเผยแพร่
- ถอดเสียงภาษาอังกฤษบน Open ASR Leaderboard ผิดเฉลี่ย 4.71% อันดับหนึ่งในกลุ่มโมเดลโหลดฟรี
- ตัวที่ตามมาคือ Qwen3-ASR-1.7B ผิดเฉลี่ย 4.94%
- เสียงยาวผิดเฉลี่ย 10.98% เทียบ 13.37% ของ Parakeet รุ่นก่อนของ NVIDIA เอง
- ถอดเสียงหลายภาษาผิดเฉลี่ย 4.62% เทียบ 6.49% ของ Qwen3-ASR
- ตัวเลขทั้งหมดบริษัทวัดเองเมื่อ 12 ต.ค. 2026 บนกระดานทดสอบสาธารณะ
ใช้งานยังไง
- ขนาดรวม 34,000 ล้านพารามิเตอร์ แต่ทำงานจริงทีละราว 4,300 ล้าน เลยรันบนการ์ดจอ H100 ใบเดียวได้
- มีไฟล์ย่อขนาดแบบ FP8 และ NVFP4 ให้เลือก
- สัญญาอนุญาตแบบ OpenMDW ใช้เชิงพาณิชย์ได้
- บริษัทปล่อยชุดข้อมูลเสียง Granary v2 และสูตรฝึกต่อ ให้ปรับโมเดลเข้ากับงานของตัวเองได้
- กรณีทดสอบงานแพทย์ ฝึกต่อแล้วคำผิดลดลงราว 46% เมื่อเทียบกับการใช้แค่คำสั่ง
- เวอร์ชันที่เร่งความเร็วเต็มที่ยังอยู่ในบริการ NIM ของ NVIDIA ตัวโอเพนซอร์สตอนนี้ช้ากว่าราวสองเท่า
สรุป
งานถอดเสียงประชุม คอลเซ็นเตอร์ หรือคลิปวิดีโอ เดิมต้องต่อหลายโมเดลเข้าด้วยกัน ตัวนี้รวมไว้ในตัวเดียวและโหลดมาลงเครื่องตัวเองได้ คนทำระบบภาษาไทยมีตัวเลือกที่ไม่ต้องส่งเสียงลูกค้าออกไปนอกบริษัทเพิ่มอีกตัว
แหล่ง: NVIDIA · 28 ต.ค. 2026