เปิดตัวอะไร
- Prism เป็นโมเดลแปลงเสียงเป็นเสียง ฟังเสียงคนโทรแล้วตอบกลับเป็นเสียงเลย
- ใช้แทนสามขั้นตอนเดิม คือแปลงเสียงเป็นข้อความ ส่งให้โมเดลภาษา แล้วแปลงกลับเป็นเสียง
- ระบบเดิมแบบนั้นเสียน้ำเสียงคนโทรไป เช่น ความหงุดหงิด เสียงหัวเราะ
- Lily Clifford ซีอีโอของ Rime บอกว่าทีมใช้เวลาสร้างราว 6 เดือน
ต่างจากโมเดลเสียงของบริษัทใหญ่ยังไง
- โมเดลเสียงทั่วไปพูดออกมาเลย คนทำระบบตรวจก่อนไม่ได้ว่าจะพูดอะไร
- Prism ตัดสินใจจากเสียงจริง แต่เขียนคำตอบเป็นข้อความก่อนพูด
- ระบบของบริษัทจึงตรวจคำตอบกับกฎ ข้อห้าม หรือข้อความที่ต้องแจ้งลูกค้าได้ทุกคำ
- เรียกใช้เครื่องมือ เช่น ค้นข้อมูลบัญชี ไปพร้อมกับพูดได้ ไม่มีช่วงเงียบ
- บริษัทบอกว่าเป็นโมเดลเสียงตัวแรกที่ลูกค้าปรับจูนด้วยข้อมูลตัวเองได้
คะแนนที่บริษัทวัดเอง
- ใช้ชุดทดสอบ τ-Voice ของ Artificial Analysis ซึ่งจำลองสายลูกค้าสายการบิน ร้านค้า และผู้ให้บริการมือถือ
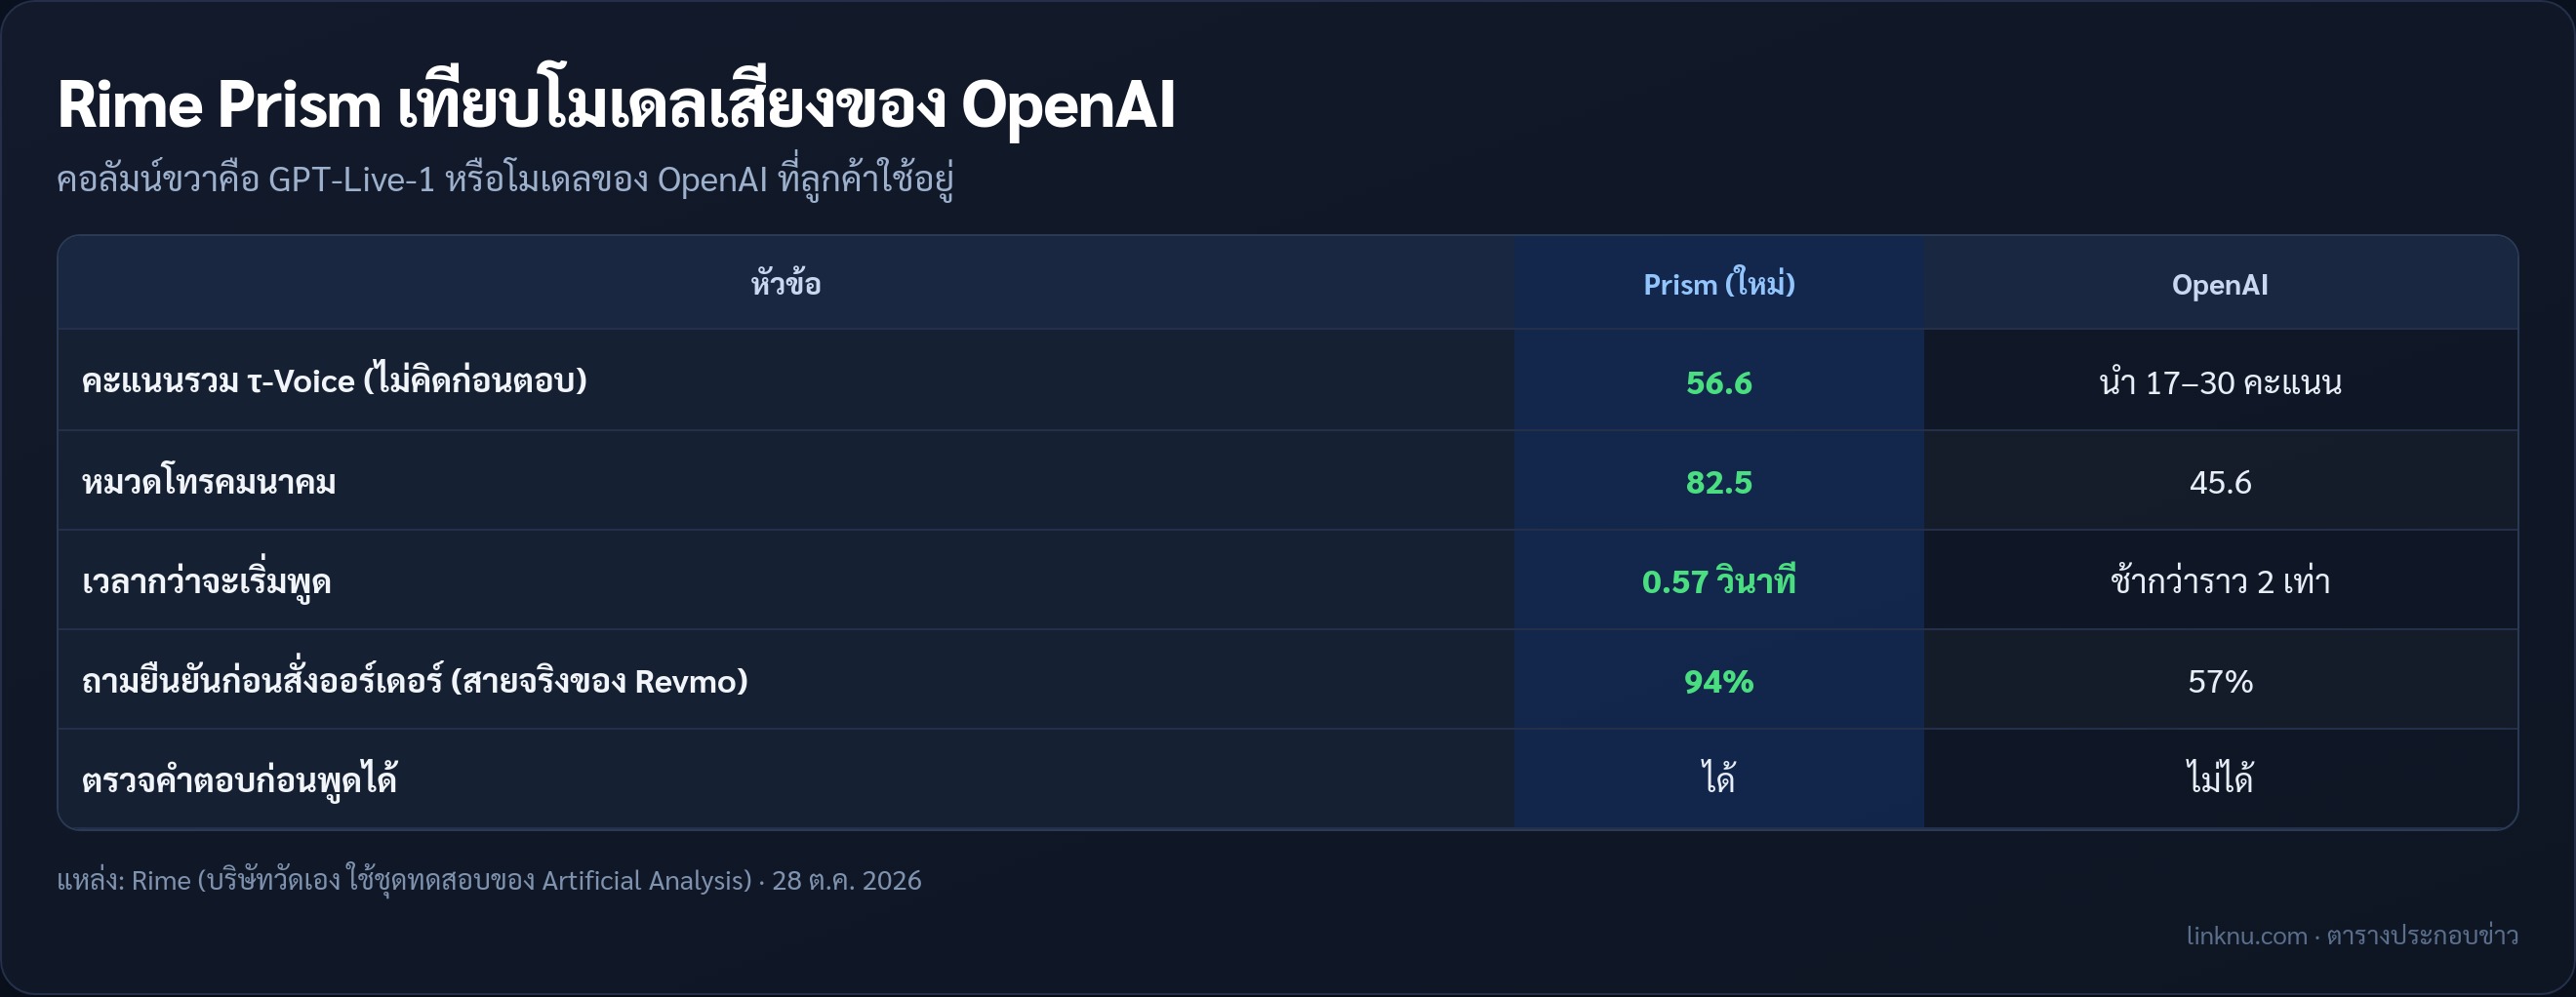
- Prism ได้ 56.6 คะแนน นำโมเดลเสียงแบบไม่คิดก่อนตอบของ OpenAI และกูเกิล 17–30 คะแนน
- หมวดโทรคมนาคมที่ต้องจำเลขบัญชีและเบอร์โทร ได้ 82.5 เทียบ 45.6 ของ GPT-Live-1
- เริ่มพูดใน 0.57 วินาที เร็วกว่า GPT-Live-1 ราวครึ่งหนึ่ง
- สองโมเดลที่คะแนนสูงกว่าต้องคิดก่อนพูด และใช้เวลา 1.24–1.35 วินาทีกว่าจะเริ่มพูด
- ทุกตัวเลขบริษัทรันเอง ยังไม่ขึ้นกระดานทดสอบอิสระ
ลองกับลูกค้าจริง
- Rime เอาบทสนทนาจริงราว 10 ชั่วโมงของ Revmo ระบบรับออร์เดอร์ทางโทรศัพท์ มาฝึก Prism เพิ่ม
- ผลคือ 94% ของออร์เดอร์ถูกส่งหลังลูกค้าตอบยืนยันก่อน
- ระบบเดิมที่ใช้โมเดลของ OpenAI ทำได้ 57%
ใช้ได้เมื่อไหร่
- ตอนนี้ยังเป็นรุ่นทดลองแบบปิด ต้องสมัครเข้าร่วมก่อน
- บริษัทบอกว่าจะเปิดให้เรียกใช้ผ่านระบบทั่วไปเร็ว ๆ นี้
- ติดตั้งได้ทั้งบนคลาวด์ ในเครือข่ายของบริษัทเอง หรือในเซิร์ฟเวอร์ของลูกค้า
- ช่วงแรกยังผลัดกันพูดทีละฝั่ง ส่วนการพูดแทรกกันได้แบบคนจริงอยู่ในแผน
สรุป
งานคอลเซ็นเตอร์อยากได้เอไอที่ฟังน้ำเสียงออก แต่ก็ต้องคุมได้ว่ามันจะพูดอะไร Prism พยายามให้ได้ทั้งสองอย่าง ถ้าตัวเลขยืนยันได้จริงเมื่อเปิดให้ใช้ทั่วไป โมเดลเสียงของบริษัทใหญ่จะมีคู่แข่งในงานองค์กรเพิ่มอีกราย
แหล่ง: Rime · 28 ต.ค. 2026