เด่นตรงไหน
- ขนาด 3.3 หมื่นล้านพารามิเตอร์ เป็นโมเดลแบบทึบที่ใช้พารามิเตอร์ทุกตัวทุกครั้งที่ตอบ
- รับข้อความยาวได้ราว 5.2 แสนโทเคน อ่านโค้ดทั้งโปรเจกต์หรือเอกสารยาว ๆ ได้ในรอบเดียว
- มีโหมดคิดก่อนตอบ เปิดปิดได้ และเลือกให้จำความคิดจากรอบก่อน ๆ ไว้ได้ เหมาะกับงานเอเจนต์ที่ทำต่อกันหลายขั้น
- ใช้สัญญาอนุญาตแบบ Apache 2.0 เอาไปใช้ในงานเชิงพาณิชย์ได้
- ปล่อยรุ่นฐานที่ยังไม่ผ่านการปรับแต่งมาด้วย ให้คนเอาไปฝึกต่อเอง
คะแนนที่บริษัทเคลม
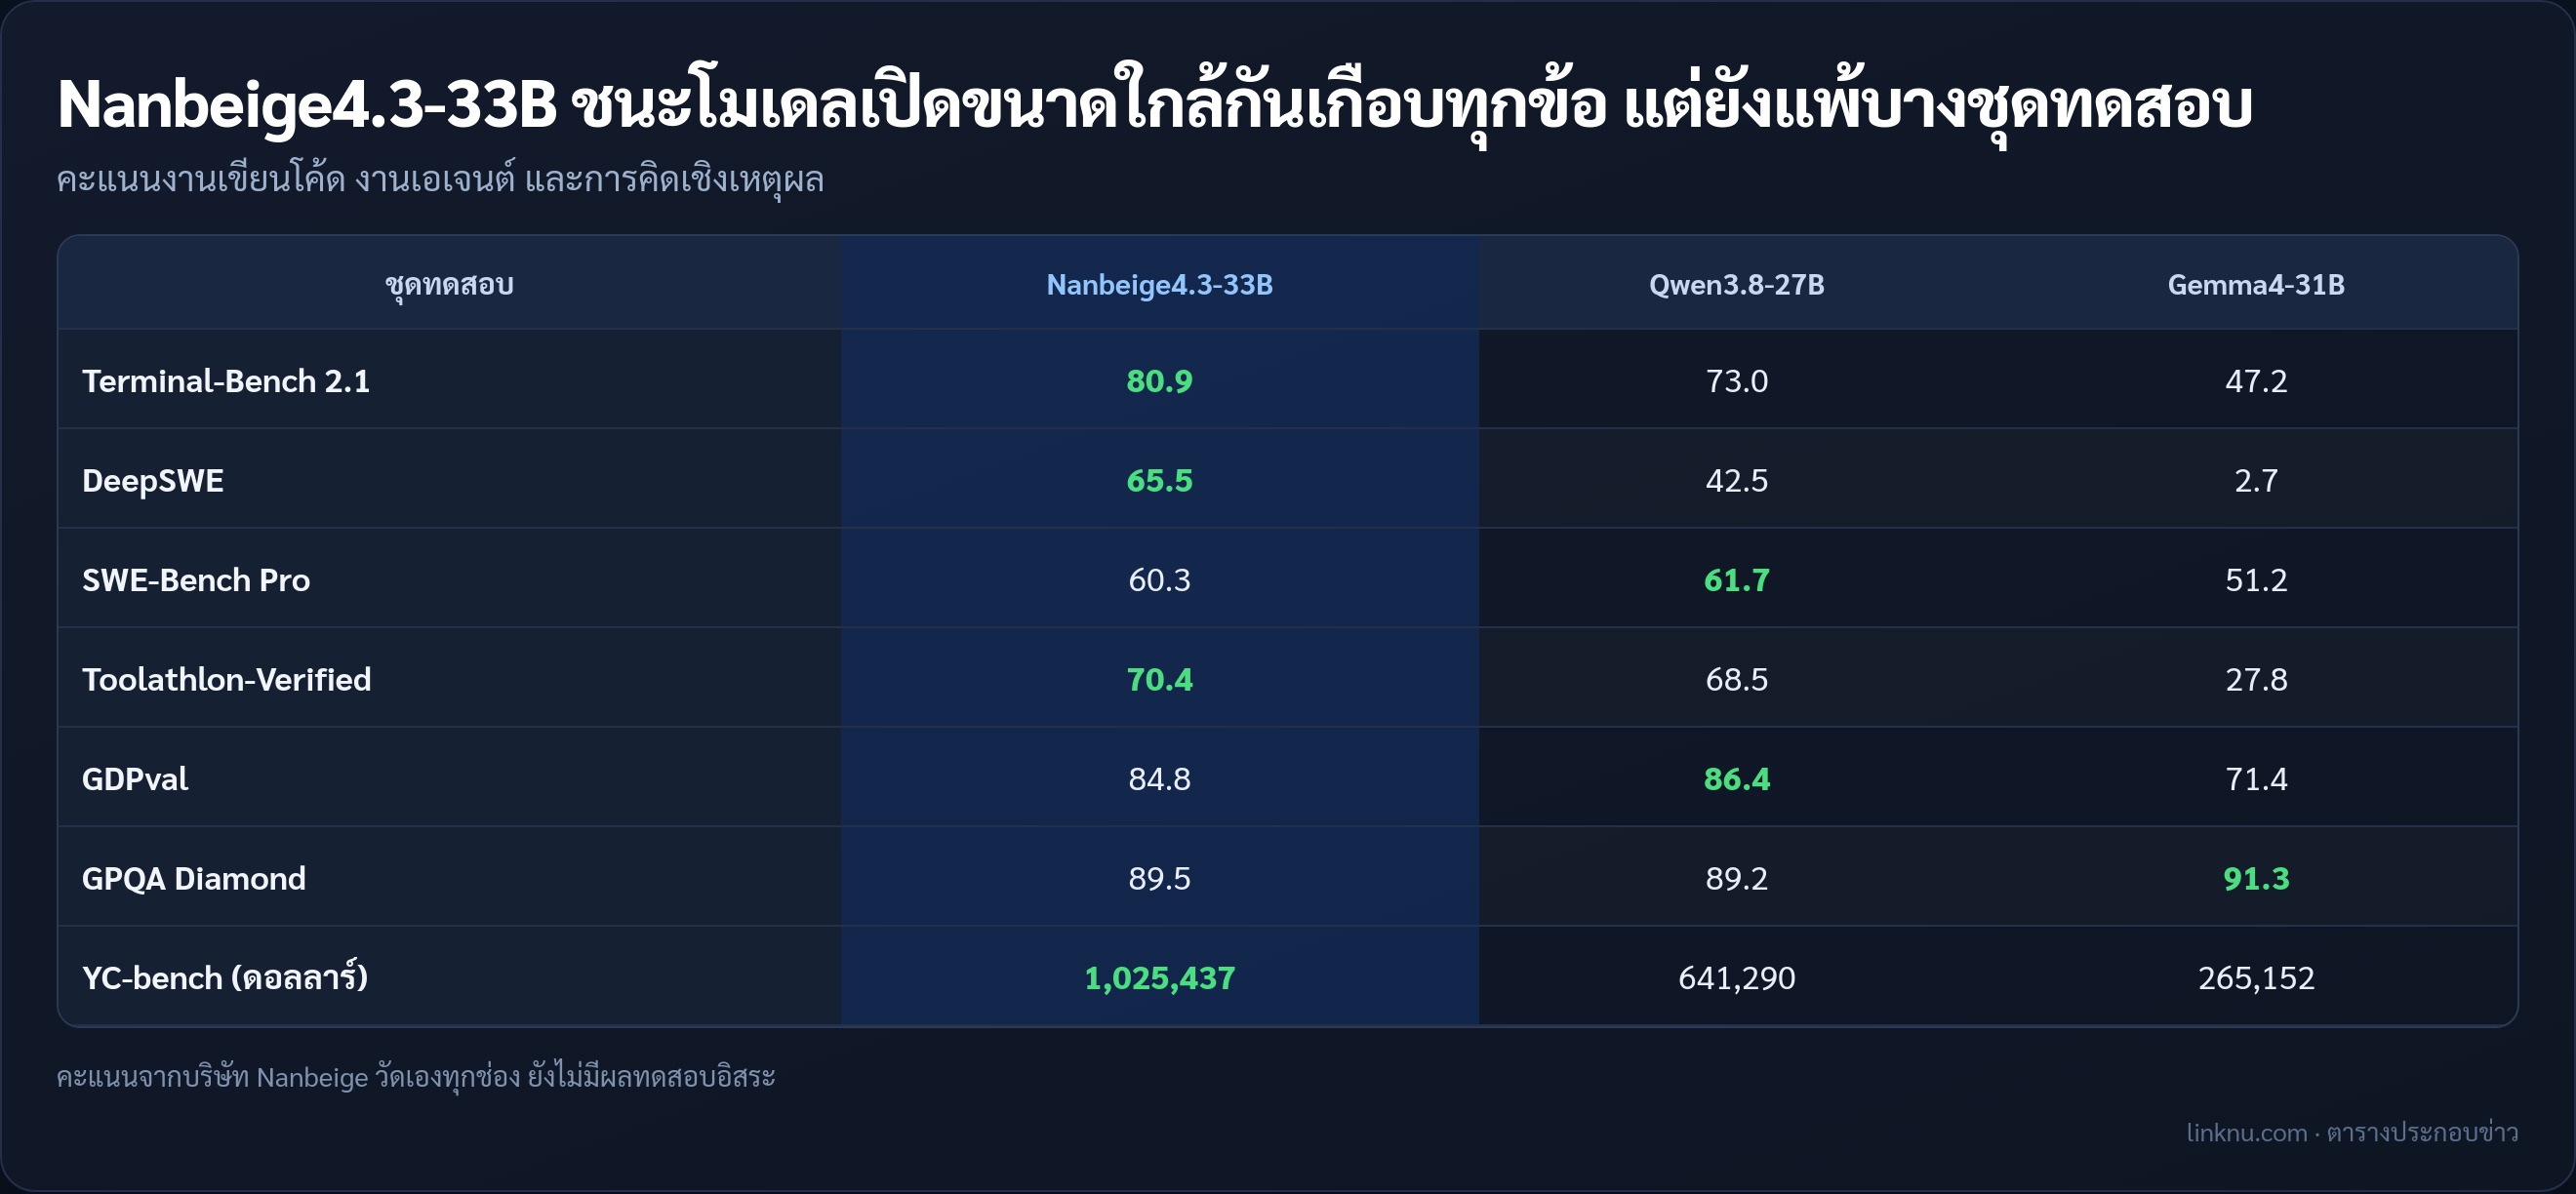
- บริษัทเทียบกับ Qwen3.8-27B, Gemma4-31B และ Muse-Glimmer-30B
- ชุดทดสอบงานบนเทอร์มินัล Terminal-Bench 2.1 ได้ 80.9 คะแนน ส่วน Qwen3.8-27B ได้ 73.0
- งานจำลองบริหารบริษัท YC-bench ทำเงินได้ราว 1.03 ล้านดอลลาร์ ส่วนรุ่นของ Qwen ได้ราว 6.4 แสนดอลลาร์
- ยังแพ้ Qwen อยู่บางข้อ เช่น SWE-Bench Pro ได้ 60.3 ต่อ 61.7
- ทุกตัวเลขเป็นผลที่บริษัทวัดเอง ยังไม่มีผลจากกระดานทดสอบอิสระ
ทำไมต้องสนใจ
- บริษัทวางรุ่นนี้เป็นโมเดลครู ไว้กลั่นความสามารถลงไปสอนรุ่นเล็กต่อ
- รุ่นเล็กที่บอกว่าจะตามมาคือ Nanbeige4.3-3B
- ภายในไม่กี่ชั่วโมงหลังปล่อย มีคนเข้ามาขอรุ่นบีบอัดให้เล็กลงเพื่อรันในเครื่องสเปกต่ำกว่าเดิมแล้ว
ใช้ได้ยังไง
- โหลดมาลงเครื่องตัวเองได้ฟรีที่ฮักกิ้งเฟซ
- รันผ่านเครื่องมือยอดนิยมอย่าง Transformers, SGLang และ vLLM ได้
- ตัวอย่างในหน้าโมเดลใช้การ์ดจอ 4 ใบ
- หน้าโมเดลยังไม่พูดถึงบริการเรียกใช้แบบจ่ายเงิน
สรุป
ถ้าตัวเลขที่บริษัทเคลมยืนได้ในการทดสอบอิสระ คนที่อยากได้เอเจนต์เขียนโค้ดที่รันในเครื่องตัวเองจะมีตัวเลือกขนาดกลางเพิ่มอีกตัว และน่ารอดูว่ารุ่นเล็กที่กลั่นจากตัวนี้จะเก่งแค่ไหน
แหล่ง: Nanbeige บนฮักกิ้งเฟซ · 25 ต.ค. 2026