Carbon-X คืออะไร
- เป็นโมเดลภาษาขนาด 14.8B ที่ฝึกทั้งลำดับดีเอ็นเอและข้อความภาษาคนไปพร้อมกัน
- ต่อยอดมาจาก Qwen3-14B ของอาลีบาบา แล้วฝึกเพิ่มอีก 302B โทเคน
- เป็นงานร่วมของ Hugging Face กับสถาบันวิจัยจงกวนชุนของจีน และสถาบัน TIGEM กับมหาวิทยาลัยเนเปิลส์ของอิตาลี
- ปล่อยบนหน้า HuggingFaceBio เมื่อ 22 ต.ค. 2026 สัญญาอนุญาต Apache 2.0 ใช้เชิงพาณิชย์ได้
ใช้ทำอะไรได้
- แปะดีเอ็นเอลงไปในแชตตรง ๆ แล้วถามเป็นภาษาอังกฤษ โมเดลตอบพร้อมอธิบายเหตุผล
- ทายว่าการกลายพันธุ์จุดหนึ่งไม่มีพิษภัย หรือมีแนวโน้มก่อโรค
- ชี้ว่าช่วงไหนของลำดับทำหน้าที่คุมการทำงานของยีน
- บอกได้ว่าลำดับนั้นมาจากสิ่งมีชีวิตกลุ่มไหน และเดาเบสตัวถัดไปได้
- เอาไปต่อเป็นเครื่องมือให้เอเจนต์ AI เรียกใช้ได้ ทีมแจกตัวอย่างไว้ให้แล้ว
เก่งแค่ไหน
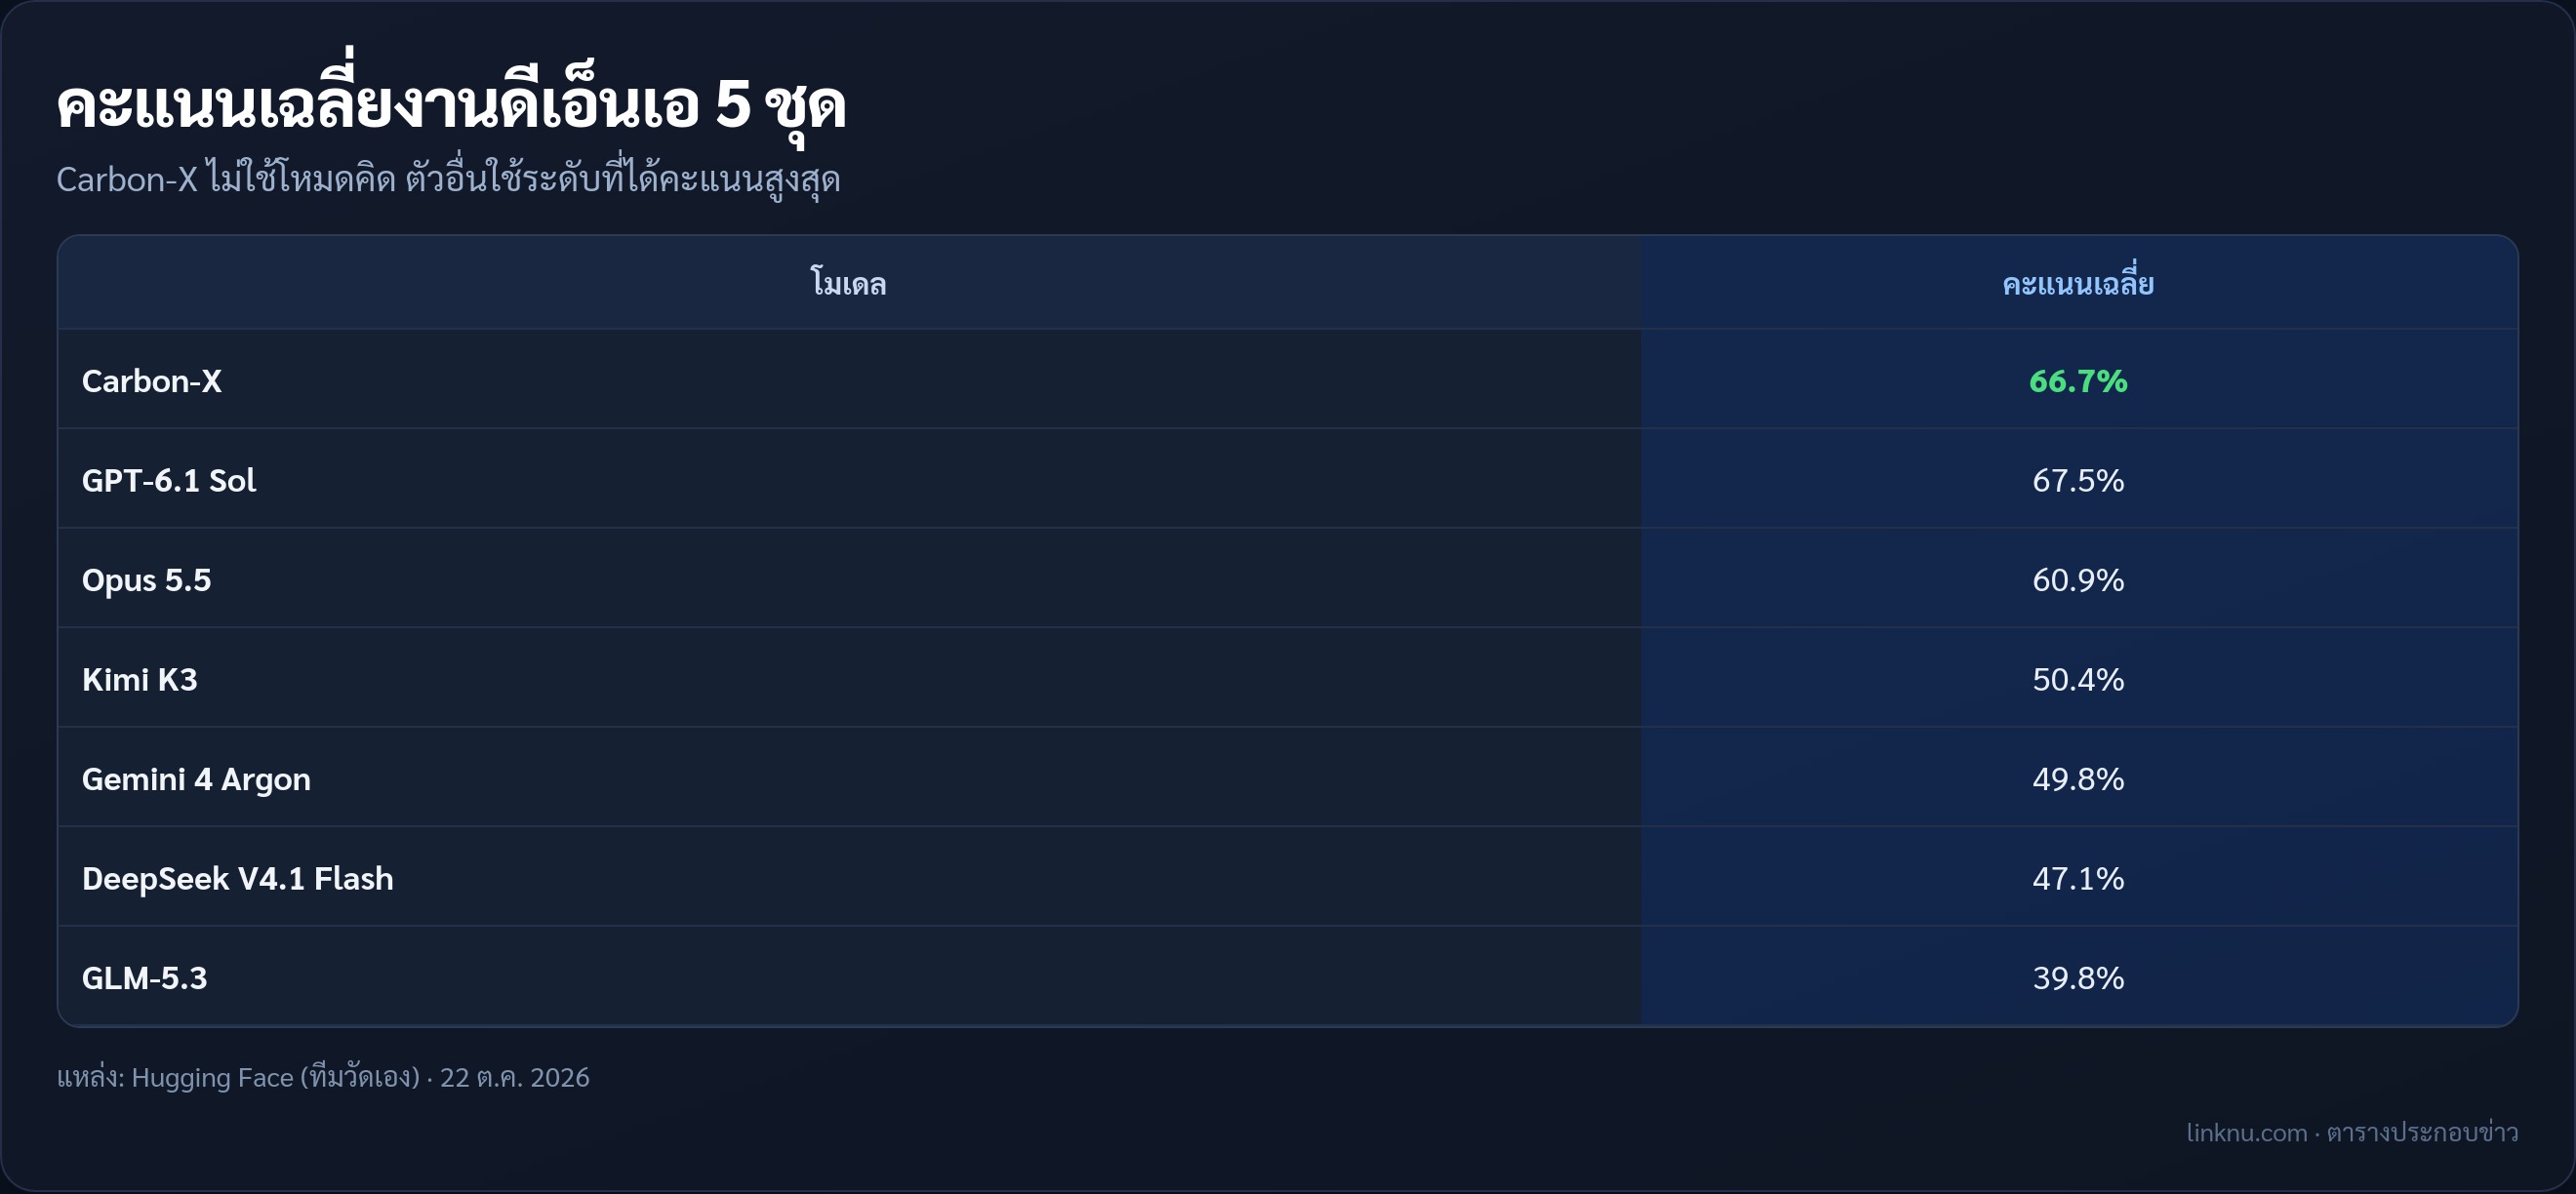
- คะแนนเฉลี่ยห้าชุดทดสอบด้านดีเอ็นเอได้ 66.7% สูงกว่า Qwen3-14B ตัวตั้งต้นราว 27 คะแนน
- ใกล้ GPT-6.1 Sol ที่ได้ 67.5% แต่ค่ารันต่อโจทย์ถูกกว่าราว 1,800 เท่า
- นำ Opus 5.5 ที่ได้ 60.9% และนำโมเดลเปิดทุกตัวที่ทีมเอามาเทียบ
- ทีมประเมินว่าถ้าไล่ดูการกลายพันธุ์ที่ยังไม่รู้ผล 2.4 ล้านจุดในฐานข้อมูล ClinVar จะใช้เงินราว 300 ดอลลาร์ เทียบกับโมเดลชั้นนำที่ต้องจ่าย 32,000 ถึง 4 ล้านดอลลาร์
ใช้งานยังไง
- โหลดจาก Hugging Face ได้เลย ใช้การ์ดจอหน่วยความจำ 80 กิกะไบต์แค่ใบเดียวก็รันได้
- ข้อมูลพันธุกรรมเป็นเรื่องอ่อนไหว การรันบนเครื่องตัวเองช่วยให้ข้อมูลไม่ต้องออกไปข้างนอก
- จำบริบทได้ราว 40,000 โทเคน
ข้อควรรู้
- ทีมย้ำว่ายังไม่ผ่านการรับรองทางคลินิก ห้ามเอาไปใช้ตัดสินเรื่องการรักษา
- เน้นอ่านและอธิบายลำดับที่มีอยู่แล้ว ไม่ได้ฝึกมาให้ออกแบบลำดับใหม่
- บางงานยังอ่อน เช่น หาจุดตัดต่อยีนได้แค่ราว 30%
- คะแนนทั้งหมดทีมวัดเอง ยังไม่มีผลจากคนนอก และตอบเป็นภาษาอังกฤษเป็นหลัก
สรุป
Carbon-X เป็นตัวอย่างว่าโมเดลขนาดกลางที่ฝึกเฉพาะทางดี ๆ สู้โมเดลยักษ์ได้ในงานแคบ ๆ ด้วยต้นทุนที่ต่างกันเป็นพันเท่า นักวิจัยพันธุกรรมที่มีการ์ดจอใหญ่สักใบลองได้เลย
แหล่ง: หน้าโมเดล HuggingFaceBio/Carbon-X บน Hugging Face · WIRED · 22 ต.ค. 2026