Sage-A1.5 คืออะไร
- เป็นโมเดลแบบรวมผู้เชี่ยวชาญ (MoE) ขนาดรวม 35B แต่ละคำเรียกใช้แค่ราว 3B เลยเบาและเร็ว
- ต่อยอดจาก Qwen3.6-35B-A3B และ Agents-A1 รุ่นก่อนของแล็บเอง ซึ่ง A1 กับรุ่นที่คนเอาไปปรับต่อมียอดโหลดรวมเกินล้านครั้งแล้ว
- ดูรูปได้ด้วย ไม่ได้รับแค่ข้อความ
- จำบริบทได้ยาว 256K โทเคน และขยายเป็น 512K ได้ถ้าตั้งค่าเพิ่ม
- เรียกใช้เครื่องมือได้ในตัว เช่น ค้นเว็บ รันโค้ด หรือต่อกับ API อื่น ๆ
- แล็บเปิดตัวเมื่อ 21 ต.ค. 2026
เด่นตรงไหน
- แตกงานให้ลูกทีม : เจองานใหญ่ก็แบ่งเป็นงานย่อย ส่งให้เอเจนต์ย่อยหลายตัวทำพร้อมกัน แต่ละตัวมีบริบทของตัวเอง ไม่ตีกัน แล้วค่อยเอาผลมารวม
- โหมดตรวจทานตัวเอง : ระหว่างคิด โมเดลจะหยุดทบทวนว่าอะไรได้ผลแล้ว อะไรพลาด แล้วเปลี่ยนทางในรอบเดียวกัน ไม่ต้องมีตัวตรวจจากข้างนอก
- งานวิจัยแบบปลายเปิด : ไม่ได้แค่ตอบคำถามที่มีคำตอบตายตัว แต่ลองสำรวจ ตั้งสมมติฐาน แล้วเก็บผลงานไว้ให้คนตรวจย้อนได้
- ทั้งสองโหมดแรกปิดไว้เป็นค่าเริ่มต้น ต้องเปิดเองตอนเรียกใช้
คะแนนเป็นยังไง
- แล็บเทียบกับโมเดลตัวใหญ่กว่าอย่าง Kimi-K3, GLM-5.3 และ GPT-5.6-sol
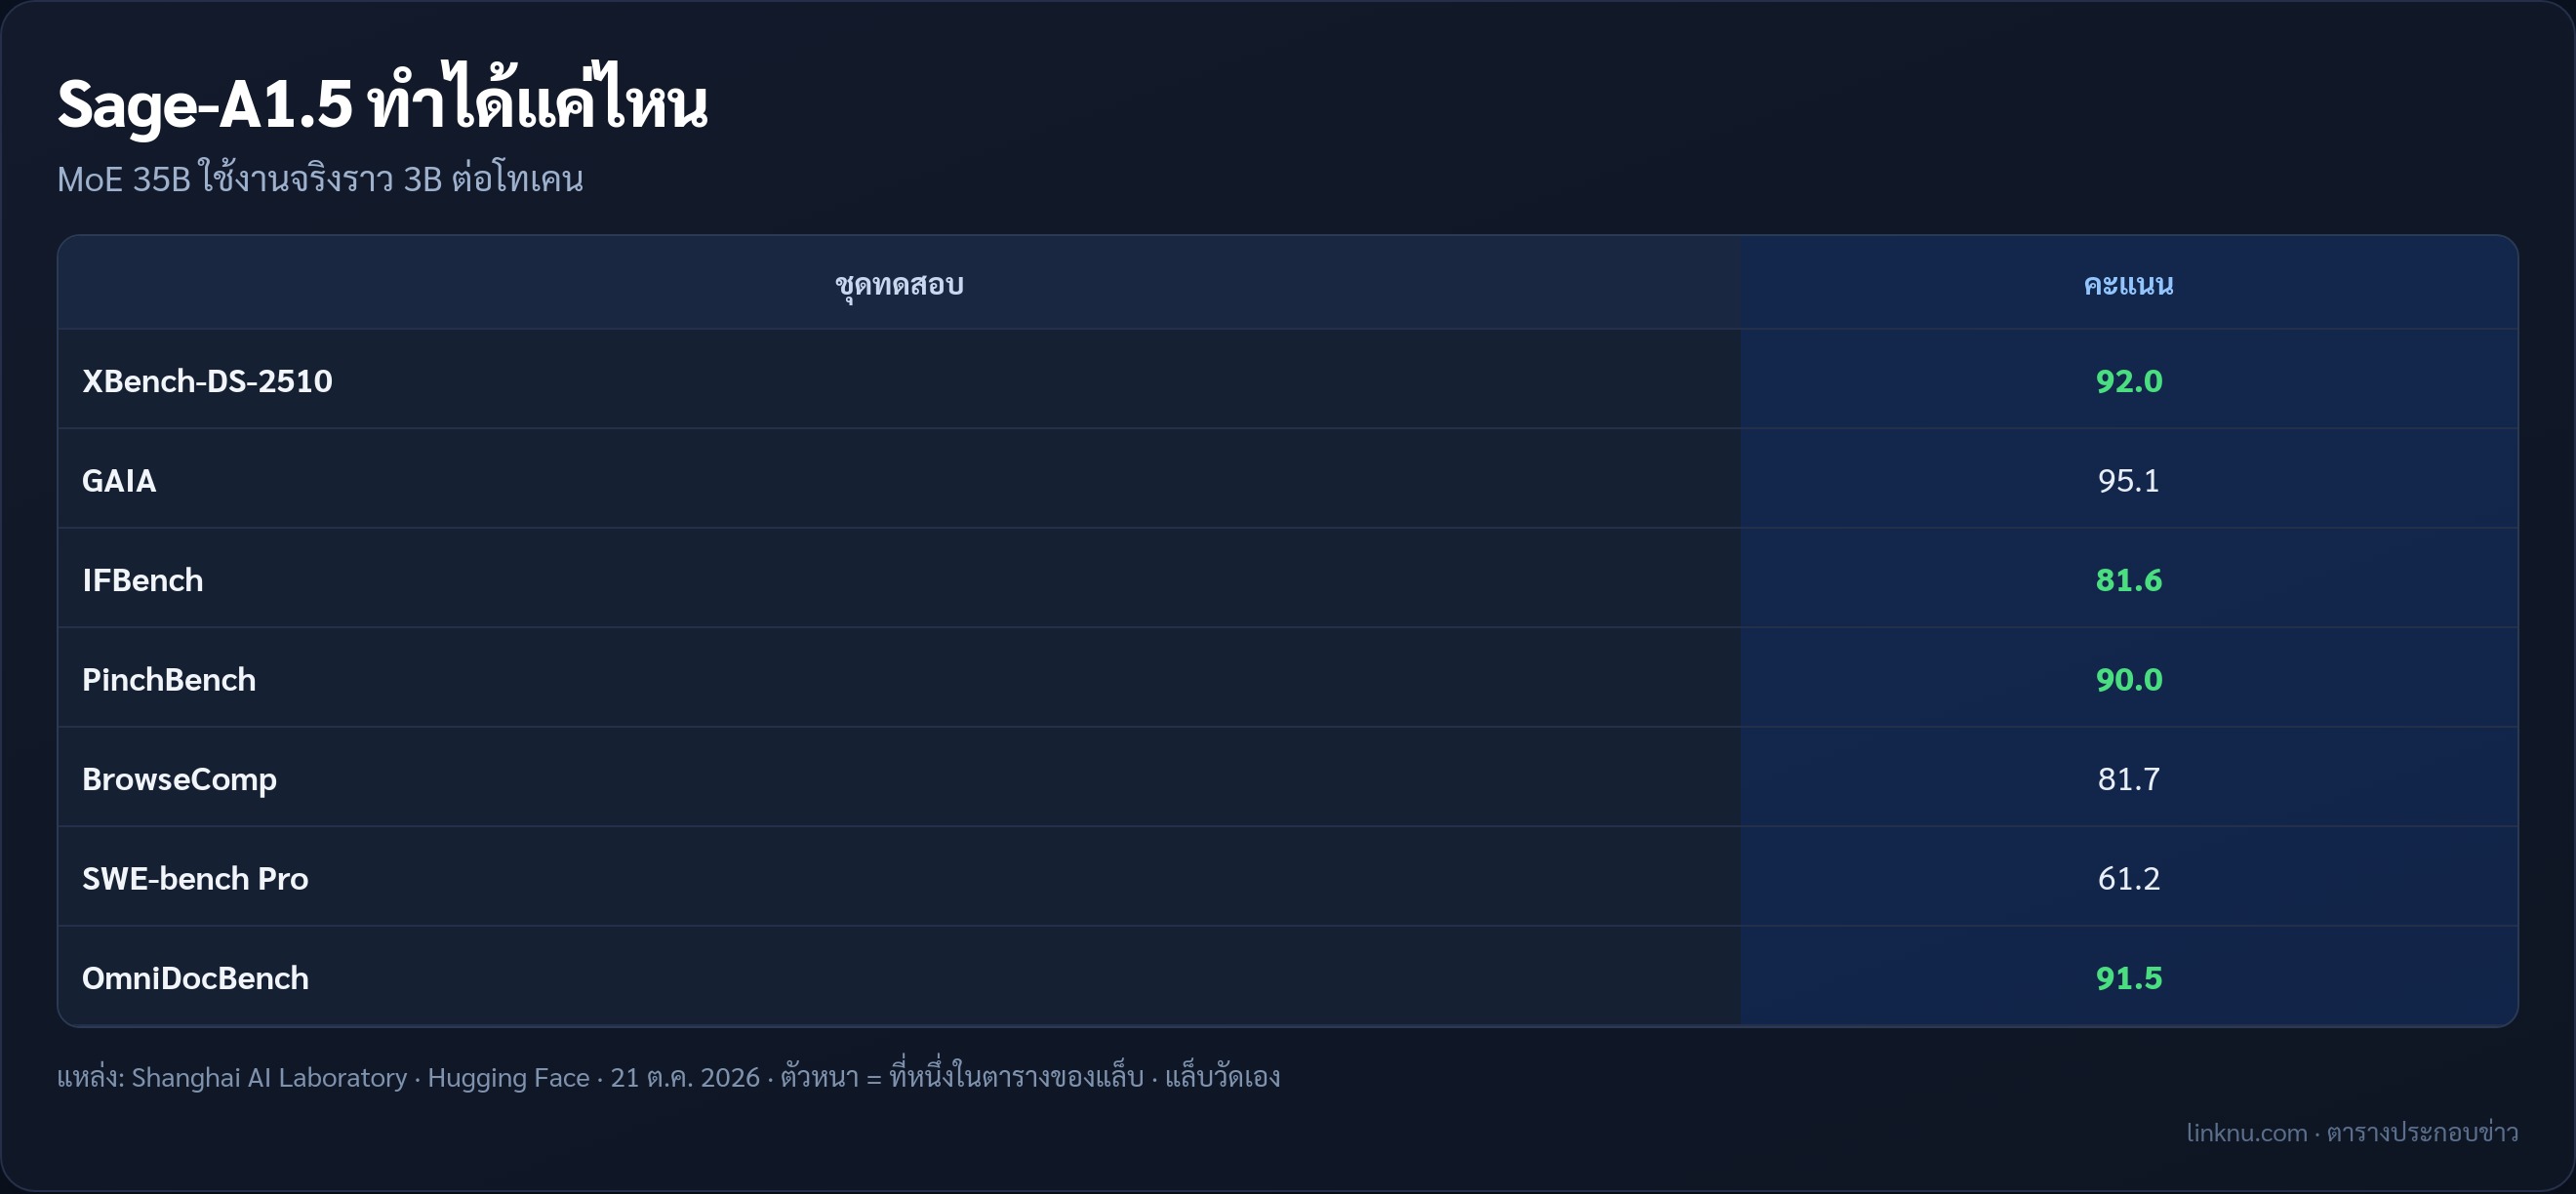
- ชุดทดสอบที่ Sage-A1.5 ได้ที่หนึ่งในตารางของแล็บ มีทั้งงานค้นข้อมูลยาว ๆ อย่าง XBench-DS-2510 ได้ 92.0
- งานทำตามคำสั่งหลายเงื่อนไขบน IFBench ได้ 81.6
- งานเอเจนต์ทั่วไปบน PinchBench ได้ 90.0
- งานอ่านเอกสารบน OmniDocBench ได้ 91.5 และชุด CMT ได้ 80.0
- ชุดทดสอบงานวิทยาศาสตร์ FrontierScience ได้ 81.0 ในรอบโอลิมปิก และ 48.3 ในรอบงานวิจัย ซึ่งสูงกว่าทุกตัวที่เอามาเทียบ
- GAIA ได้ 95.1 สูงกว่าโมเดลตัวใหญ่ทุกตัวในตาราง
- ถ้าเทียบกับโมเดลขนาดราว 35B ด้วยกัน งานค้นเว็บบน BrowseComp ได้ 81.7 นำกลุ่ม
- งานแก้โค้ดจริงบน SWE-bench Pro ได้ 61.2 ส่วนงานแมชชีนเลิร์นนิงบน MLE-Lite ได้ 65.2
- ข้อสอบยากชุด HLE แบบให้ใช้เครื่องมือได้ ทำได้ 55.1
- เทียบกับ A1 รุ่นก่อน งานแก้โค้ดบน SWE-bench Pro ขึ้น 17.6 แต้ม และชุดแก้โค้ดหลายภาษาขึ้น 14.0 แต้ม
- งานเอเจนต์บน PinchBench ขึ้น 13.1 แต้ม ส่วนงานแมชชีนเลิร์นนิงบน MLE-Lite ขึ้นถึง 21.3 แต้ม
- ตัวเลขทั้งหมดนี้แล็บวัดเองและรายงานเอง
ใช้งานยังไง
- โหลดไฟล์โมเดลได้ทั้งจาก Hugging Face และ ModelScope สัญญาอนุญาต Apache 2.0 เอาไปใช้ทำธุรกิจได้
- ใช้กับ Transformers ได้ และรันผ่าน vLLM หรือ SGLang ก็ได้
- ไฟล์ย่อขนาดแบบ 4 บิตที่ชุมชน MLX ทำไว้กินหน่วยความจำราว 21GB เครื่อง Mac หน่วยความจำเยอะ ๆ ก็โหลดมาใช้เองได้
- ถ้ายังไม่อยากโหลด ลองฟรีบนเว็บ discovery.intern-ai.org.cn ได้
- รายงานเทคนิคอยู่บน arXiv เลข 2610.28578
ข้อควรรู้
- ยังไม่มีผลทดสอบจากคนนอกมายืนยันคะแนน
- งานเขียนโค้ดยาก ๆ และการค้นเว็บบางชุด โมเดลตัวใหญ่ในตารางยังทำได้ดีกว่า
- โหมดแตกงานต้องเขียนระบบฝั่งเราเองให้รันเอเจนต์ย่อยและส่งผลกลับ
สรุป
Sage-A1.5 เป็นอีกตัวที่โชว์ว่าโมเดลขนาดกลางที่ใช้งานจริงแค่ 3B ก็ทำงานเอเจนต์หลายขั้นได้ไม่น้อยหน้าตัวใหญ่ ใครทำระบบผู้ช่วยวิจัยหรืออยากได้เอเจนต์ที่รันบนเครื่องตัวเอง ตัวนี้น่าลองมาก
แหล่ง: Shanghai AI Laboratory (หน้า Hugging Face InternScience/Sage-A1.5 และประกาศบน ModelScope) · 21 ต.ค. 2026