มีอะไรมาบ้าง
- งานนี้มาจาก SeerRay-Lab ทีมของ Xiaomi ขึ้นโมเดลบน Hugging Face ตั้งแต่ 19 ต.ค. ส่วนรายงานเทคนิคขึ้น arXiv ไปก่อนแล้วเมื่อ 16 ต.ค. และ Pandaily ลงข่าวบ่ายวันที่ 21 ต.ค. ตามเวลาไทย
- ตัวโมเดลต่อยอดจาก Qwen3.5-4B ของ Alibaba แล้วเติมตัวถอดหน้ากากภาพขนาดเล็กเข้าไป ฝึกให้ทั้งตอบเป็นข้อความและวาดขอบเขตวัตถุไปพร้อมกัน
- เวลาโมเดลพูดถึงของชิ้นไหน มันจะปล่อยโทเคนพิเศษหนึ่งตัวออกมา แล้วโทเคนนั้นถูกแปลงเป็นหน้ากากระบายสีทับวัตถุในรูป พร้อมกรอบสี่เหลี่ยมบอกตำแหน่ง
- จุดที่ต่างจากหลายตัวคือมันชี้ระหว่างคิดได้ด้วย เช่นถามว่ามีกี่ชิ้น โมเดลจะชี้ทีละชิ้นที่นับไปก่อนตอบ
- งานที่ทำได้มี 6 กลุ่ม คือ หาของตามคำบรรยาย ระบายขอบวัตถุตามคำบรรยาย หาของหลายชิ้นพร้อมกัน ตอบคำถามที่ต้องคิดก่อนว่าหมายถึงอะไร รับคำสั่งแบบหุ่นยนต์ เช่น หยิบแก้วขาวทางซ้ายให้หน่อย และงานดูรายละเอียด เช่น นับของหรือบอกสี
- แถมชุดทดสอบใหม่ชื่อ LensBench มี 4,800 คำสั่ง ครอบคลุมภาพทั่วไป ภาพถ่ายทางอากาศ ภาพจากรถ และภาพพาโนรามา
เก่งแค่ไหน
- คะแนนทั้งหมดมาจากทีม Xiaomi วัดเอง ยังไม่มีคนนอกทดสอบซ้ำ
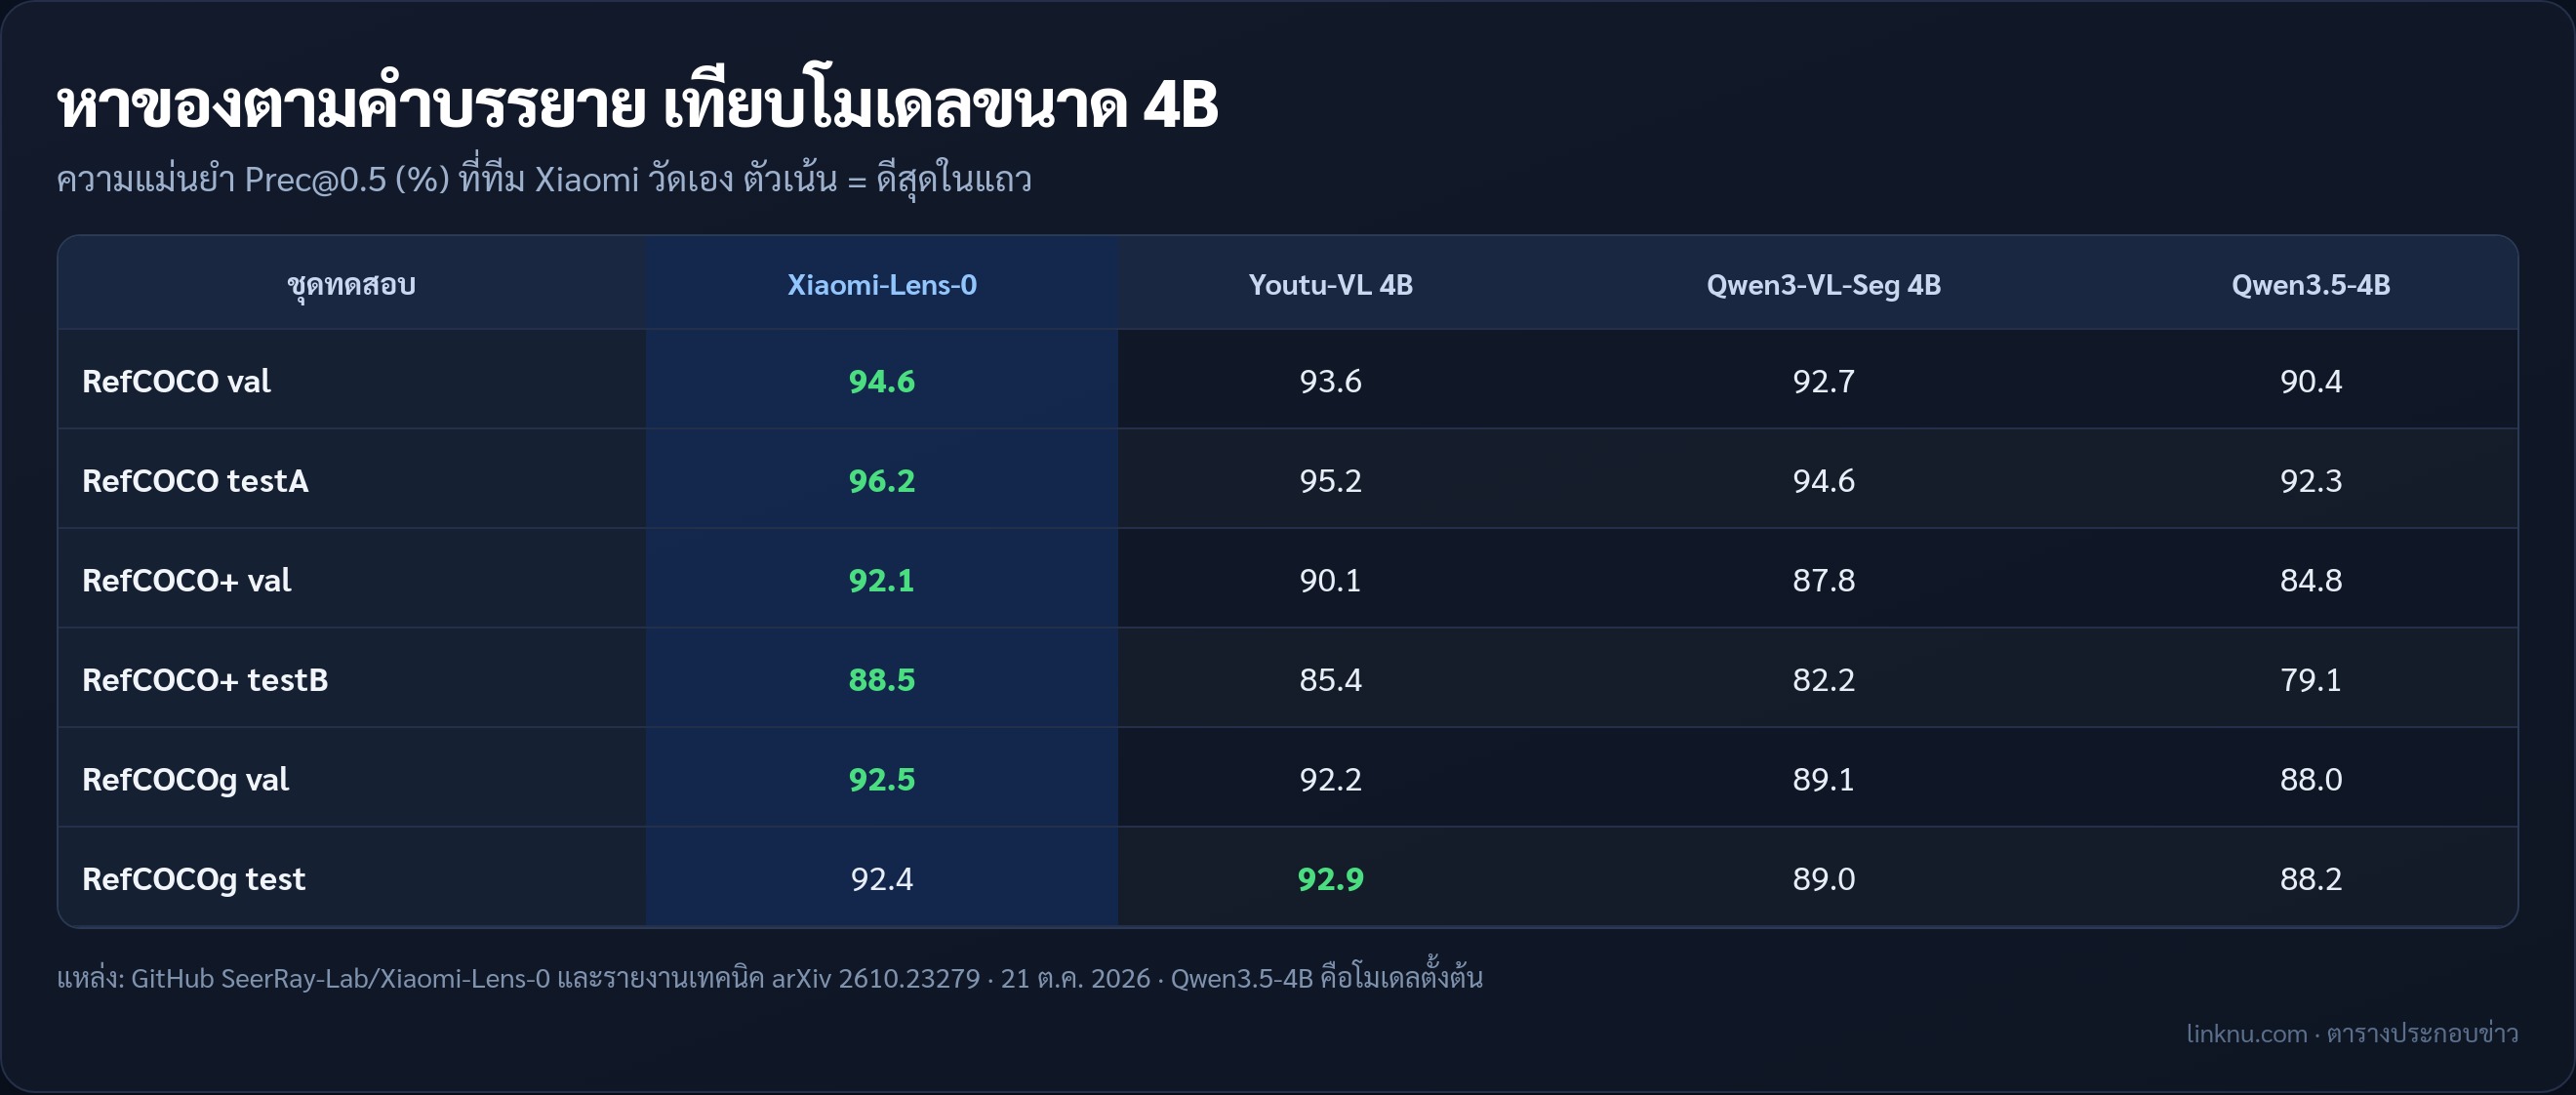
- งานหาของตามคำบรรยายในชุด RefCOCO ทั้ง 8 ชุดย่อย ชนะ 7 ชุด เฉลี่ยดีกว่าตัวตั้งต้น Qwen3.5-4B ราว 5.6 คะแนน แพ้ Youtu-VL 4B ชุดเดียวแบบหวุดหวิด
- งานระบายขอบวัตถุตามคำบรรยาย ได้ที่ 1 ครบทั้ง 8 ชุด
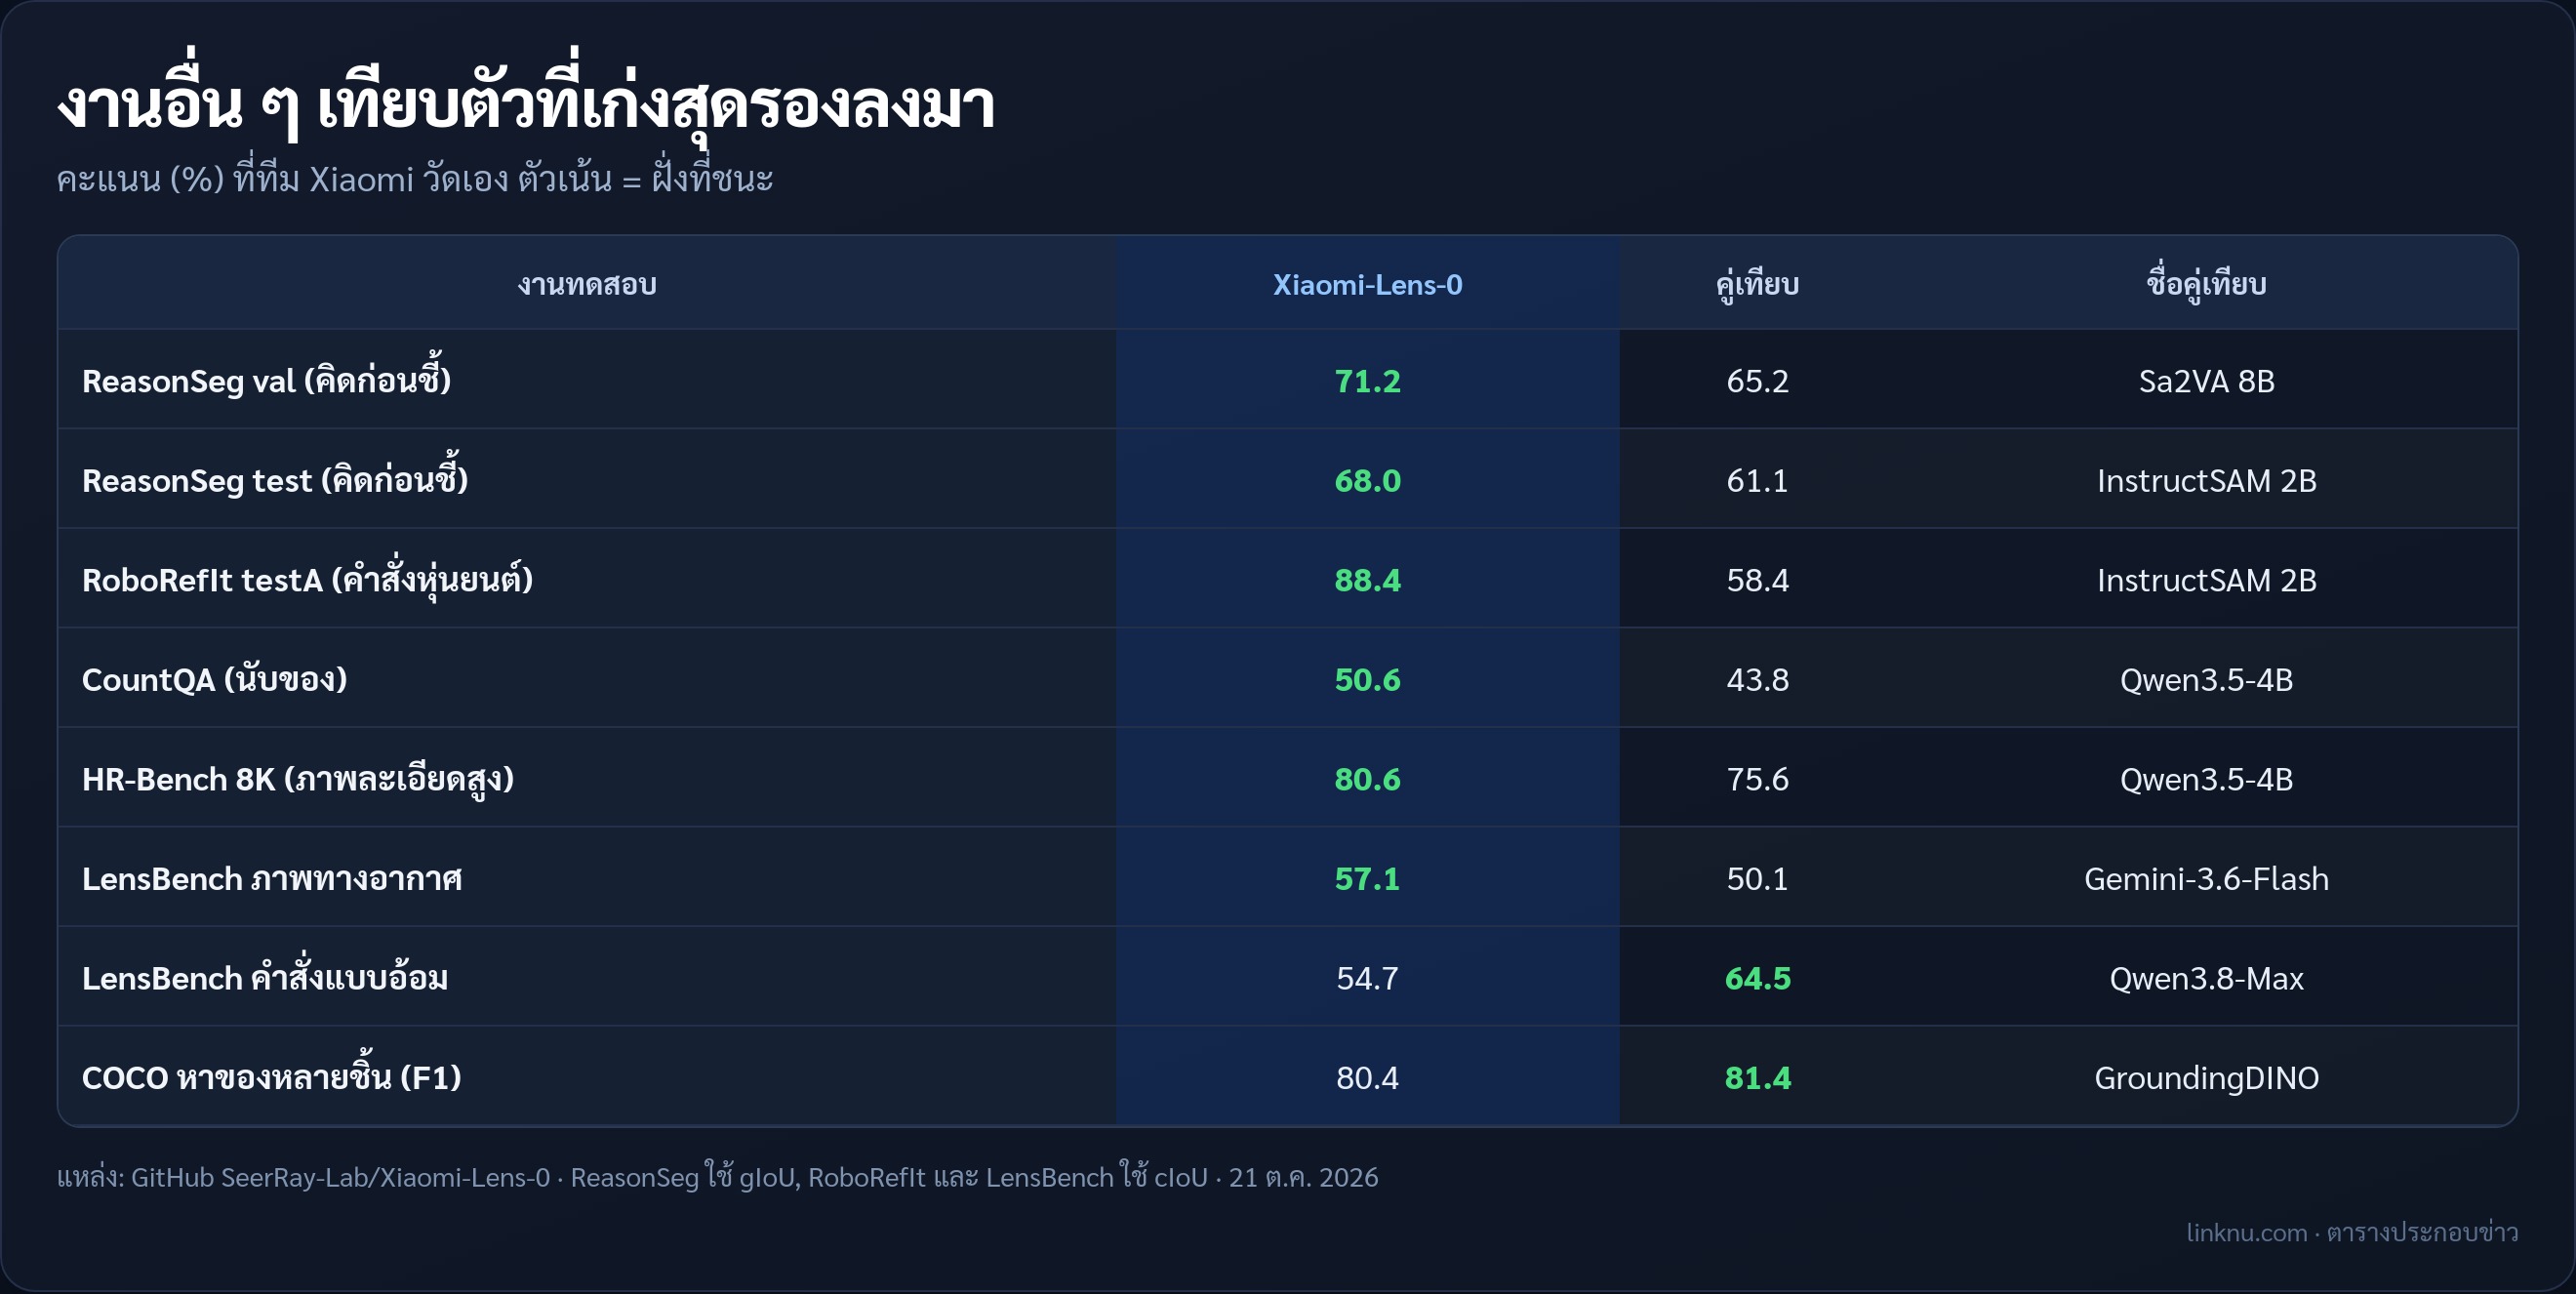
- งานที่ต้องคิดก่อนชี้ ReasonSeg ได้ 71.2 ทิ้งตัวที่ดีรองลงมาราว 6 คะแนน
- งานรับคำสั่งแบบหุ่นยนต์ RoboRefIt ห่างคู่เทียบมาก ได้ 88.4 จากที่ตัวอื่นทำได้สูงสุด 58.4
- งานนับของ CountQA ได้ 50.6 ดีขึ้นจากตัวตั้งต้น 6.8 คะแนน
- จุดที่ยังแพ้ คือคำสั่งแบบอ้อม ๆ ใน LensBench ที่ได้ 54.7 ต่ำกว่าโมเดลใหญ่อย่าง Qwen3.8-Max กับ GPT-5.6-Sol และงานหาของหลายชิ้นใน COCO ที่ยังตามหลัง GroundingDINO นิดหน่อย
โหลดมาใช้ยังไง
- น้ำหนักอยู่บน Hugging Face ที่ SeerRay-Lab/Xiaomi-Lens-0 ไม่ต้องกดขอสิทธิ์ ไฟล์รวมราว 9.2 GB
- ต้องลงโค้ดจาก GitHub ของทีมก่อนถึงจะโหลดโมเดลและถอดหน้ากากได้ ตอนนี้ต้องใช้การ์ดจอ NVIDIA ที่รองรับ bf16 กับ FlashAttention-2
- ใครทำเป็นบริการ มีสคริปต์รันผ่าน vLLM ให้ โดยแยกเครื่องตอบข้อความกับเครื่องถอดหน้ากากเป็นสองตัว
- ไม่อยากลงอะไรเลย ลองเล่นได้ที่หน้าเดโมบน Hugging Face Spaces แค่อัปโหลดรูปแล้วพิมพ์ว่าอยากให้ชี้อะไร
ข้อควรรู้
- ใช้สัญญาอนุญาต Apache 2.0 ทั้งตัว Xiaomi-Lens-0 และ Qwen3.5-4B ที่เป็นฐาน เอาไปใช้เชิงพาณิชย์ได้
- ทีมเตือนเองว่าโมเดลยังพลาดได้ โดยเฉพาะของชิ้นเล็ก ของที่ถูกบัง หรือคำสั่งที่กำกวม
- โค้ดที่ให้มาตอนนี้รองรับเฉพาะภาพนิ่ง และยังไม่มีผลทดสอบกับคำสั่งภาษาไทย
สรุป
Xiaomi-Lens-0 น่าสนใจสำหรับคนทำหุ่นยนต์ กล้องตรวจของ หรือแอปที่ต้องรู้ว่าวัตถุอยู่ตรงไหนในภาพ เพราะตัวเล็กแค่ 4B แต่ชี้และระบายขอบได้แม่นในหลายชุดทดสอบ ข้อจำกัดคือคะแนนยังเป็นของทีมวัดเอง และต้องใช้การ์ดจอ NVIDIA ถึงจะรันได้
แหล่ง: Xiaomi SeerRay-Lab (หน้าโมเดล Hugging Face, GitHub, หน้าโปรเจกต์, รายงานเทคนิค arXiv 2610.23279) · Pandaily · 21 ต.ค. 2026