EAGLE-4 คืออะไร
- Eagle โพสต์เปิดตัวบน X เมื่อ 04:42 น. วันที่ 21 ต.ค. เวลาไทย พร้อมโค้ดบน GitHub เอกสารวิจัย และตัวโมเดลบน Hugging Face
- หลักการคือมีโมเดลตัวเล็กคอยเดาคำถัดไปล่วงหน้าทีละหลายคำ แล้วให้โมเดลตัวหลักตรวจรวดเดียว คำไหนไม่ตรงก็ทิ้ง ผลที่ได้เลยเหมือนให้โมเดลหลักตอบเองทุกคำ แค่เร็วกว่า เทคนิคนี้เรียกว่า speculative decoding
- จุดที่ต่างจากรุ่นก่อนคือใช้ตัวเดาตัวเดียวได้ทุกสถานการณ์ ระบบจะวัดว่าเครื่องที่รันอยู่ทำงานช้าเร็วแค่ไหน แล้วปรับเองว่าควรเดากี่คำ ตามจำนวนคนที่ใช้พร้อมกัน ชนิดการ์ดจอ และลักษณะงาน
- คู่แข่งอย่าง DFlash 2 กับ DSpark ต้องตั้งจำนวนคำที่เดาไว้ล่วงหน้า พอคนใช้เยอะ ๆ เลยเดาเกินจนเปลืองแรงเครื่อง
- ตอนนี้มีตัวเดาให้ Qwen3.8-27B ซึ่งเป็นคู่ที่วัดผลครบที่สุด กับ Nemotron-3.5-Super-VL-120B-A12B บน Hugging Face
เร็วขึ้นแค่ไหน
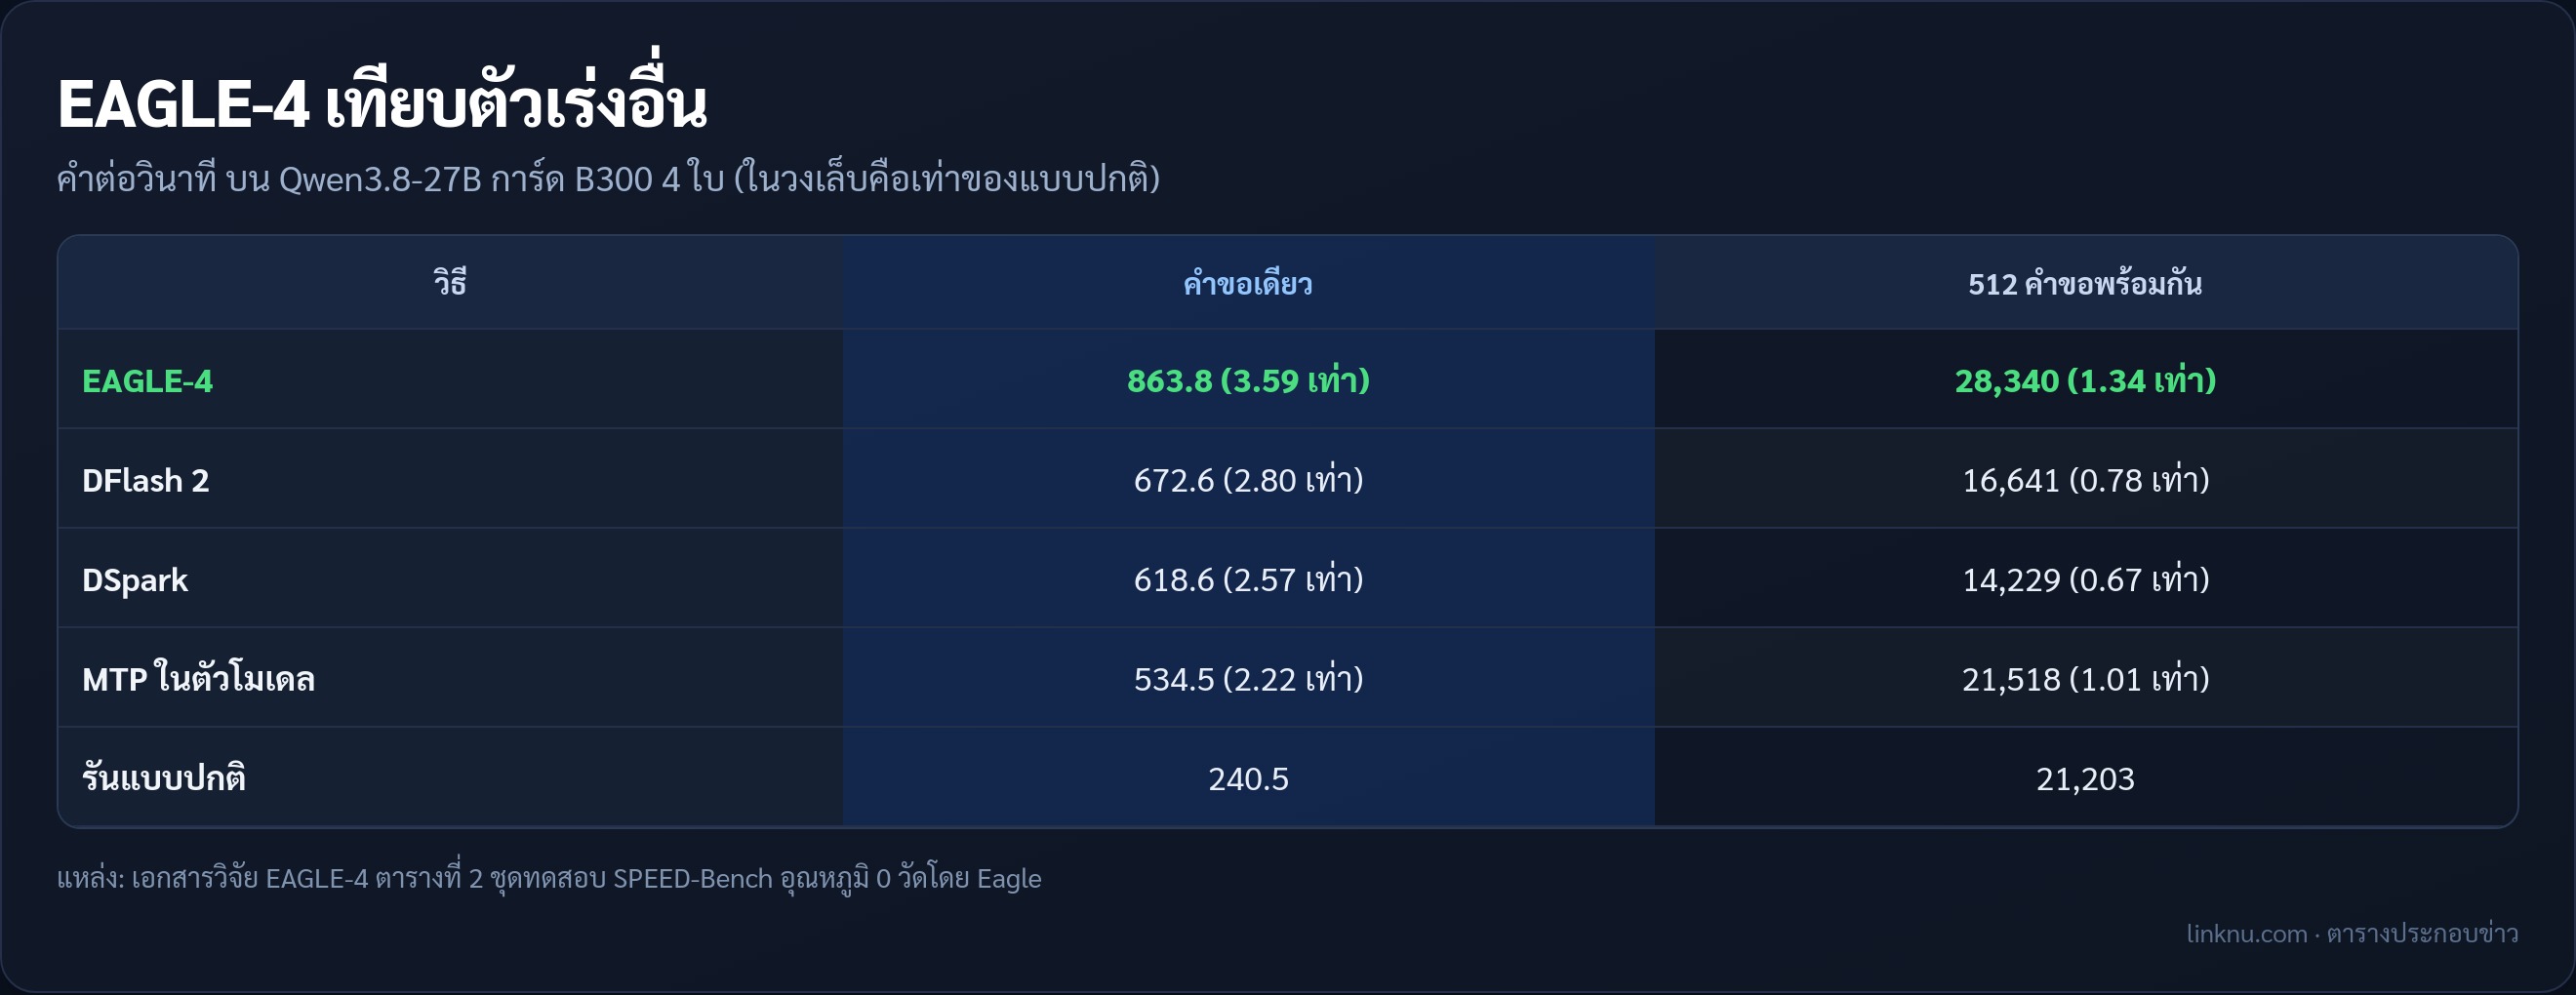
- ในเอกสารวิจัย Eagle วัดกับ Qwen3.8-27B บนการ์ด NVIDIA B300 4 ใบ ถ้ามีคำขอเข้ามาทีละคำขอ EAGLE-4 ทำได้ 863.8 คำต่อวินาที เร็วกว่าการรันแบบปกติ 3.59 เท่า และแซง DFlash 2 กับ DSpark
- ในโพสต์เปิดตัวบน X ใช้ตัวเลข 961.6 คำต่อวินาที หรือราว 4 เท่า บอกว่าวัดด้วยเอนจิน TokenSpeed ในสภาพเดียวกัน แต่เลขนี้ยังไม่อยู่ในเอกสารวิจัย และหน้า GitHub ยังเขียนไว้ว่ายังไม่เคลมความเร็วฝั่ง TokenSpeed
- พอมีคำขอเข้ามาพร้อมกัน 512 คำขอ EAGLE-4 ยังเร็วกว่าแบบปกติ 1.34 เท่า เท่ากับ 1.70 เท่าของ DFlash 2 และ 1.99 เท่าของ DSpark ส่วนสองตัวนั้นกลับช้ากว่าการรันแบบปกติไปแล้ว
- ตัวเลขที่ทีมวัดซ้ำตอนติดตั้งจริงบนหน้า GitHub ออกมาเบากว่าในเอกสารวิจัย เช่น บน vLLM คำขอเดียวเร็วขึ้น 2.99 เท่า และบน SGLang ตอนมีคำขอพร้อมกัน 64 คำขอเร็วขึ้น 1.35 เท่า
- นอกจากการ์ดจอ ยังลองบนมือถือ Motorola Razr 70 Ultra ที่รัน Gemma-4-E2B-it แบบย่อขนาดด้วยซีพียูล้วน ได้เร็วขึ้น 3.62 เท่าบนชุดทดสอบเขียนโค้ด HumanEval
คนอื่นว่ายังไง
- GMI Cloud ผู้ให้บริการเช่าการ์ดจอ ลองบน B300 เองแล้วโพสต์ว่าได้ 703 คำต่อวินาที เร็วกว่าแบบปกติ 2.7 เท่า และได้ 27,600 คำต่อวินาทีบนเครื่อง B300 4 ใบชุดเดียวตอนมี 512 คำขอพร้อมกัน (เลขที่ GMI วัดเอง)
- ทีม AMD ทำให้ใช้บนการ์ด Instinct ได้ตั้งแต่วันแรก บน MI350X ใบเดียว คำขอเดียวได้ 262.89 คำต่อวินาที เทียบแบบปกติ 75.27 หรือ 3.49 เท่า
- ใช้กับ vLLM และ SGLang รุ่นที่ Eagle ปรับให้แล้ว ส่วน TokenSpeed ยังเป็นขั้นทดลอง fal กับ Fireworks ร่วมเปิดตัวช่วงแรก และ fal เขียนบทความเชิงเทคนิคอธิบายวิธีทำงานไว้
ข้อควรรู้ก่อนเอาไปใช้
- Eagle บอกเองว่าไม่ใช่โอเพนซอร์สตามนิยามมาตรฐาน แต่เป็นแบบเปิดให้ดูโค้ดและใช้ภายใต้เงื่อนไข
- ใช้หาเงินได้ถ้ารายได้รวมทั้งกลุ่มบริษัทไม่เกิน 20 ล้านดอลลาร์ใน 12 เดือน เกินจากนั้นต้องทำสัญญาแยก ถ้าเอาไปทำบริการที่แข่งกับ Eagle ต้องขอสิทธิ์แยกเสมอ ไม่ว่ารายได้เท่าไหร่
- ต้องใช้เอนจินรุ่นที่ Eagle ปรับแล้วเท่านั้น รุ่นมาตรฐานยังต่อไม่ได้ รับเฉพาะข้อความ และต้องใช้การ์ด NVIDIA รุ่น Ampere ขึ้นไปหรือ AMD ตระกูล CDNA2 ถึง CDNA4
- ตัวเลขความเร็วเกือบทั้งหมดเป็นของ Eagle และพาร์ตเนอร์วัดเอง ยังต้องรอคนนอกทดสอบเพิ่ม
สรุป
ใครเปิดบริการแชตบอตหรือเอเจนต์เขียนโค้ดบนโมเดลเปิดอยู่แล้ว EAGLE-4 น่าลองเพราะช่วยลดเวลารอได้จริงโดยไม่ต้องเปลี่ยนโมเดล แต่ต้องอ่านเงื่อนไขการใช้ให้ดี โดยเฉพาะบริษัทที่รายได้เกิน 20 ล้านดอลลาร์
แหล่ง: GitHub eagle-hq/EAGLE-4 และเอกสารวิจัย EAGLE-4 · โพสต์ X ของ Eagle, GMI Cloud, AMD และ fal · 21 ต.ค. 2026