เกิดอะไรขึ้น
- NVIDIA ลงโมเดลนี้ในบัญชีทางการบน Hugging Face ระบุวันเปิดตัว 16 ต.ค. 2026 และเริ่มมีคนเห็นราว 7 โมงเช้าวันที่ 17 ต.ค. ตามเวลาไทย
- ชื่อเต็มของโมเดลคือ Nemotron-Labs-Dory1.0-4B
- เป็นโมเดลจากสาย Nemotron Labs ซึ่งเป็นสายทดลองของ NVIDIA ไม่ใช่รุ่นหลักอย่าง Nemotron 3.5
- มีให้โหลด 4 แบบ ทั้งรุ่นความละเอียดเต็ม รุ่นบีบเหลือ 8 บิตและ 4 บิต และรุ่นสำหรับ llama.cpp ที่ไฟล์หนักราว 3.7GB
- ใช้ไลเซนส์ OpenMDW-1.1 เอาไปใช้เชิงพาณิชย์ได้
วนคิดซ้ำทำงานยังไง
- โมเดลแบ่งเป็น 3 ช่วง ชั้นขาเข้า 8 ชั้น ชั้นกลาง 20 ชั้น และชั้นขาออก 8 ชั้น
- ชั้นกลางชุดเดียวกันถูกเรียกซ้ำได้ 1 ถึง 4 รอบ และป้อนข้อความต้นฉบับกลับเข้าไปทุกรอบ
- คนใช้เลือกจำนวนรอบเองได้ตอนรัน ไม่ต้องเทรนใหม่หรือเปลี่ยนโมเดล NVIDIA แนะนำให้เริ่มที่ 2 รอบ
- การคิดเพิ่มเกิดอยู่ข้างใน โมเดลจึงพิมพ์คำตอบสั้นลงเพื่อแก้โจทย์เดิม
- มีโหมดเก็บแคชเฉพาะรอบสุดท้าย ทำให้วนกี่รอบก็ใช้หน่วยความจำแคชเท่าโมเดลที่ไม่วน
ผลทดสอบที่ NVIDIA วัดเอง
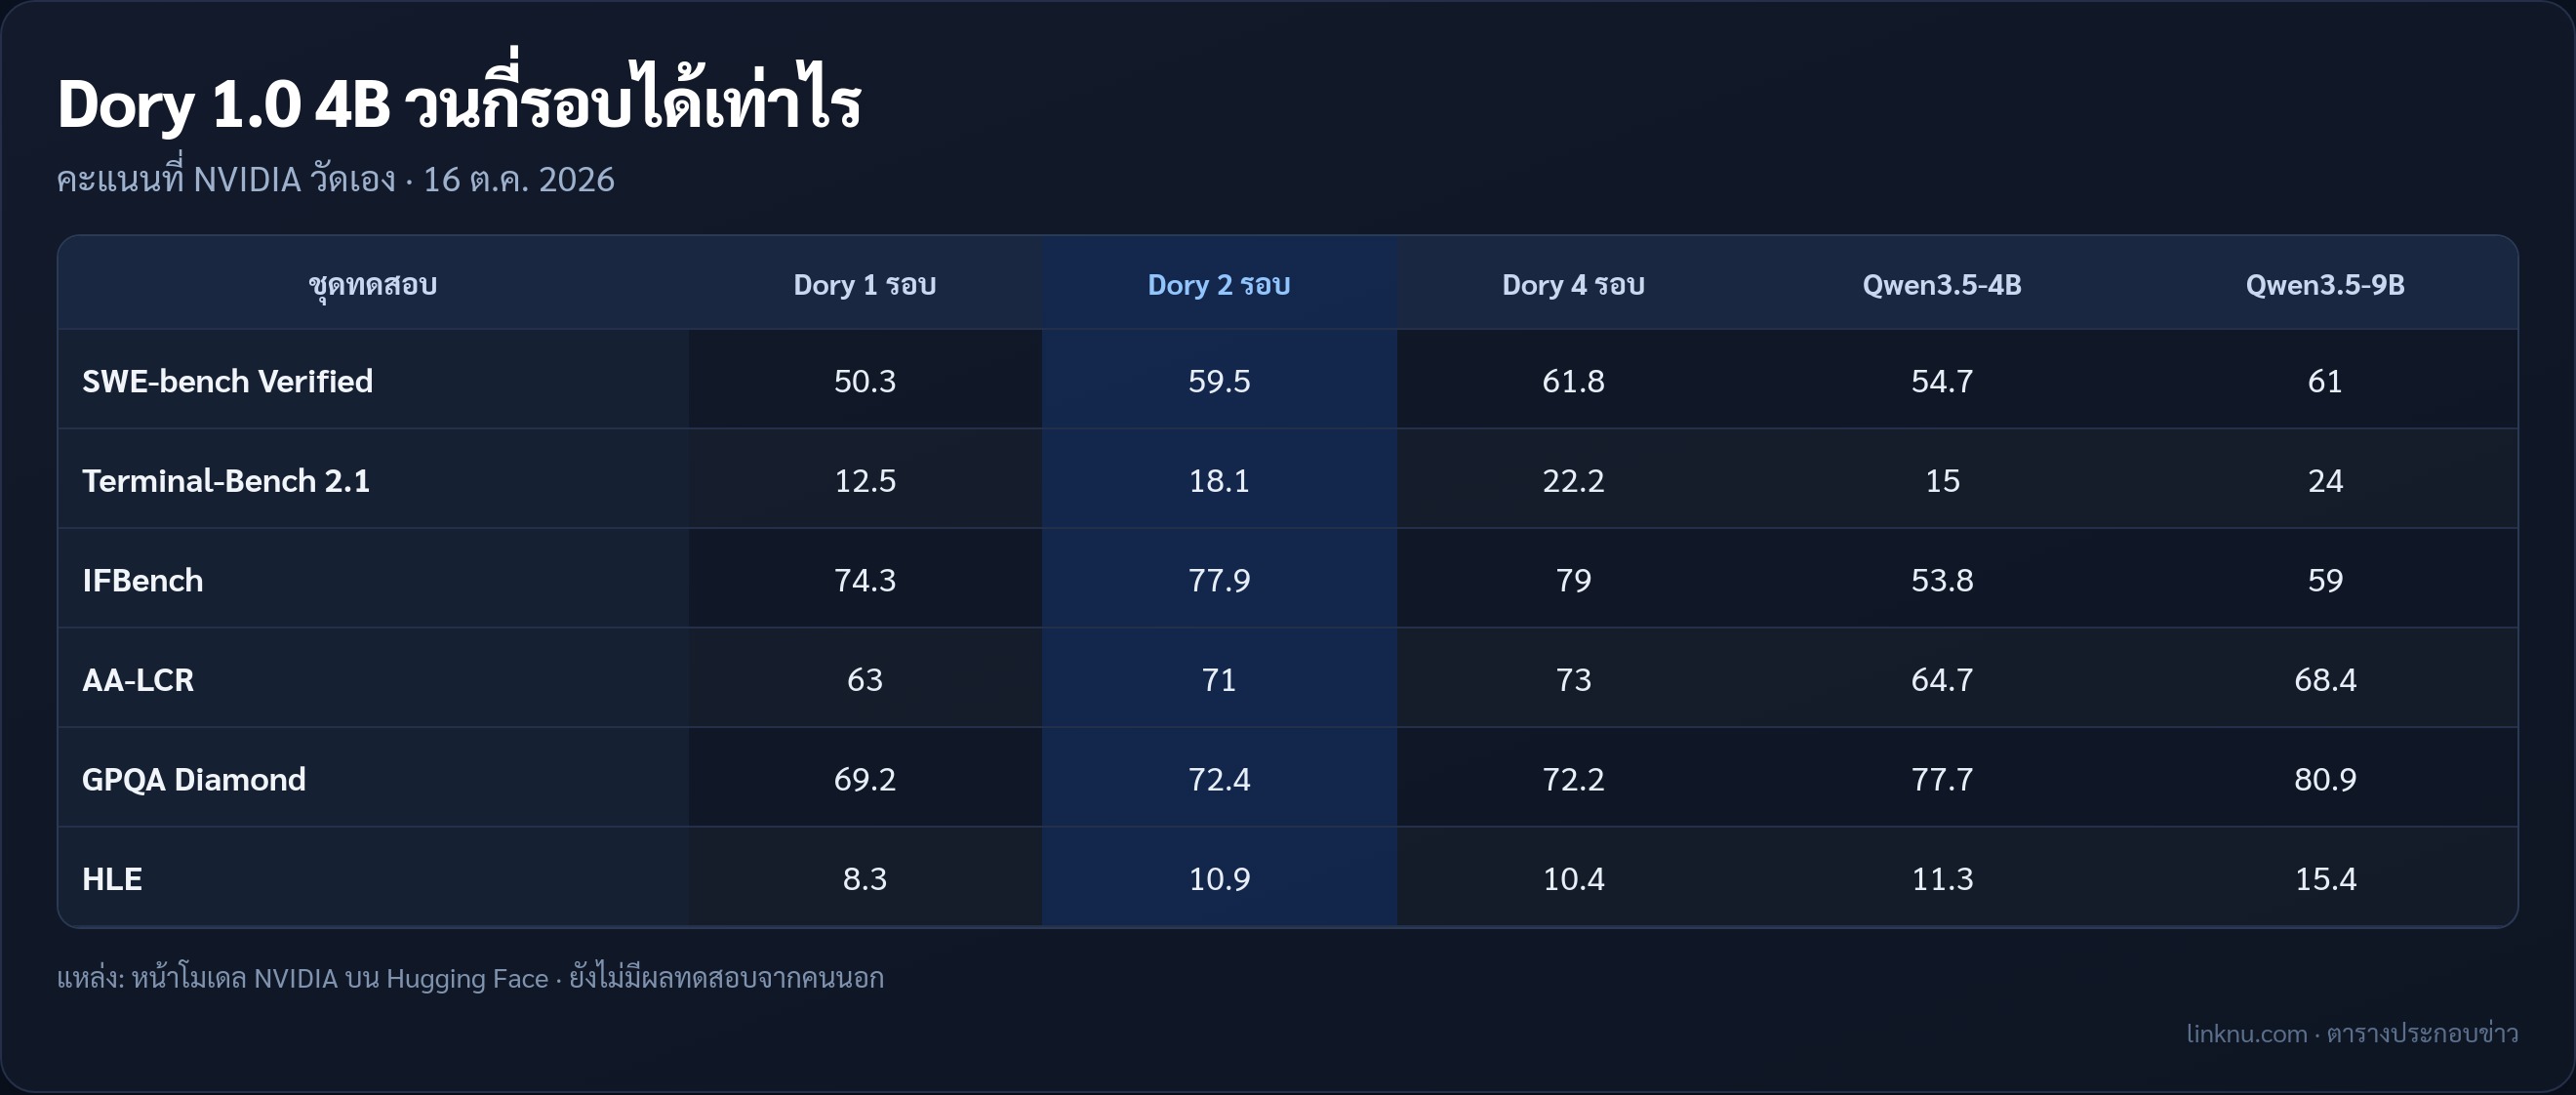
- SWE-bench Verified ได้ 50.3 เมื่อวน 1 รอบ ขึ้นเป็น 59.5 ที่ 2 รอบ และ 61.8 ที่ 4 รอบ สูงกว่า Qwen3.5-9B ที่ได้ 61
- Terminal-Bench 2.1 ขึ้นจาก 12.5 เป็น 22.2 เมื่อวน 4 รอบ แต่ยังต่ำกว่า Qwen3.5-9B ที่ได้ 24
- IFBench ด้านทำตามคำสั่ง ได้ 74.3 ถึง 79 สูงกว่า Qwen3.5-4B ที่ได้ 53.8 ชัดเจน
- งานอ่านเอกสารยาว AA-LCR ขึ้นจาก 63 เป็น 73
- ฝั่งความรู้กับเหตุผลยาก ๆ ยังแพ้ เช่น GPQA Diamond ได้ราว 72 ส่วน Qwen3.5-4B ได้ 77.7
เบื้องหลังการเทรน
- เทรนด้วยข้อมูล 6 ล้านล้านโทเคน ช่วงแรกราว 4.5 ล้านล้านโทเคนเทรนด้วยตัวเลข 4 บิตแบบ NVFP4 ของ NVIDIA เอง ที่เหลือใช้ BF16
- ขยายบริบทเพิ่มอีก 300 พันล้านโทเคน จนอ่านได้ยาวสุด 256K โทเคน
- ปิดท้ายด้วยการสอนตามตัวอย่าง และการเทรนแบบให้รางวัลด้วย GRPO ทั้งงานเลข โค้ด และการใช้เครื่องมือ
ใช้ได้ยังไงตอนนี้
- รันผ่าน vLLM ได้ แต่ตอนนี้ต้องติดตั้งจากโค้ดที่ยังรอรวมเข้าโปรเจกต์หลัก
- ใช้บน Mac รุ่นชิป M ได้ผ่าน llama.cpp แต่ต้องคอมไพล์โค้ดรุ่นที่รองรับ Dory เองก่อน
- รองรับเรียกใช้เครื่องมือ และใช้กับเอเจนต์เขียนโค้ดได้
อย่าเข้าใจผิด
- Dory รับและตอบเป็นข้อความภาษาอังกฤษเท่านั้น ยังไม่รองรับภาษาไทยหรือรูปภาพ
- คะแนนทั้งหมด NVIDIA วัดเองด้วยชุดเครื่องมือของตัวเอง ยังไม่มีผลจากคนนอก
- วนรอบมากขึ้นใช้พลังคำนวณต่อโทเคนมากขึ้น ต้องลองวัดความเร็วและค่าใช้จ่ายกับงานจริงก่อนเลือกจำนวนรอบ
- ชื่อ Dory ไม่เกี่ยวกับเหรียญคริปโตที่มีคนเอาชื่อไปโปรโมตบน X หลังโมเดลออก
สรุป
Dory เป็นการลองอีกทางของ NVIDIA แทนที่จะทำโมเดลใหญ่ขึ้น ก็ให้โมเดลเล็กวนคิดซ้ำแล้วเลือกได้ว่าจะจ่ายพลังคำนวณแค่ไหน ผลที่ออกมาคืองานโค้ดสูสีโมเดลที่ใหญ่กว่าเท่าตัว แต่ความรู้ทั่วไปยังสู้ไม่ได้ เหมาะกับคนที่อยากได้เอเจนต์ตัวเล็กไว้รันเองมากกว่าแชตบอตรอบรู้
แหล่ง: NVIDIA · Hugging Face · 16 ต.ค. 2026