เกิดอะไรขึ้น
- บัญชี Perplexity Developers ประกาศเมื่อ 16 ต.ค. 2026 ตามเวลาสหรัฐฯ และซีอีโอ Aravind Srinivas รีโพสต์ต่อ
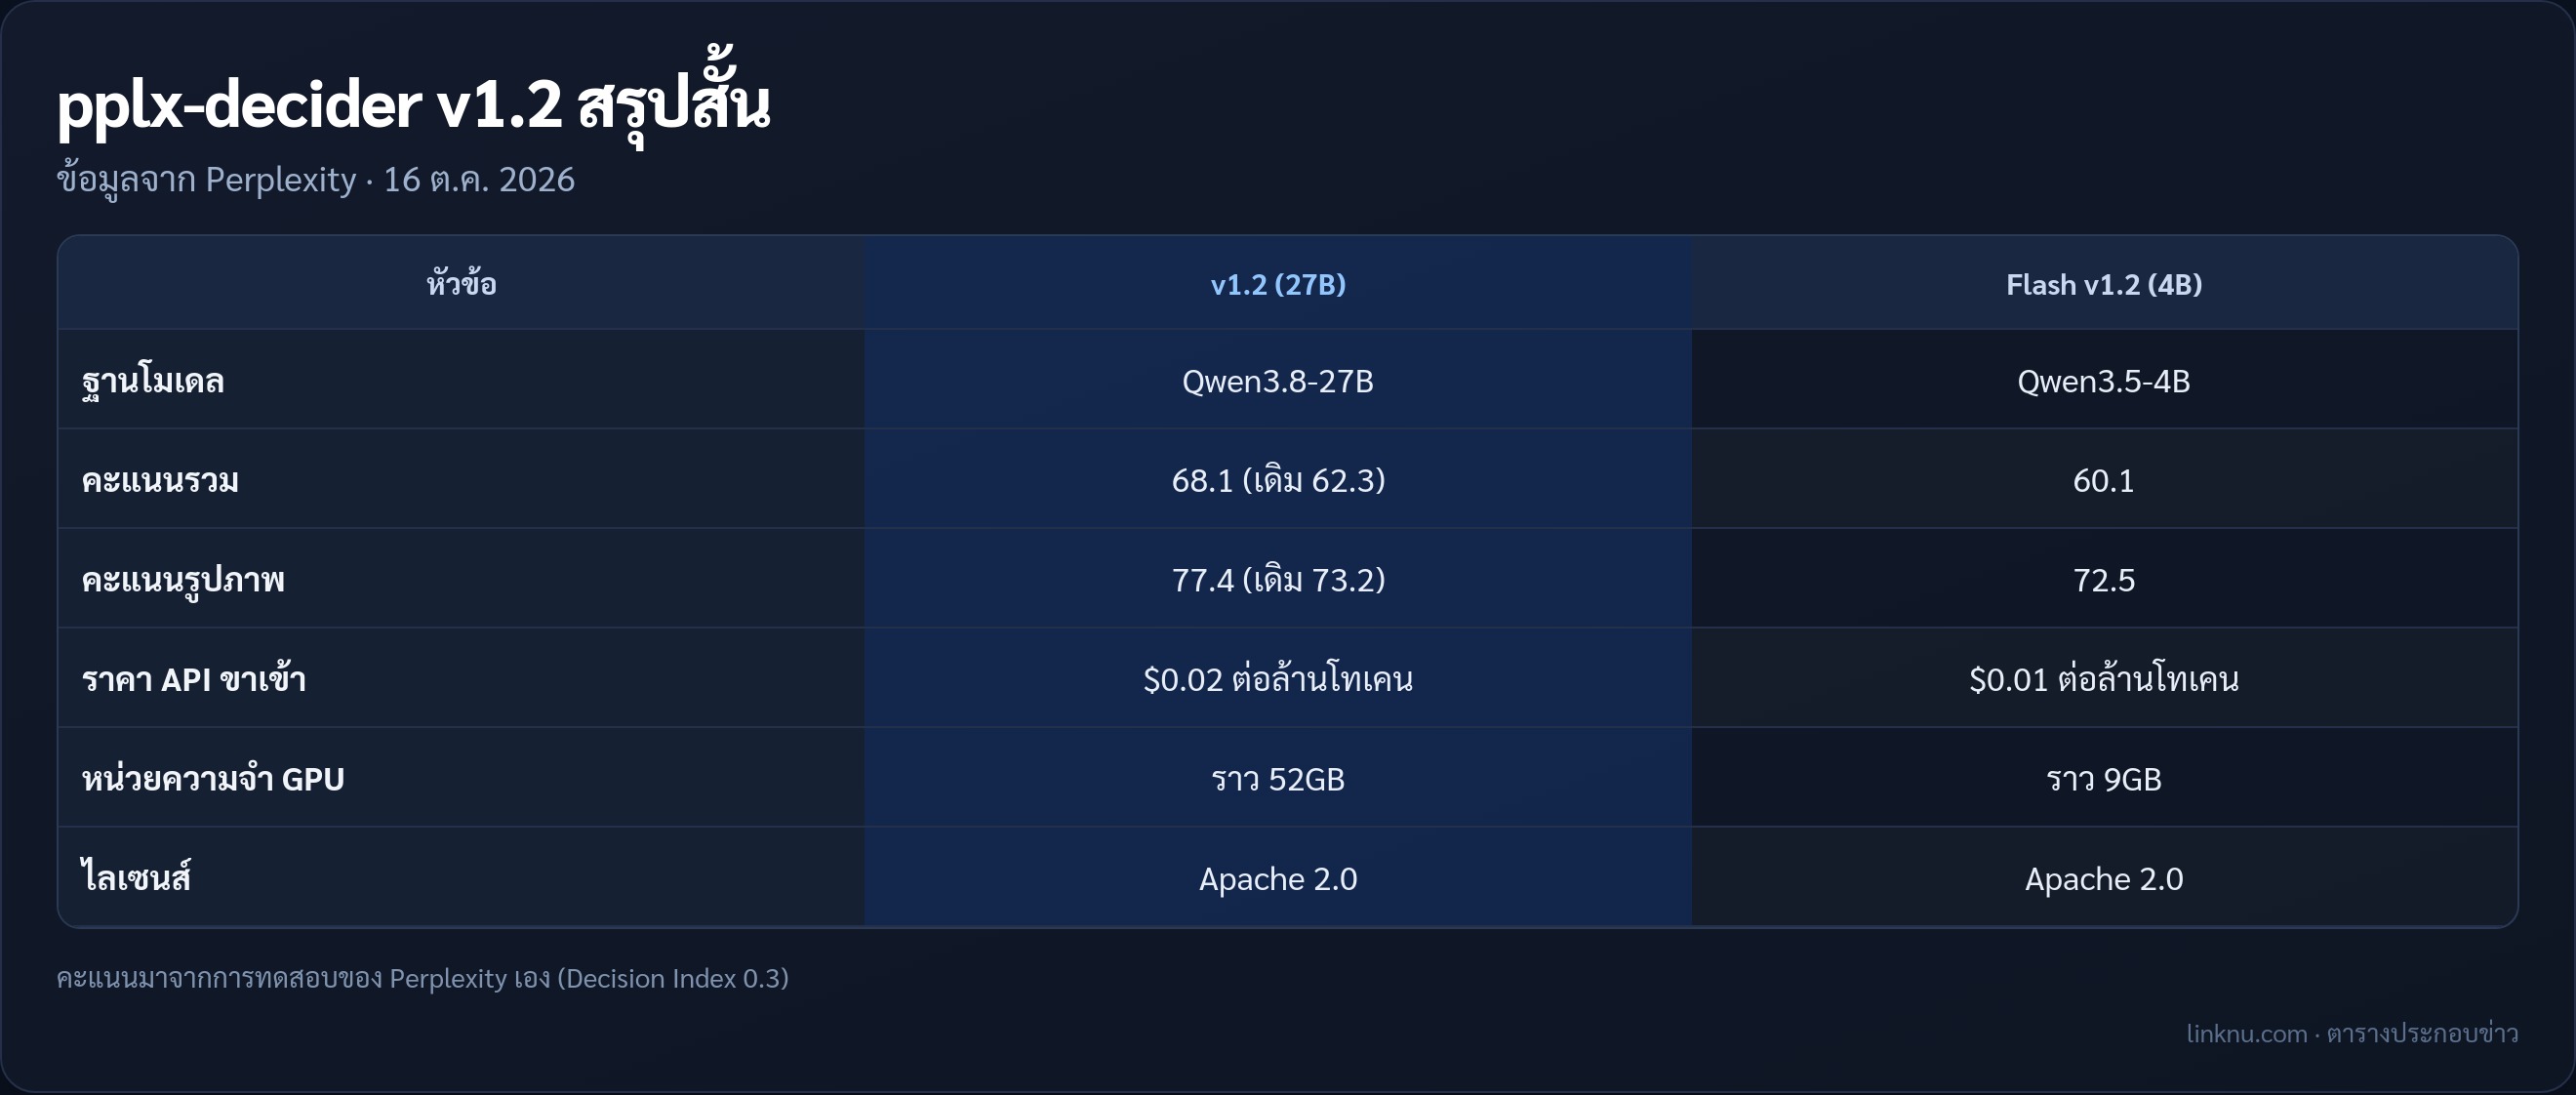
- รุ่นใหญ่ชื่อ pplx-decider-v1.2 ขนาด 27B สร้างต่อจากโมเดล Qwen3.8 ของ Alibaba
- รุ่นเล็กชื่อ pplx-decider-flash-v1.2 ขนาดราว 4B สร้างจาก Qwen3.5-4B แล้วให้เรียนรู้จากรุ่นใหญ่
- น้ำหนักทั้งสองรุ่นอยู่บน Hugging Face ไลเซนส์ Apache 2.0 เอาไปใช้เชิงพาณิชย์ได้
อะไรเปลี่ยนจากรุ่นก่อน
- รุ่น v1.1 ตอบได้ทีละคำถาม ถ้ามีห้าคำถามเกี่ยวกับข้อความเดียวกันก็ต้องรันห้ารอบ
- รุ่น v1.2 อ่านข้อความครั้งเดียวแล้วตอบทุกคำถามในรอบเดียว บริษัทบอกว่าเร็วขึ้นได้สูงสุด 5 เท่า
- ทีมเพิ่มพลังประมวลผลตอนเทรนและเพิ่มข้อมูลเยอะขึ้นมาก
- รองรับทั้งข้อความและรูปภาพ รูปละไม่เกินราว 1.6 ล้านพิกเซล
ผลทดสอบที่บริษัทบอก
- คะแนนรวม Decision Index ของรุ่น 27B ขึ้นจาก 62.3 เป็น 68.1
- คะแนนฝั่งรูปภาพขึ้นจาก 73.2 เป็น 77.4
- รุ่น Flash ได้ราว 60 คะแนน และบริษัทบอกว่าเป็นอันดับหนึ่งในกลุ่มขนาด 4B
- Perplexity บอกว่ารุ่น 27B ติดอันดับ 2 ในตารางจัดอันดับโมเดลตัดสินใจบน Hugging Face
ราคาและวิธีใช้
- ผ่าน API รุ่น 27B คิด 0.02 ดอลลาร์ต่อล้านโทเคนขาเข้า ส่วนคำตอบไม่คิดเงิน
- รุ่น Flash ถูกลงอีกครึ่ง อยู่ที่ 0.01 ดอลลาร์ต่อล้านโทเคน
- ใครยังเรียกชื่อรุ่นเก่า v1 หรือ v1.1 ระบบจะส่งไปที่ v1.2 ให้เอง และคิดราคาใหม่
- ถ้าลงเครื่องตัวเอง รุ่น 27B ต้องใช้การ์ดจอที่มีหน่วยความจำราว 52GB ส่วนรุ่น Flash ใช้ราว 9GB
ใครได้ประโยชน์
- ทีมที่ต้องคัดแยกข้อความจำนวนมาก เช่น ส่งตั๋วร้องเรียนไปให้ถูกแผนก หรือคัดสแปมและข้อความหลอกลวง
- ระบบเอเจนต์ที่ต้องเลือกว่าจะใช้เครื่องมือไหน หรือจัดอันดับเอกสารก่อนส่งให้โมเดลใหญ่ตอบ
- งานแบบนี้ไม่ต้องใช้โมเดลแชตตัวแพง โมเดลตัดสินใจราคาถูกทำได้เร็วกว่าและวัดความมั่นใจได้
อย่าเข้าใจผิด
- pplx-decider ไม่ใช่แชตบอต มันไม่เขียนข้อความตอบ ให้แค่คำตอบจากตัวเลือกพร้อมความน่าจะเป็น
- ตัวเลขทดสอบมาจาก Perplexity เอง และบริษัทยอมรับว่าเอาชุดฝึกของบางแบบทดสอบมาเทรนด้วย คะแนนบางส่วนจึงได้เปรียบ
- ถามหลายข้อพร้อมกันไม่ได้ดีขึ้นเสมอ ถ้าเป็นการเทียบตัวเลือกที่แข่งกันเอง เช่น จัดอันดับเอกสาร บริษัทแนะนำให้ส่งแยกทีละคำขอ
- รับข้อความยาวได้ถึงราว 262,000 โทเคน แต่ตอนเทรนใช้แค่ราว 32,000 โทเคน งานที่ยาวกว่านั้นควรทดสอบเองก่อน
สรุป
ตลาดโมเดลตัดสินใจเริ่มคึกคัก หลัง Liquid AI เพิ่งเปิด d1-ultra ไปไม่กี่วันก่อน Perplexity ตอบด้วยรุ่นที่เร็วขึ้น ถูกลง และโหลดมาใช้เองได้ทั้งสองขนาด สำหรับทีมที่ใช้โมเดลแชตตัวใหญ่ทำงานคัดแยกง่าย ๆ อยู่ นี่เป็นทางเลือกที่น่าลองเพื่อลดค่าใช้จ่าย
แหล่ง: Perplexity · Hugging Face · 16 ต.ค. 2026