MAI-Base-2 คืออะไร
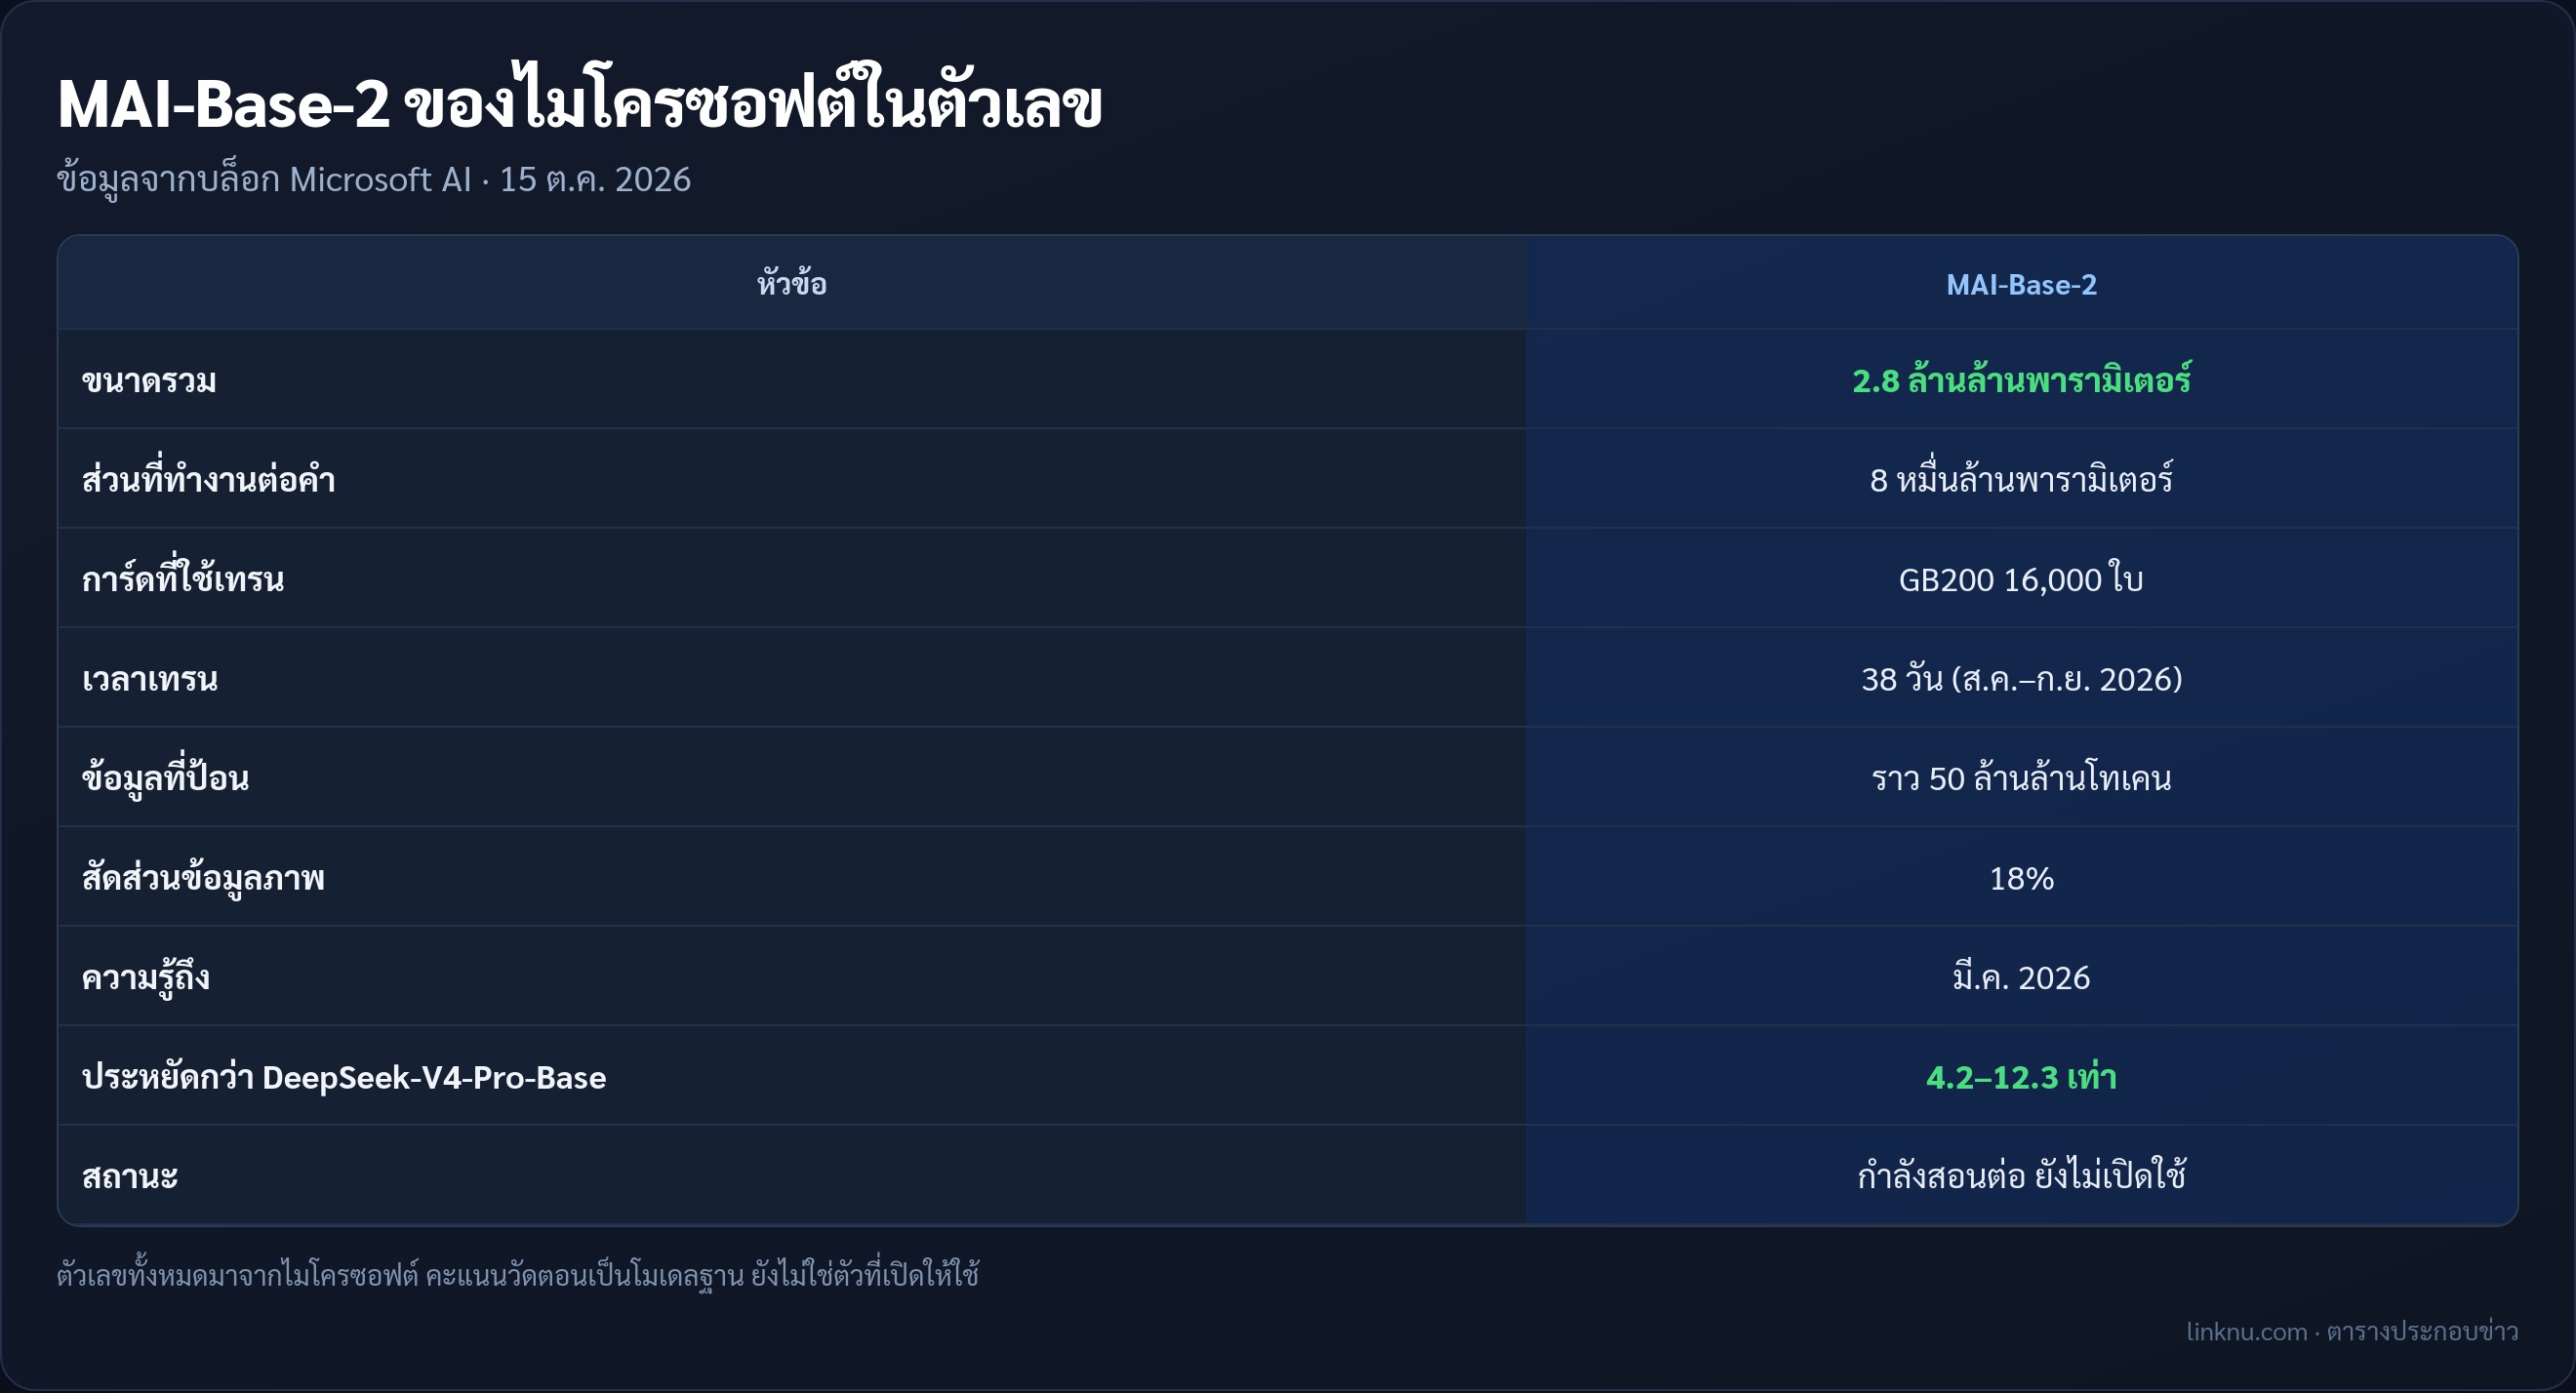
- เป็นโมเดลฐานแบบ MoE ขนาดรวม 2.8 ล้านล้านพารามิเตอร์ แต่ละคำใช้งานจริงราว 8 หมื่นล้าน
- ต่อยอดจาก MAI-Base-1 ที่เป็นฐานของ MAI-Thinking-1 ซึ่งเปิดตัวเมื่อเดือนมิถุนายน
- เทรนให้เข้าใจภาพมาตั้งแต่ต้น ไม่ได้ต่อตัวอ่านภาพเพิ่มทีหลัง
- ความรู้ในโมเดลไปถึงเดือนมีนาคม 2026
เทรนหนักแค่ไหน
- ใช้การ์ด GB200 ของ NVIDIA 16,000 ใบ เทรนต่อเนื่อง 38 วัน ช่วงเดือนสิงหาคมถึงกันยายน
- ข้อมูลที่ป้อนรวมราว 50 ล้านล้านโทเคน ในนั้นเป็นข้อมูลภาพคู่ข้อความราว 18%
- ข้อมูลเพิ่มขึ้นราว 36% จากรุ่นก่อน และบริษัทบอกว่าไม่ได้ลอกคำตอบจากโมเดลของคนอื่นมาสอน
- ระหว่างเทรน เวลาที่งานเดินได้จริงอยู่ที่ 89% ส่วนที่เหลือเสียไปกับการหยุดซ่อมและเริ่มใหม่
เก่งแค่ไหน
- ไมโครซอฟต์บอกว่าชนะโมเดลเปิดน้ำหนักทุกตัวที่ลองเทียบ ในชุดทดสอบที่บริษัทเก็บไว้เองทั้งโค้ด วิทยาศาสตร์ คณิต และถามตอบ
- ตัวที่เอามาเทียบมีทั้ง DeepSeek-V4-Pro-Base, Kimi K3, Qwen3.8 และ MiMo-V2.6-Pro
- บริษัทคำนวณว่าสูตรเทรนของตัวเองใช้พลังประมวลผลน้อยกว่า DeepSeek-V4-Pro-Base ราว 4.2–12.3 เท่า ถ้าจะทำคะแนนเท่ากัน
- ตัวเลขทั้งหมดเป็นผลที่ไมโครซอฟต์วัดเอง และวัดตอนยังเป็นโมเดลฐาน ยังไม่ใช่ตัวที่พร้อมคุย
จะได้ใช้เมื่อไร
- ตอนนี้ MAI-Base-2 กำลังถูกสอนต่อ บริษัทบอกแค่ว่าจะมีผลมาเล่าเพิ่มเร็ว ๆ นี้ ยังไม่มีวันเปิด
- ไมโครซอฟต์จะเอาไปใช้ในผลิตภัณฑ์ของตัวเองก่อน แล้วค่อยขายผ่าน Foundry ให้ลูกค้าองค์กร
- บริษัทบอกด้วยว่าจะเปิดให้พาร์ตเนอร์ที่ไว้ใจได้ขอไลเซนส์น้ำหนักโมเดลไปใช้
- ทีมเริ่มเตรียม MAI-Base-3 ต่อแล้ว
สรุป
ไมโครซอฟต์กำลังบอกตลาดว่าตัวเองมีโมเดลยักษ์ไว้ใช้เองแล้ว ไม่ต้องพึ่ง OpenAI อย่างเดียว ตัวเลขบนกระดาษดูแรง แต่ต้องรอดูตอนสอนเสร็จว่าตัวที่คนได้ใช้จริงจะสู้ GPT, Claude และ Gemini ได้แค่ไหน
แหล่ง: Microsoft AI · Investing.com · 15 ต.ค. 2026