สเปกที่ควรรู้
- ขนาดรวม 74B แต่ทำงานจริงครั้งละ 9B ต่อโทเคน
- บีบน้ำหนักเหลือราว 2 บิตต่อค่า ไฟล์ทั้งก้อนเลยเหลือ 24GB
- ดูภาพและวิดีโอได้ อ่านบริบทยาวสุด 256K โทเคน
- เปิดหรือปิดโหมดคิดก่อนตอบได้ มีตัวช่วยเดาโทเคนล่วงหน้าให้ตอบเร็วขึ้น
- ย่อมาจาก Nemotron 3.5 Super VL ขนาด 120B ที่ NVIDIA เพิ่งเปิดตัวคืนเดียวกัน
ตัวเลขที่ NVIDIA เคลม
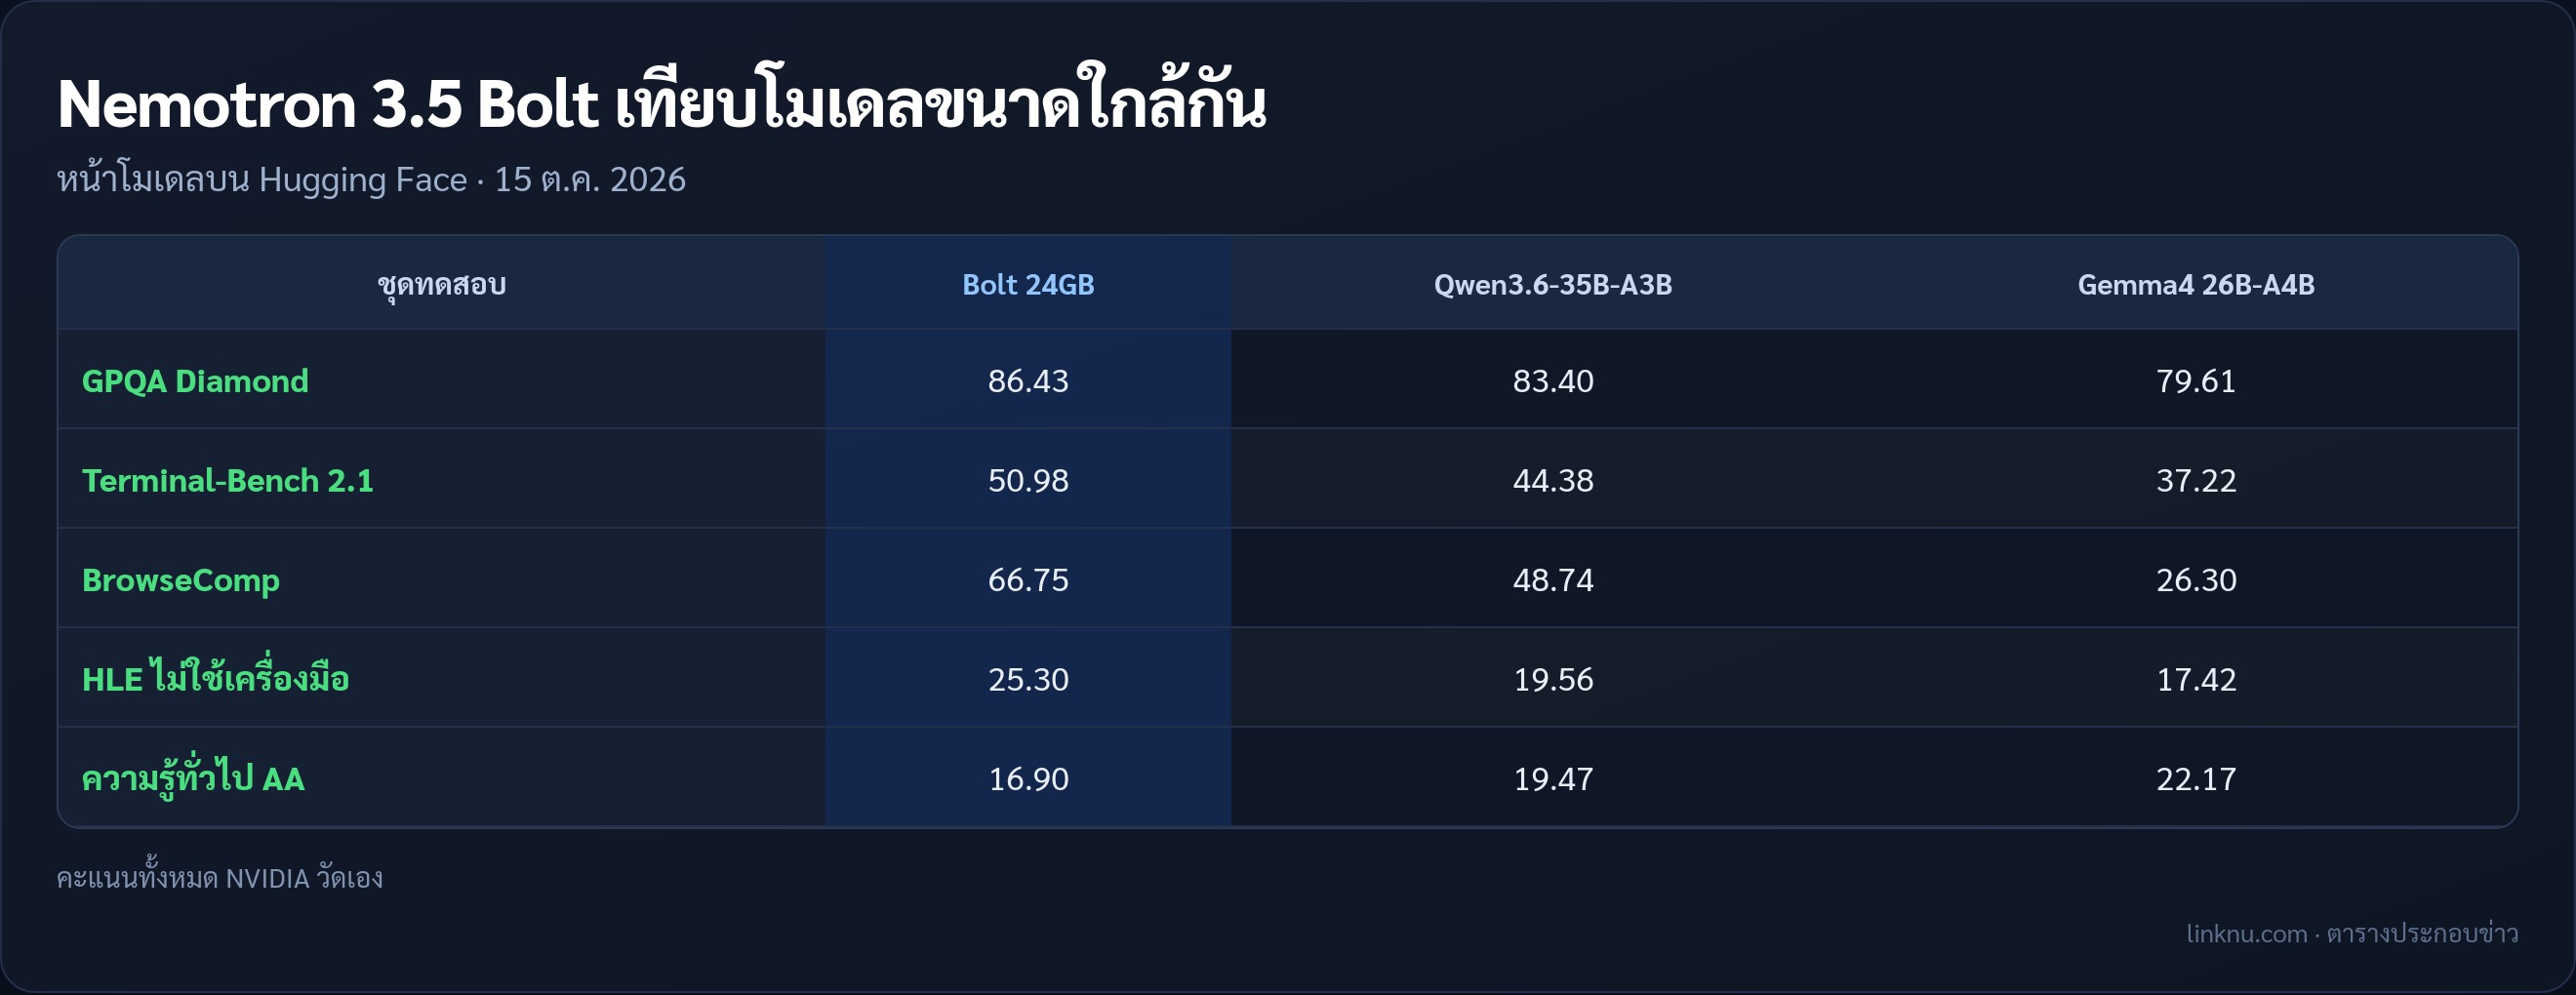
- เทียบกับโมเดลเปิดที่ใช้หน่วยความจำใกล้กัน อย่าง Qwen3.6-35B-A3B และ Gemma4 26B-A4B
- โจทย์วิทยาศาสตร์ยาก GPQA Diamond ได้ 86.43 ส่วน Qwen ได้ 83.40
- ชุดทดสอบงานในเทอร์มินัล ได้ 50.98 ส่วน Qwen ได้ 44.38
- ชุดทดสอบท่องเว็บหาคำตอบ BrowseComp ได้ 66.75 ทิ้ง Qwen ที่ได้ 48.74
- บางชุดยังแพ้ เช่น ความแม่นด้านความรู้ทั่วไป ได้ 16.90 ส่วน Gemma ได้ 22.17
- ตัวเลขทั้งหมดเป็นผลที่ NVIDIA วัดเอง
โหลดและรันได้ยังไง
- โหลดน้ำหนักฟรีบน Hugging Face บัญชี nvidia มีทั้งรุ่น 24GB รุ่นไฟล์ GGUF และรุ่นเต็มความละเอียด ไม่ต้องขอสิทธิ์
- ไลเซนส์ OpenMDW-1.1 ใช้ได้ทั้งงานเชิงพาณิชย์และไม่ใช่เชิงพาณิชย์
- หน้าโมเดลมีสูตรรันด้วย vLLM บนการ์ด A100, H100 หรือรุ่น Blackwell
- NVIDIA บอกว่ารันผ่านโปรแกรมอย่าง llama.cpp, Ollama และ LM Studio ได้ด้วย
- แอปเอเจนต์อย่าง Hermes กับ OpenClaw จะเรียกใช้ได้ตรง ๆ
สรุป
Bolt คือคำตอบของ NVIDIA สำหรับคนที่อยากรันเอเจนต์ฉลาด ๆ บนเครื่องตัวเอง ไม่ต้องส่งงานขึ้นคลาวด์ ใช้หน่วยความจำ 24GB แต่ได้โมเดลขนาด 74B ถ้าตัวเลขที่เคลมไว้ใช้ได้จริง จะเป็นตัวเลือกที่น่าสนใจสำหรับเจ้าของการ์ดจอแรม 24GB ขึ้นไป และคนที่รอซื้อ RTX Spark
แหล่ง: NVIDIA Blog (13 ต.ค. 2026) · Hugging Face · 15 ต.ค. 2026