สเปกที่ควรรู้
- ขนาดรวม 120B แต่ทำงานจริงครั้งละ 12B ต่อโทเคน
- ข้างในผสมสองแบบ คือ Mamba-2 กับทรานส์ฟอร์เมอร์ แล้วต่อกับตัวอ่านภาพที่ NVIDIA ทำเอง
- อ่านบริบทได้ยาวสุด 1 ล้านโทเคน รับข้อความ ภาพ และวิดีโอ แล้วตอบกลับเป็นข้อความ
- เปิดหรือปิดโหมดคิดก่อนตอบได้เอง
- มีตัวช่วยเดาโทเคนล่วงหน้า (MTP) ในตัว ทำให้ตอบได้เร็วขึ้น
- รุ่นเต็มต้องใช้การ์ด H100 4 ใบ หรือ GB200 2 ใบ
- รุ่นบีบขนาด NVFP4 เล็กลงจนรันบนเครื่อง DGX Spark ได้
ตัวเลขที่ NVIDIA เคลม
- บนการ์ดจอใบเดียว รับงานเอเจนต์ได้มากกว่าโมเดลเปิดขนาดใกล้กันสูงสุด 5 เท่า
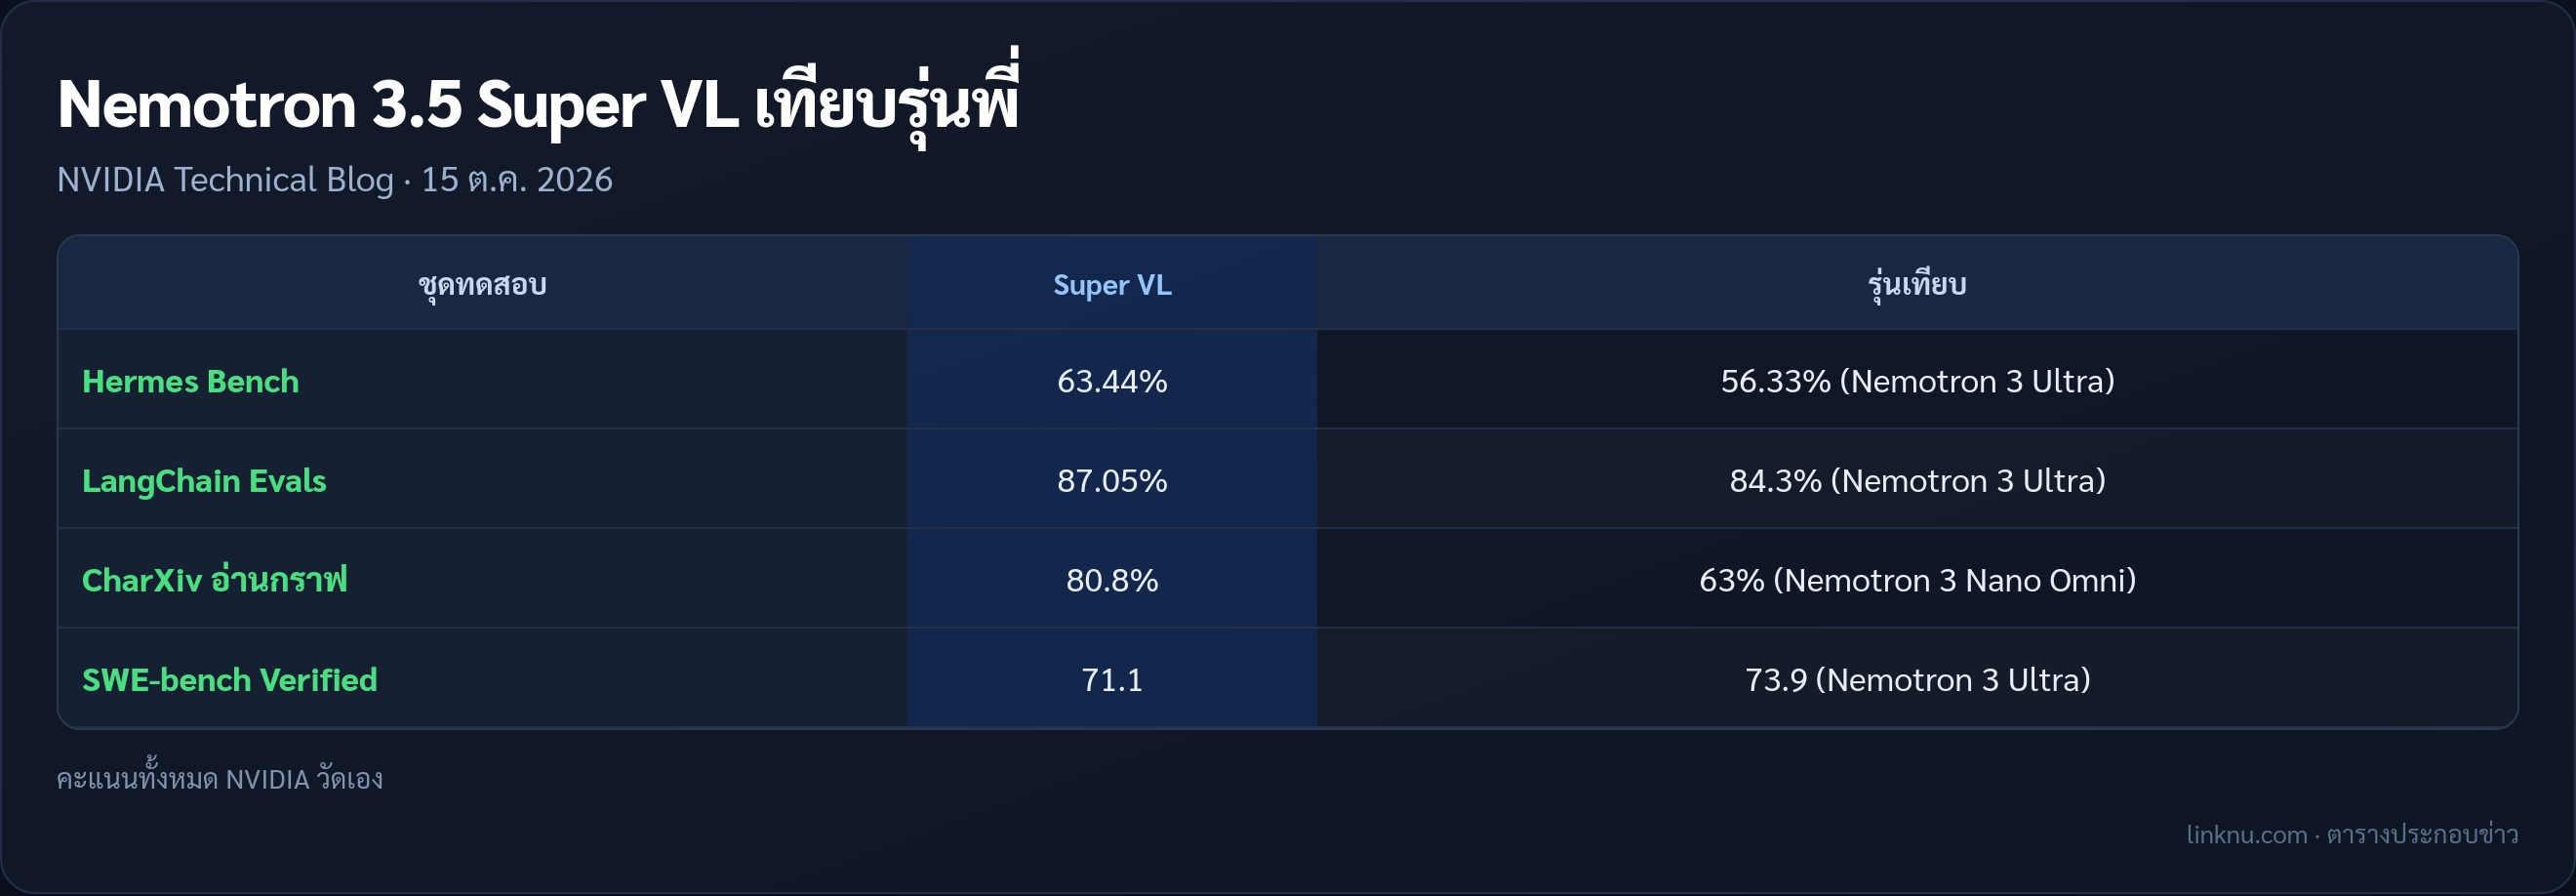
- ชุดทดสอบเอเจนต์ Hermes Bench ได้ 63.44% สูงกว่า Nemotron 3 Ultra รุ่นใหญ่ของตัวเองที่ได้ 56.33%
- ชุดทดสอบของ LangChain ได้ 87.05% เทียบกับ 84.3% ของรุ่นใหญ่
- โจทย์อ่านกราฟ CharXiv ได้ 80.8% จากเดิม 63% ของ Nemotron 3 Nano Omni
- SWE-bench Verified ได้ 71.1 ตามตารางบนหน้าโมเดล
- ตัวเลขทั้งหมดเป็นผลที่ NVIDIA วัดเอง ยังไม่มีผลทดสอบจากคนนอก
มีใครเอาไปใช้แล้วบ้าง
- Scale AI จูนให้ Skydance ใช้ประมวลผลเครดิตคู่ค้า ค่ารันถูกลง 40 เท่า และเร็วขึ้น 5 เท่า
- Ramp ใช้แปลงรูปใบเสร็จเป็นข้อมูลพร้อมใช้ คาดว่ารับงานได้มากขึ้นถึง 50% และหน่วงลดลง 10 เท่า
- AI21 จูนให้ Alice บริษัทด้านความปลอดภัยเอไอ ใช้วิเคราะห์ภัยไซเบอร์ แม่นขึ้น 40%
โหลดและลองได้ที่ไหน
- โหลดน้ำหนักได้ฟรีบน Hugging Face มีทั้งรุ่นตั้งต้น รุ่นเต็ม และรุ่นบีบขนาด ไม่ต้องขอสิทธิ์
- ไลเซนส์ OpenMDW-1.1 ใช้ได้ทั้งงานเชิงพาณิชย์และไม่ใช่เชิงพาณิชย์
- ลองเรียกผ่าน API ได้ที่ build.nvidia.com หรือรันเองด้วย vLLM กับ SGLang
- NVIDIA ปล่อยชุดข้อมูลเทรนแบบเปิดบน Hugging Face มาด้วย รวมข้อมูลภาษาอินเดีย 22 ภาษา ราว 2.8 ล้านล้านโทเคน
สรุป
Super VL คือรุ่นกลางของตระกูล Nemotron 3.5 ที่ NVIDIA วางไว้ทำงานหลายขั้นตอนที่ต้องดูทั้งข้อความและภาพไปพร้อมกัน ใหญ่กว่า Nemotron 3.5 Lightning แต่เล็กกว่า Nemotron 3 Ultra ใครกำลังทำเอเจนต์อ่านเอกสาร ใบเสร็จ หรือกราฟ ได้ตัวเลือกโมเดลเปิดที่เอาไปจูนเองได้อีกตัว แต่ต้องมีการ์ดจอระดับดาต้าเซ็นเตอร์ หรือใช้รุ่น NVFP4 ถ้าจะรันในเครื่อง
แหล่ง: NVIDIA Technical Blog · Hugging Face · build.nvidia.com · 15 ต.ค. 2026