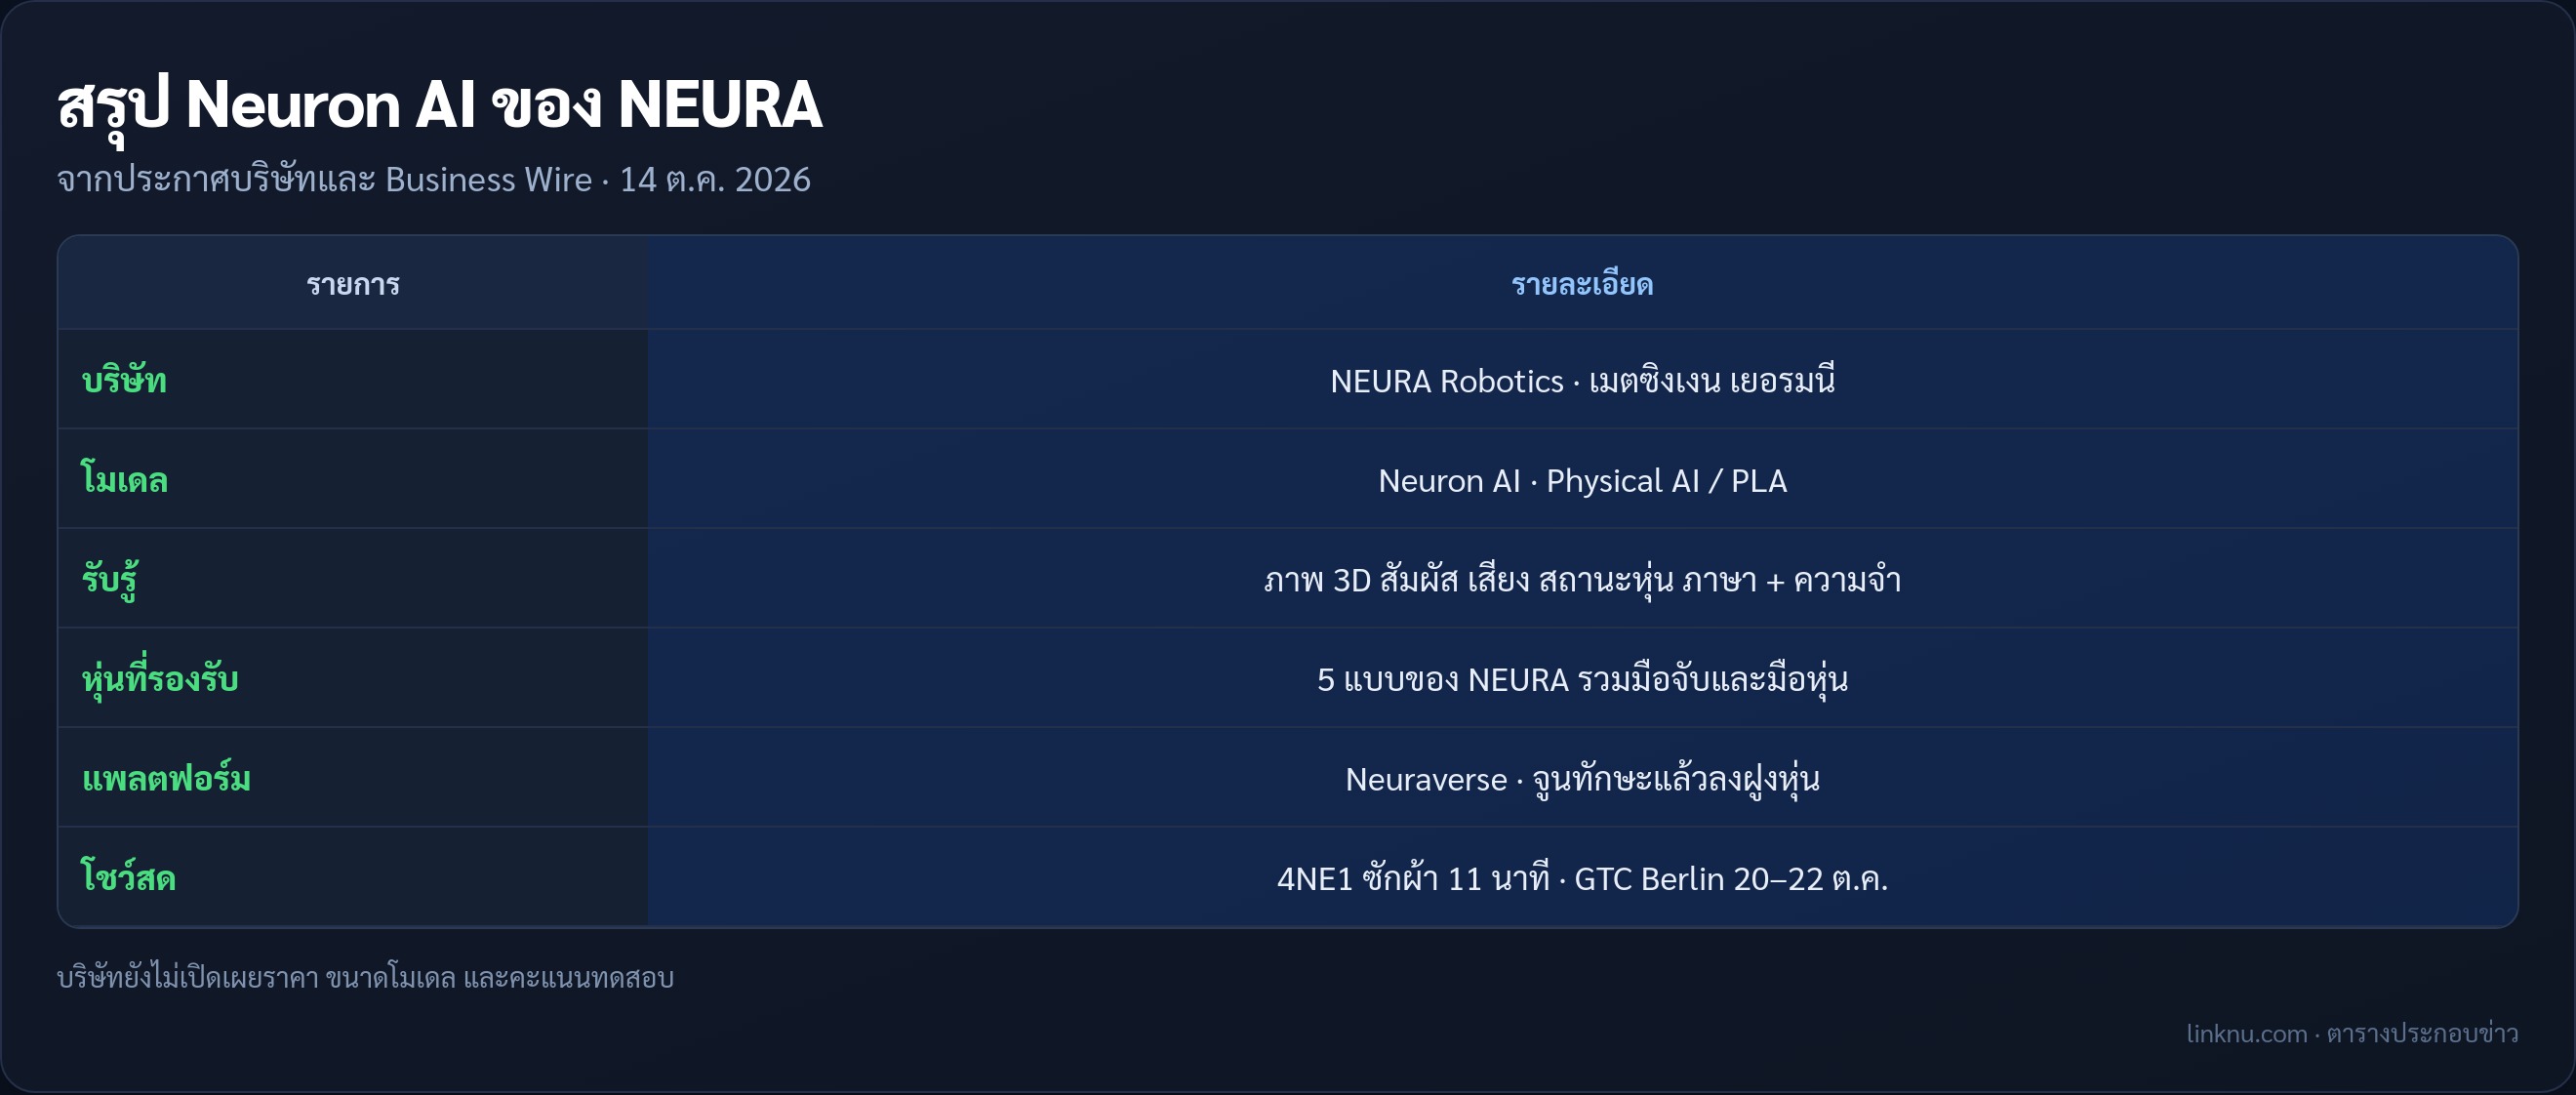
จุดต่างคือไม่ได้ดูแค่กล้อง แต่เอาภาพ 3 มิติ แรงสัมผัส เสียง สถานะของตัวหุ่น และคำสั่งภาษามารวมไว้ในโมเดลเดียว บริษัทเรียกโครงนี้ว่า Perception-Language-Action หรือ PLA คือเชื่อมสิ่งที่หุ่นเห็น ได้ยิน และรู้สึก เข้ากับสิ่งที่มันเพิ่งทำไป แล้วแปลงออกมาเป็นการขยับจริง
ทำไมต้องมีมากกว่ากล้อง
- กล้องบอกรูปทรง สี และตำแหน่งได้ แต่บอกไม่ได้ว่าน็อตขันติดหรือยัง หรือขั้วต่อเสียบเข้าที่แล้วหรือไม่
- ตอนไขกุญแจ มีแค่เสียงกับสัมผัสที่ยืนยันได้ว่าเปิดแล้วจริง
- งานที่กล้องทำได้อยู่แล้วก็ดีขึ้นด้วย เช่น งานเชื่อมโลหะ แค่ฟังเสียงตอนเชื่อมก็พอบอกคุณภาพแนวเชื่อมได้
- มีระบบความจำ หุ่นจำได้ว่าของยังอยู่ตรงนั้น แม้จะหลุดจากมุมกล้องไปแล้ว คล้ายที่เด็กเล็กเรียนรู้ในช่วง 2 ขวบแรก
ฝึกจากข้อมูลอะไร
- ข้อมูลจากหุ่นจริงที่ทำงานใน NEURA Gyms ศูนย์ฝึกหุ่นของบริษัท เก็บภาพ สัมผัส แรง เสียง และการเคลื่อนไหวไปพร้อมกัน
- ข้อมูลจำลองที่ขยายต่อจากงานจริง ด้วยระบบ Data Amplifier ของบริษัท
- ท่าทางของคนจริงที่ใส่ชุดติดเซ็นเซอร์ แล้วสาธิตงานให้หุ่นดู
- โมเดลเดียวใช้ได้กับหุ่น 5 แบบของ NEURA รวมถึงมือจับและมือหุ่นอีกหลายแบบ
- มี Schaeffler กับ Bosch เป็นพาร์ตเนอร์ด้านข้อมูล ตัวโมเดลพัฒนาและเทรนเองที่เมืองเมตซิงเงน เยอรมนี
ลูกค้าเอาไปใช้ยังไง
- ลูกค้าจูนโมเดลกับงานของตัวเองได้ แล้วส่งทักษะใหม่ไปลงหุ่นทั้งฝูงผ่านแพลตฟอร์ม Neuraverse
- ทักษะที่ลูกค้าทำเองเก็บเป็นของส่วนตัวได้ จะแชร์ให้คนอื่นใช้ด้วยหรือไม่ก็เลือกเอง
- ตัวชี้วัดหลักที่บริษัทใช้คือ Time-to-Skill หรือเวลาที่หุ่นใช้เรียนงานใหม่จนทำได้นิ่ง
- บริษัทยังไม่ได้บอกราคา ขนาดโมเดล หรือคะแนนทดสอบ
ไปดูของจริงได้ที่ไหน
- งาน NVIDIA GTC Berlin วันที่ 20–22 ต.ค. นี้ NEURA จะให้หุ่นฮิวแมนนอยด์ 4NE1 ซักผ้าเองครบชุดยาว 11 นาที ตั้งแต่แยกผ้า ใส่เครื่องซัก ปิดเปิดฝา ไปจนย้ายผ้าเข้าเครื่องอบ โดยไม่มีคนช่วย
- บูธอยู่ที่ Station-Berlin ฮอลล์ 3 บูธ 3031
- ก่อนหน้านี้ NEURA เคยประกาศระดมทุนรอบ Series C สูงสุด 1.2 พันล้านยูโร เมื่อ มิ.ย. 2026
สรุป
หุ่นยนต์ส่วนใหญ่ยังพึ่งกล้องเป็นหลัก NEURA เลือกเดิมพันว่าหุ่นที่ใช้งานในโรงงานได้จริงต้องฟังเป็นและรู้สึกเป็นด้วย ที่เหลือต้องรอดูว่าหุ่นซักผ้าที่เบอร์ลินจะทำได้ลื่นแค่ไหน
แหล่ง: NEURA Robotics / Business Wire / EU-Startups · 14 ต.ค. 2026