ไอเดียคืออยากได้เอเจนต์ที่คิดเป็นขั้น เรียกเครื่องมือได้ และข้อมูลไม่ต้องออกจากเครื่อง บริษัทเปิดให้โหลดน้ำหนักฟรี และมี API ให้เรียกด้วย
มีอะไรใหม่
- เป็นโมเดลแบบผสมผู้เชี่ยวชาญที่คิดก่อนตอบทุกครั้ง ไม่ใช่แชตธรรมดา
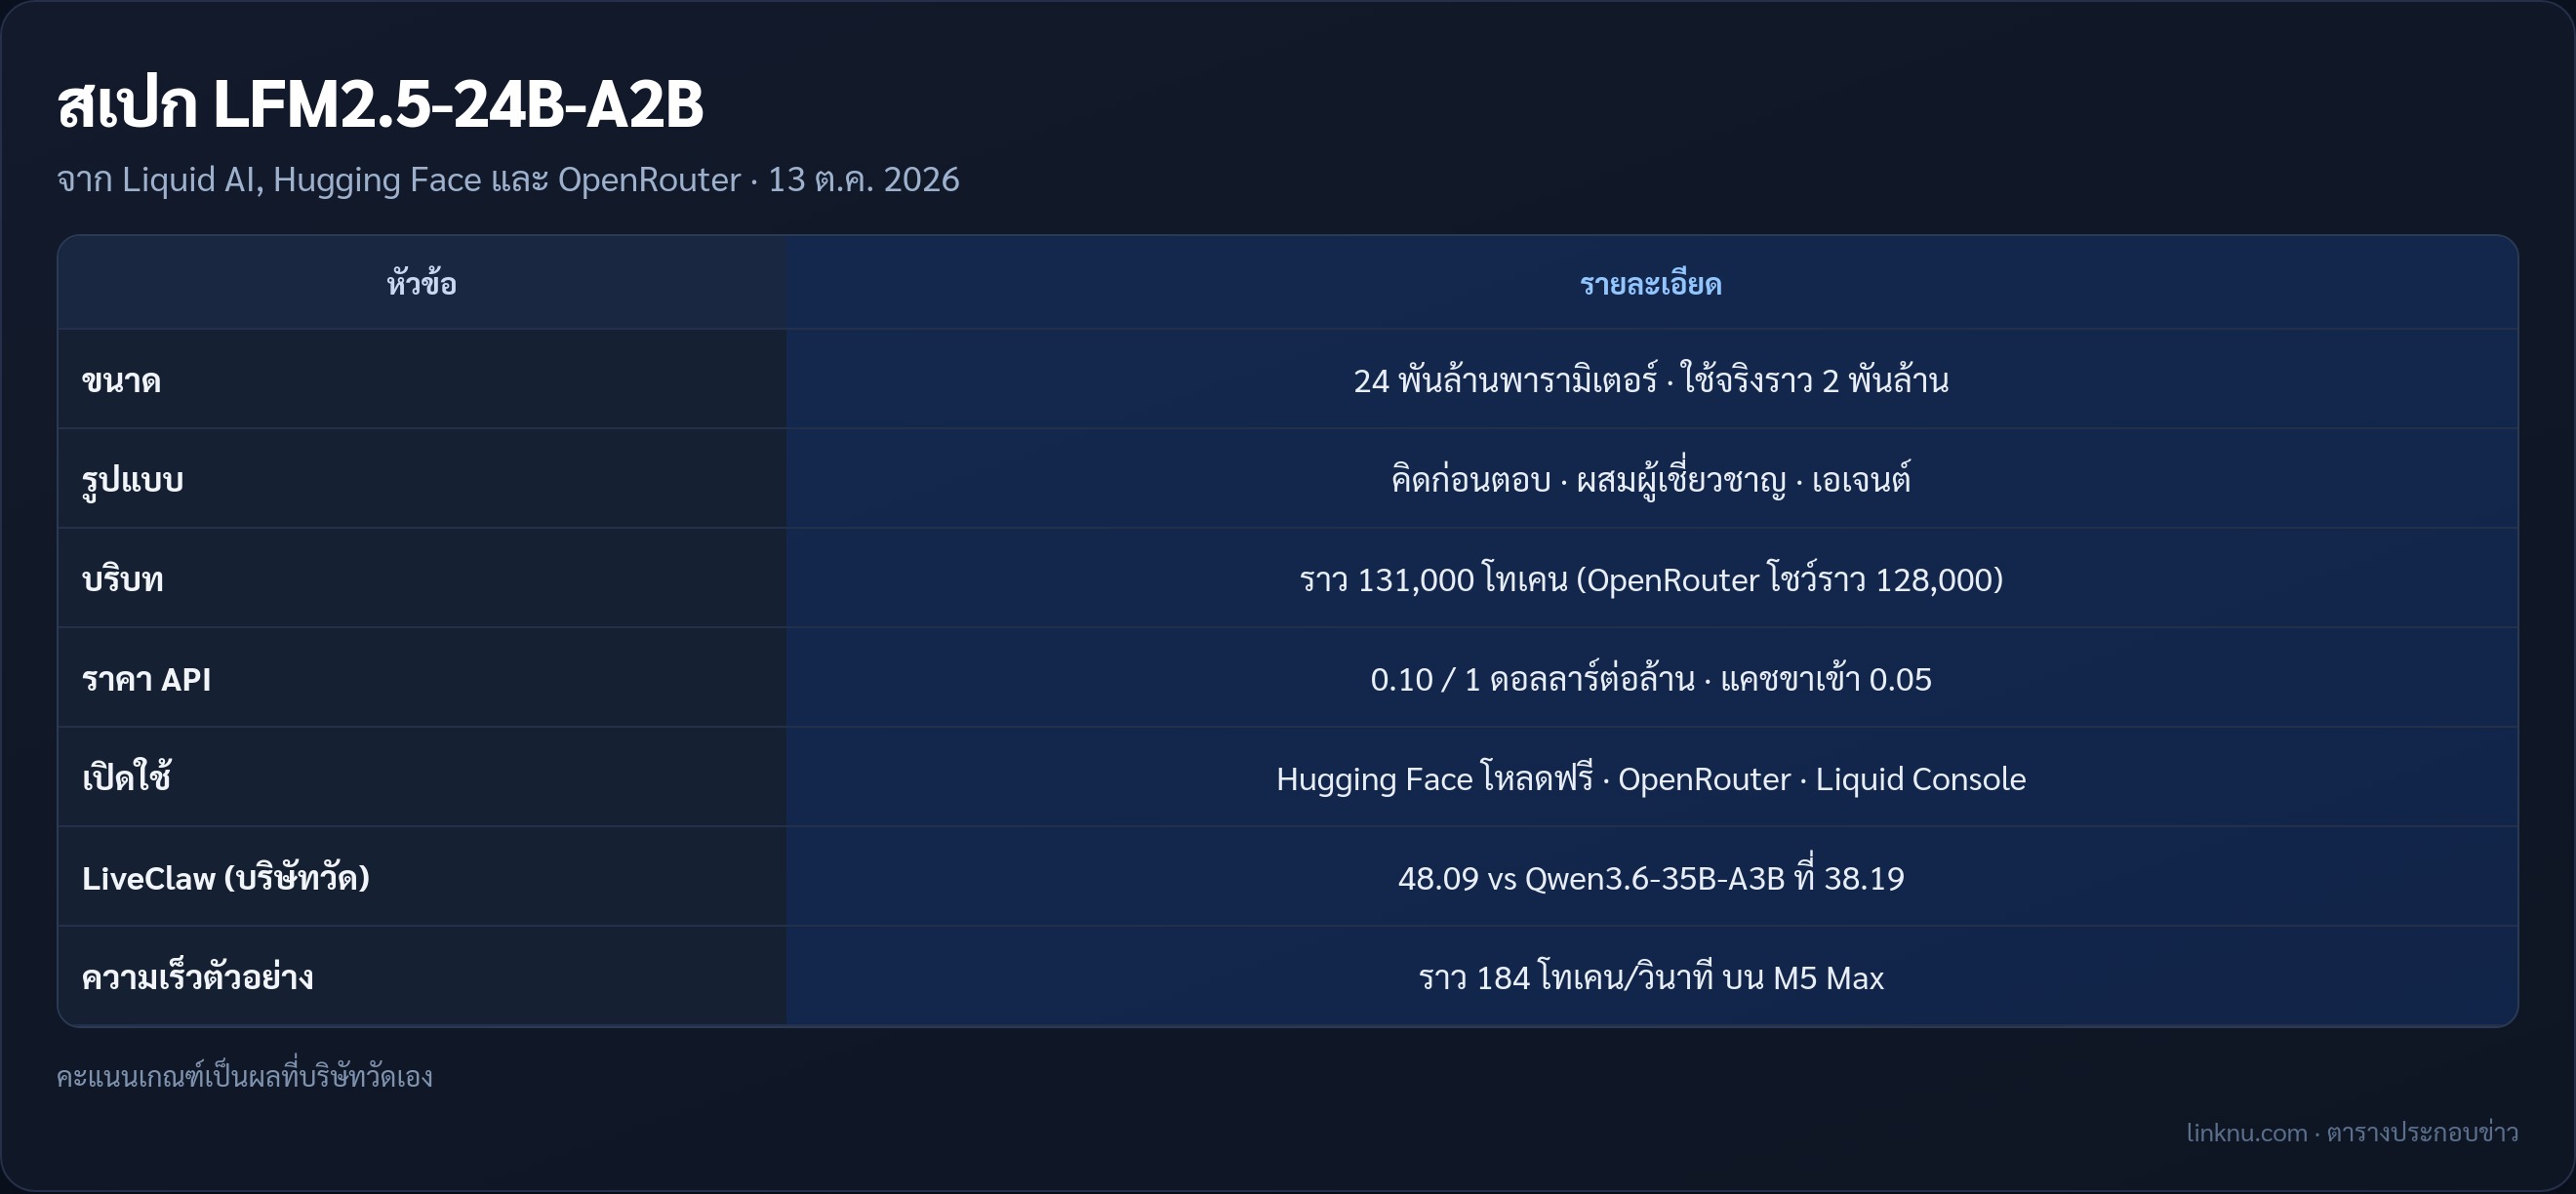
- หน้าต่างบริบทยาวขึ้นเป็นราว 131,000 โทเคน จากรุ่นก่อนที่ราว 32,000
- โหลดน้ำหนักฟรีบน Hugging Face ทั้งรุ่นพื้นฐานและรุ่นที่เทรนต่อแล้ว
- รองรับเครื่องมือรันโมเดลยอดนิยมหลายตัวตั้งแต่วันแรก เช่น ลามาซีพีพี เอ็มแอลเอ็กซ์ และวีแอลแอลเอ็ม
- บน API ของบริษัท ราคา 0.10 / 1 ดอลลาร์ต่อล้านโทเคน ขาเข้าที่อ่านจากแคช 0.05 ดอลลาร์
- ขึ้น OpenRouter ด้วยในชื่อ liquid/lfm-2.5-24b-a2b ราคาเดียวกัน
ตัวเลขที่บริษัทโชว์
- บนเกณฑ์ LiveClaw ได้ 48.09 สูงกว่า Qwen3.6-35B-A3B ที่ 38.19
- บนเกณฑ์ AutomationBench ได้ 27.69 ส่วนคู่แข่งใกล้เคียงได้แค่หลักเดียว
- ถอดคำได้ราว 184 โทเคนต่อวินาทีบนแมคบุ๊กชิป M5 Max และสูงสุดราว 21,000 โทเคนต่อวินาทีบนจีพียู B300 ใบเดียว
- บริษัทบอกว่ารุ่นนี้เล็กกว่าคู่แข่งกลุ่มเดียวกัน แต่แข่งได้ในงานเอเจนต์กับเรียกเครื่องมือ 5 จาก 8 เกณฑ์ที่วัด
จุดที่ควรรู้
- ตัวเลขเกณฑ์ทั้งหมดเป็นผลที่บริษัทวัดเอง
- งานที่ต้องใช้ความรู้เยอะ เช่น GPQA หรือเขียนโค้ดยาว รุ่นที่ใหญ่กว่ายังนำอยู่ บริษัทแนะนำให้ต่อกับระบบค้นหา
- หน้าต่างบริบทบน OpenRouter โชว์ราว 128,000 โทเคน ซึ่งใกล้กับเลขในประกาศของบริษัท
สรุป
ถ้าอยากได้เอเจนต์ที่คิดเป็นขั้นตอน เรียกเครื่องมือได้ และข้อมูลไม่ต้องออกจากเครื่อง LFM2.5-24B-A2B เป็นตัวเลือกที่โหลดฟรีและเริ่มใช้ได้วันนี้
แหล่ง: Liquid AI · Hugging Face · OpenRouter · 13 ต.ค. 2026