จุดขายหลักของ Snap
- รับคอนเท็กซ์ผสมข้อความกับรูปได้ยาวสูงสุด 384K โทเคน ในรอบเดียว ไม่ต้องตัดไฟล์หรือแบ่งชิ้นก่อน
- ประมวลผลคำขอราว 100K โทเคนแล้วตอบได้ในราว 1 วินาที
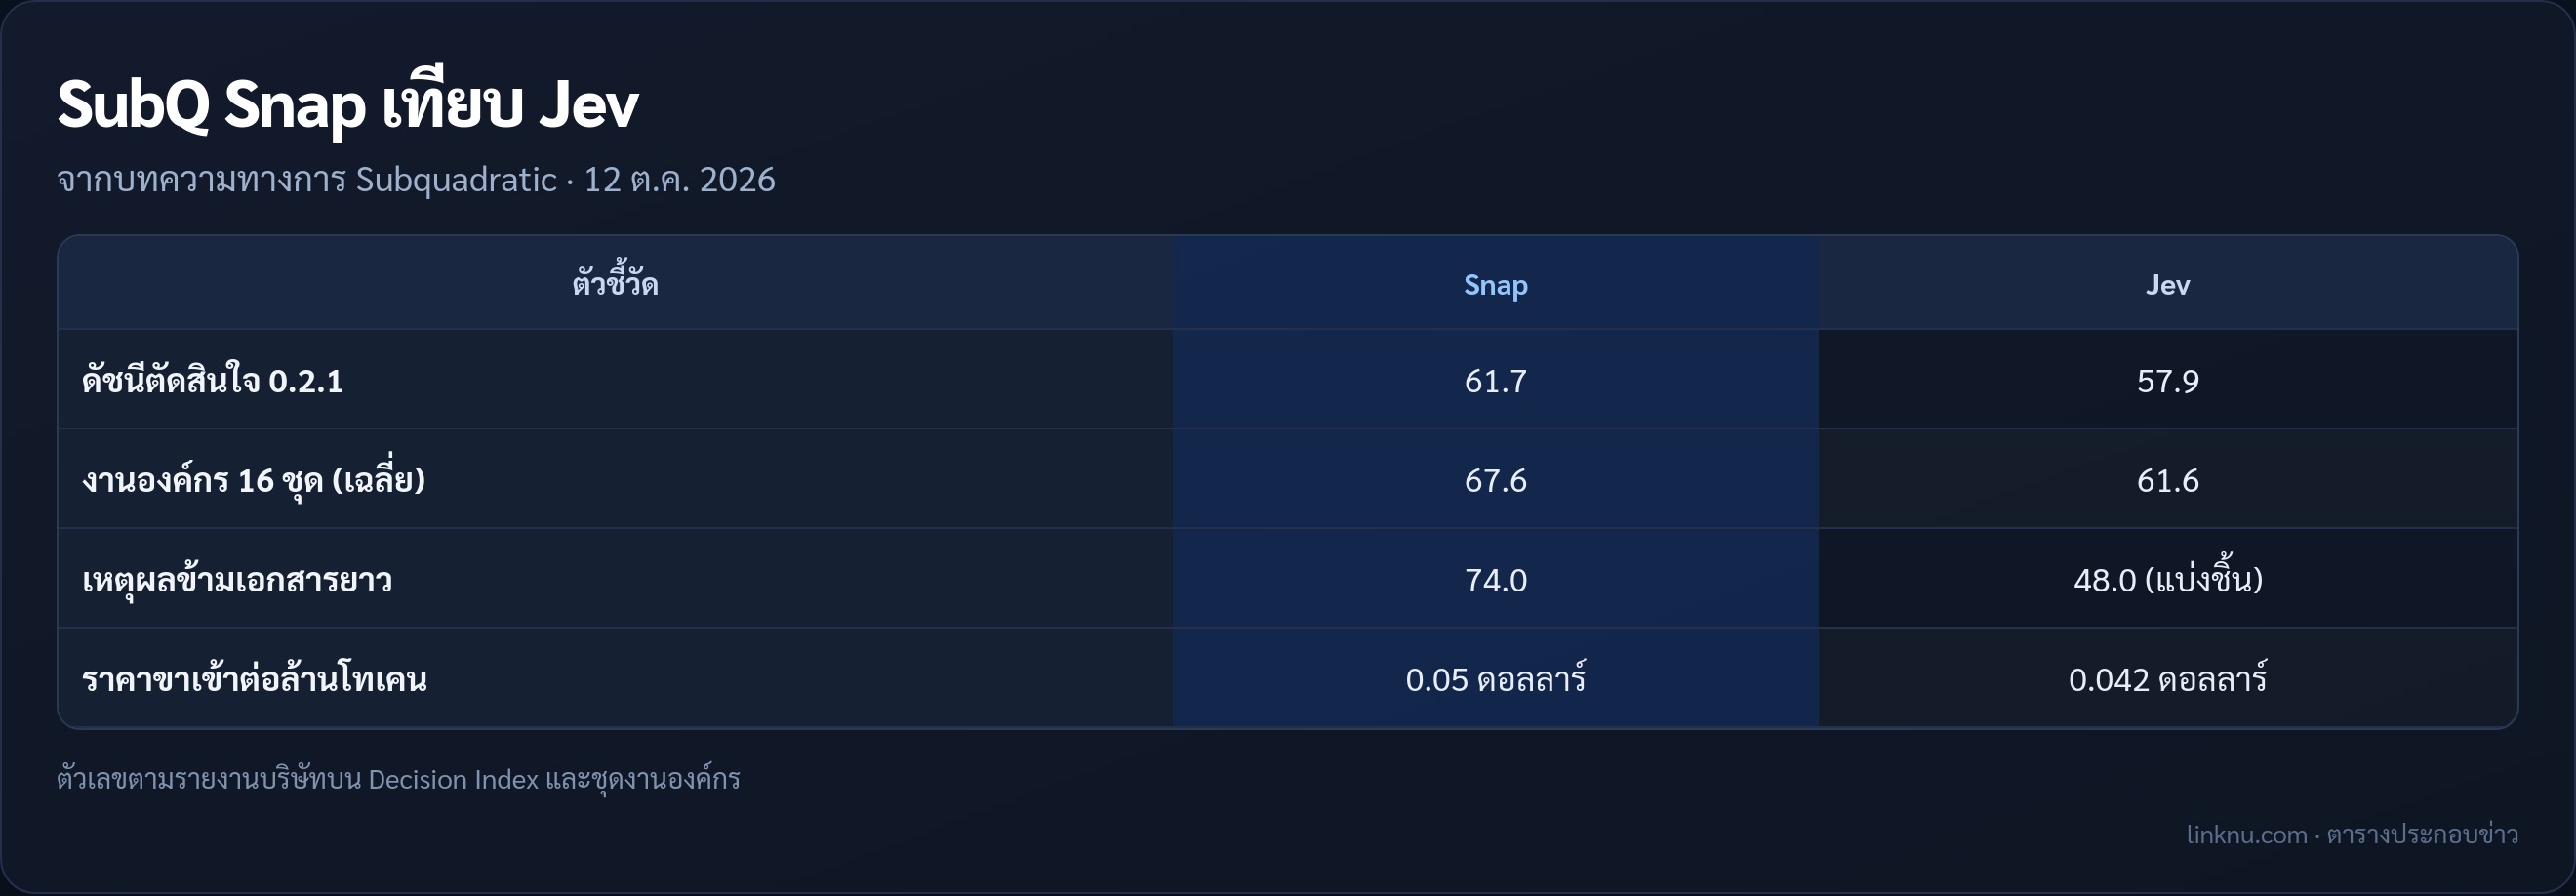
- คะแนนดัชนีตัดสินใจรุ่น 0.2.1 ได้ 61.7 เทียบกับ Jev ของ TypeSafe ที่ 57.9
- ในงานองค์กร 16 ชุด เฉลี่ย 67.6 ชนะ Jev ที่ 61.6 และนำ 13 จาก 16 งาน
- ราคา 0.05 ดอลลาร์ต่อล้านโทเคนขาเข้า ขาออกฟรี
ทำไมต้องมีโมเดลแบบนี้
งานเอเจนต์ส่วนใหญ่ไม่ใช่การเขียนเรียงความ แต่เป็นการเลือกไฟล์ที่เกี่ยวข้อง เลือกเครื่องมือถัดไป ตรวจผลทดสอบผ่านหรือไม่ หรือตัดสินว่าขั้นไหนต้องส่งให้โมเดลใหญ่ ถ้าโยนทุกขั้นให้โมเดลแนวหน้าทั้งก้อน ต้นทุนกับดีเลย์จะพุ่งเร็ว Snap เลยถูกออกแบบมาเป็นชั้นตัดสินใจราคาถูกและเร็ว คอยรับงานที่มีคำตอบจำกัด
ปัญหาเดิมของโมเดลตัดสินใจ
โมเดลตัดสินใจรุ่นก่อนมักจำกัดคอนเท็กซ์ราว 32K เพราะถ้าอ่านยาวแบบ dense attention ค่าคำนวณจะพุ่งแบบกำลังสอง พอคอนเท็กซ์ยาว ความเร็วที่เคยเป็นจุดขายก็หายไป ทางออกอย่างตัดข้อความหรือแบ่งชิ้นก็เสี่ยงตัดเงื่อนไขสำคัญทิ้ง Snap ใช้สถาปัตยกรรม SSA ที่บริษัทเปิดมาก่อนหน้านี้ ทำให้ต้นทุนการอ่านยาวขึ้นแบบเชิงเส้นมากขึ้น จึงยืดคอนเท็กซ์ได้โดยไม่เสียสปีดแบบเดิม
ผลทดสอบที่น่าสนใจ
- ชุดหาข้อมูลในข้อความยาว (Decision RULER) คะแนน 96.3–99.8 จาก 32K ถึง 1 ล้านโทเคน
- ชุดเหตุผลข้ามหลายเอกสารยาว 72K–115K ได้ 74.0 ส่วน Jev ที่ต้องแบ่งชิ้นได้ 48.0
- ในงานองค์กร นำชัดในจับฟิชชิ่ง (+22.0) ทำนายผลโค้ด (+16.7) ความรู้สึกข่าวการเงิน (+12.0) และตรวจสัญญา (+11.6)
- แพ้ Jev บางงานอย่าง When2Call และ API-Bank
เปิดใช้ยังไง
ตอนนี้อยู่ในพรีวิวสาธารณะแบบมาก่อนได้ก่อน ความจุจำกัด พอเต็มแล้วคนใหม่จะเข้าคิวรอ ส่วน SubQ 1.1 Small ซึ่งเป็นโมเดลภาษาทั่วไปของค่าย ยังเปิดให้พาร์ตเนอร์ที่คัดไว้เข้าใช้ก่อน
สรุป
Snap ไม่ได้มาแย่งงานเขียนข้อความจากโมเดลใหญ่ แต่มาแย่งงานตัดสินใจซ้ำ ๆ ในวงจรเอเจนต์ โดยอ่านคอนเท็กซ์ยาวได้จริงในราคาถูก ถ้าผ่านช่วงพรีวิวไปได้ดี ชั้นตัดสินใจยาวคอนเท็กซ์อาจกลายเป็นชิ้นมาตรฐานของสแต็กเอเจนต์องค์กร
แหล่ง: Subquadratic บทความทางการ Introducing SubQ Snap · 12 ต.ค. 2026 · https://subq.ai/introducing-subq-snap