มันทำงานยังไง
- ทำร่วมกับนักวิจัยจาก NYU, Inria และ Brown
- โมเดลจำลองโลกคือโมเดลที่เดาว่าถ้าลงมือทำแบบนี้ ภาพตรงหน้าจะเปลี่ยนไปยังไง แล้วเอาการเดานั้นมาใช้วางแผน
- H-JEPA ซ้อนโมเดลแบบนี้หลายชั้น ยิ่งชั้นสูงยิ่งเดาไปข้างหน้าไกลขึ้น และแต่ละชั้นมีวิธีสรุปภาพของตัวเอง
- เวลาวางแผน ชั้นบนสุดเล็งไปที่เป้าหมายก่อน แล้วส่งจุดแวะย่อยลงมาให้ชั้นล่าง ชั้นล่างสุดเป็นคนแปลงออกมาเป็นคำสั่งขยับจริง
- ชั้นบนจะทิ้งรายละเอียดที่เปลี่ยนเร็ว เช่น ท่าขาของหุ่นยนต์สี่ขา แต่ยังจำตำแหน่งตัวหุ่นกับผังเขาวงกตไว้
- โมเดลไม่ได้วาดภาพอนาคตออกมาทีละพิกเซลแบบโมเดลวิดีโอ แต่เดาในรูปข้อมูลสรุปย่อ เลยใช้แรงคำนวณตอนวางแผนน้อยกว่า
ตัวเลขจากเปเปอร์ของทีม
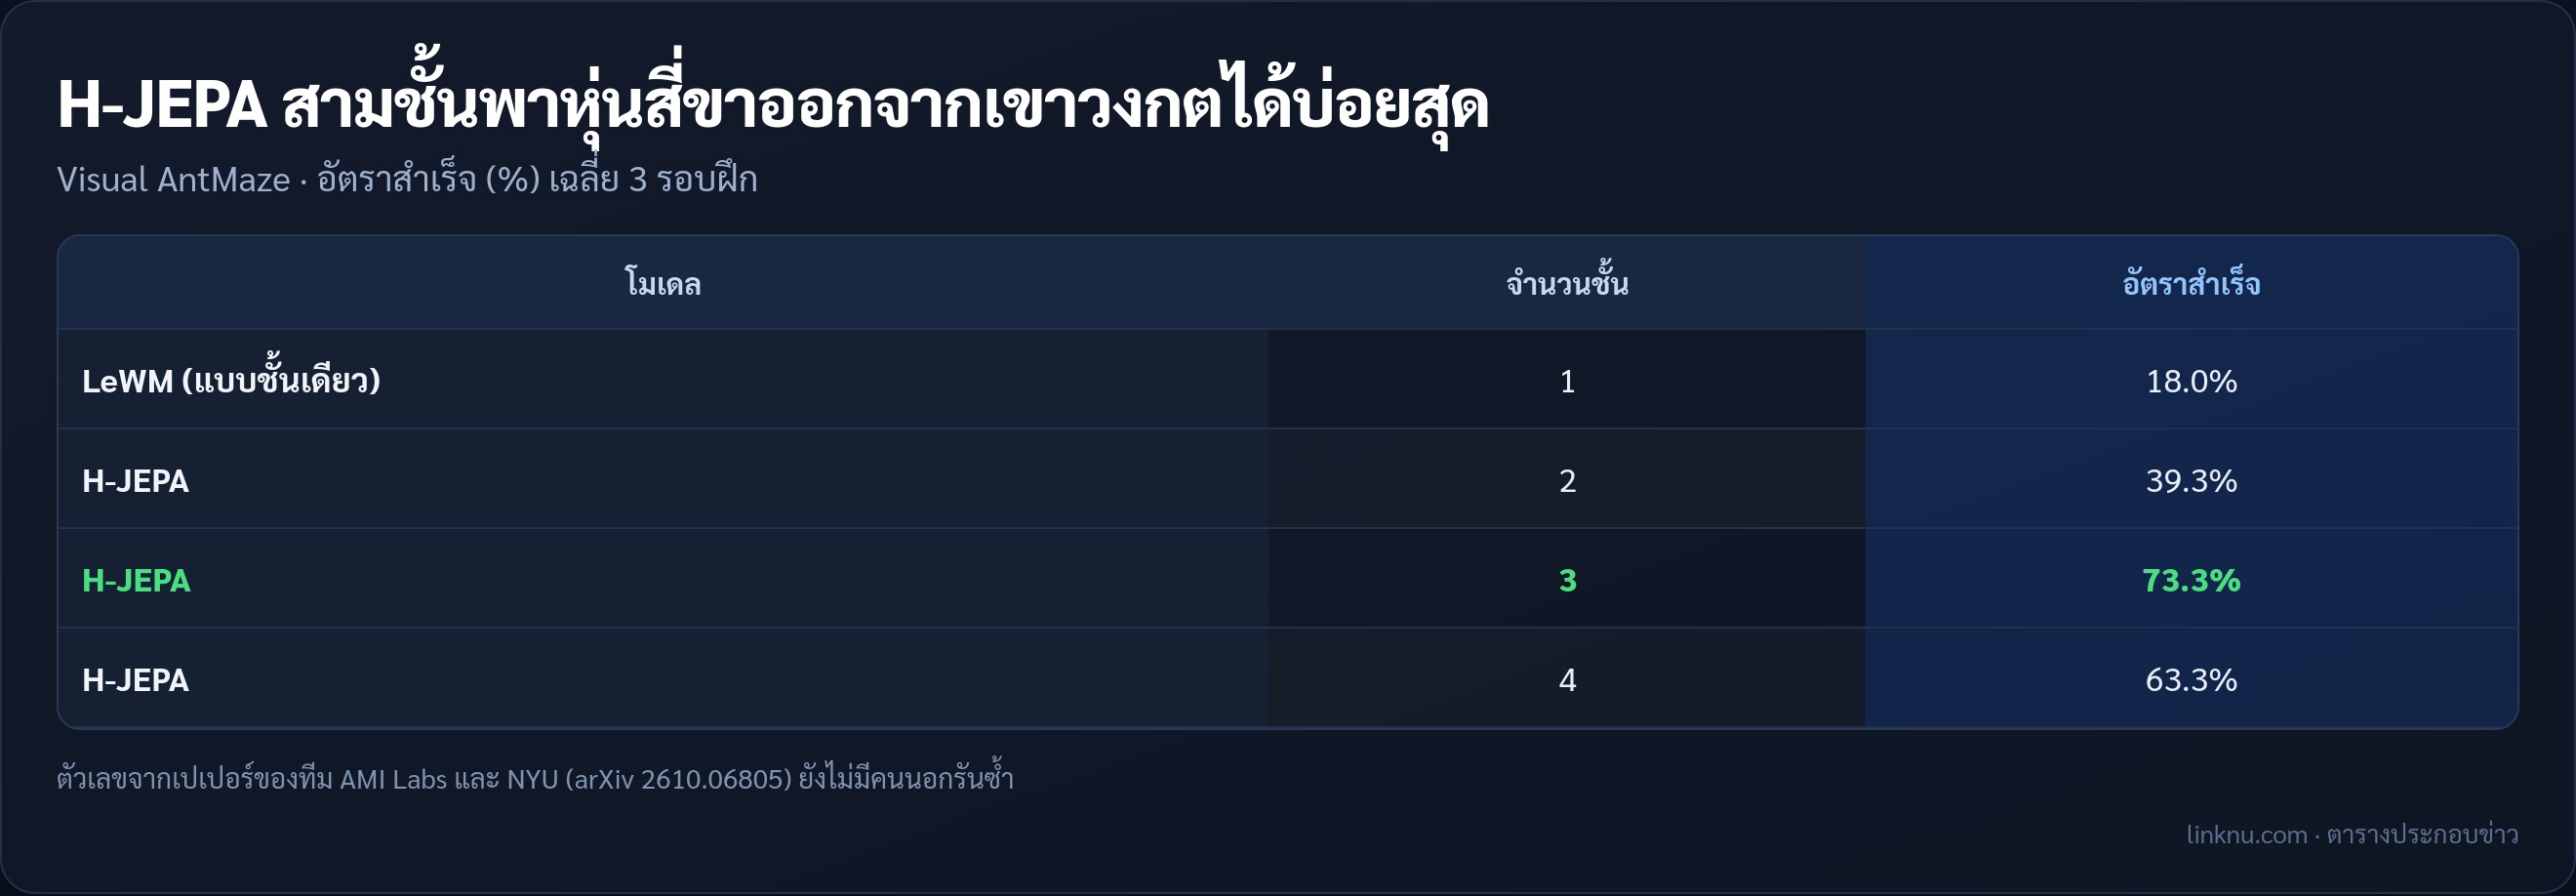
- เขาวงกตจำลอง Visual AntMaze โมเดลชั้นเดียว LeWM ทำสำเร็จ 18% แบบสองชั้นได้ 39.3% สามชั้นได้ 73.3% และสี่ชั้นได้ 63.3%
- ทีมวิจัยบอกว่าแบบสามชั้นได้ผลดีขึ้นทั้งที่ใช้การคำนวณตอนวางแผนน้อยกว่า
- งานเดินในห้อง FourRoom และงานหยิบลูกบาศก์ OGBench Cube ดีขึ้นเมื่อเพิ่มถึงสามชั้น
- งานดัน Push-T แบบสองชั้นดีกว่าชั้นเดียว แต่สามชั้นแย่ลง ทีมคาดว่าเพราะคลิปสั้นจนข้อมูลฝึกไม่พอ
- วิดีโอหุ่นยนต์จริงจากชุดข้อมูล DROID ใช้ทดสอบแบบย้อนหลังเท่านั้น โดยเทียบเส้นทางแขนกลกับเส้นทางที่คนบังคับ
โหลดไปลองได้ยังไง
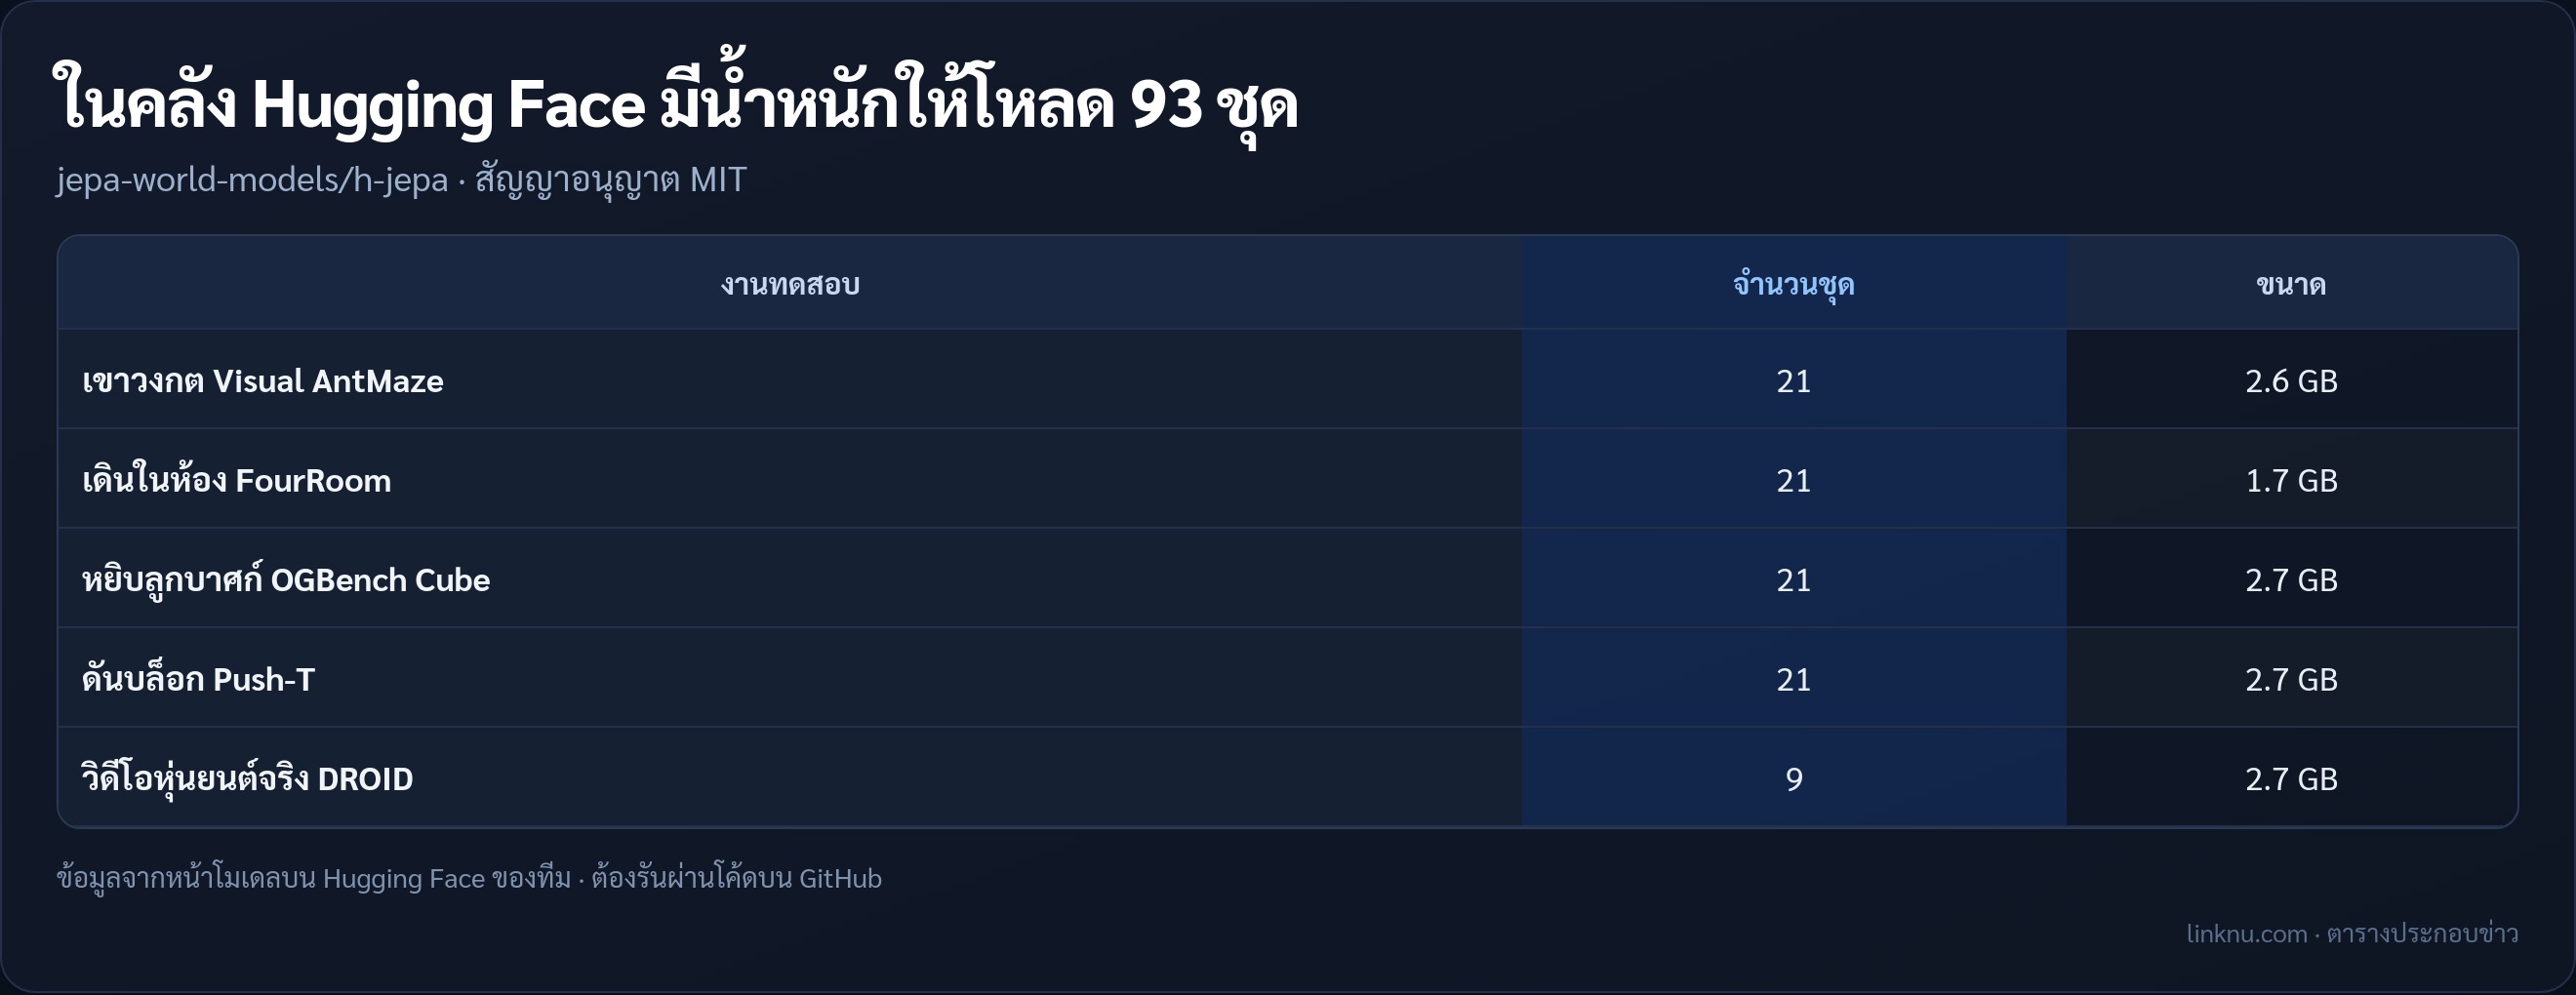
- น้ำหนักโมเดลอยู่บน Hugging Face ชื่อ jepa-world-models/h-jepa รวม 93 ชุด ขนาดราว 12 GB
- โค้ดอยู่บน GitHub ใช้สัญญาอนุญาต MIT เอาไปใช้ต่อหรือดัดแปลงได้
- ต้องรันผ่านโค้ดของทีมบน PyTorch ไม่ใช่แชตบอตที่เปิดมาคุยได้เลย
ข้อควรรู้
- นี่เป็นงานวิจัย ยังไม่มีแอปหรือบริการให้เรียกใช้
- ตัวเลขทั้งหมดมาจากเปเปอร์ของทีมเอง ทดสอบในโลกจำลองที่กล้องอยู่นิ่ง ยังไม่มีคนนอกรันซ้ำ
- AMI Labs ระดมทุนรอบแรกได้ 1.03 พันล้านดอลลาร์เมื่อเดือนมีนาคม 2026 เพื่อทำโมเดลแนวจำลองโลก แทนการพึ่งแชตบอตแบบเดาคำถัดไป
สรุป
H-JEPA ยังห่างจากหุ่นยนต์ที่ทำงานในบ้านจริงอีกไกล แต่ทำให้เห็นชัดขึ้นว่าแนวทาง "เดาโลก ไม่ใช่เดาคำ" ของ LeCun หน้าตาเป็นยังไง ใครทำหุ่นยนต์หรือเกมจำลองโหลดไปลองต่อได้ทันที
แหล่ง: AMI Labs, NYU (arXiv 2610.06805 · h-jepa.com · Hugging Face) · 5–10 ต.ค. 2026