โมเดลตระกูลนี้ไม่ได้มีไว้คุยแบบแชตบอต แต่ทำหน้าที่แปลงข้อมูลให้เป็นตัวเลขชุดหนึ่ง (embedding) เพื่อให้แอปค้นหาของที่ความหมายใกล้กันได้ เช่น ระบบค้นไฟล์ในเครื่อง หรือระบบ RAG ที่ดึงเอกสารมาให้โมเดลอีกตัวตอบ รุ่นแรกทำได้แค่ข้อความ ส่วนรุ่นใหม่นี้รับได้ทั้งข้อความ โค้ด รูป วิดีโอ และเสียง แล้วเอามาวางไว้ในพื้นที่เดียวกัน
จุดที่ควรรู้
- ขนาดรวม 740 ล้านพารามิเตอร์ สร้างบนสถาปัตยกรรม Gemma 4 แจกน้ำหนักให้โหลดฟรีแล้วบน Hugging Face และ Kaggle
- ใช้ไลเซนส์ Apache 2.0 เอาไปใช้ในงานเชิงพาณิชย์ได้
- แยกเป็นส่วนๆ ได้ ถ้าใช้แค่ข้อความ โหลดแค่ 270 ล้านพารามิเตอร์ก็พอ ส่วนตัวอ่านภาพ (170 ล้าน) และตัวอ่านเสียง (300 ล้าน) จะโหลดเพิ่มเมื่อต้องการ
- รับ context ได้ 8,192 โทเคน มากกว่ารุ่นแรก 4 เท่า ใส่เสียงยาวได้ราว 5 นาทีครึ่ง หรือรูปได้ 29 รูป หรือเฟรมวิดีโอ 58 เฟรม
- ถ้าบีบโมเดลให้เล็กลง บน Pixel 11 Pro ใช้แรมราว 191MB สำหรับข้อความอย่างเดียว และราว 567MB เมื่อเปิดครบทุกแบบ
- เวกเตอร์ปกติยาว 768 มิติ ตัดให้สั้นเหลือ 512, 256 หรือ 128 มิติได้ ประหยัดที่เก็บได้สูงสุดราว 6 เท่า
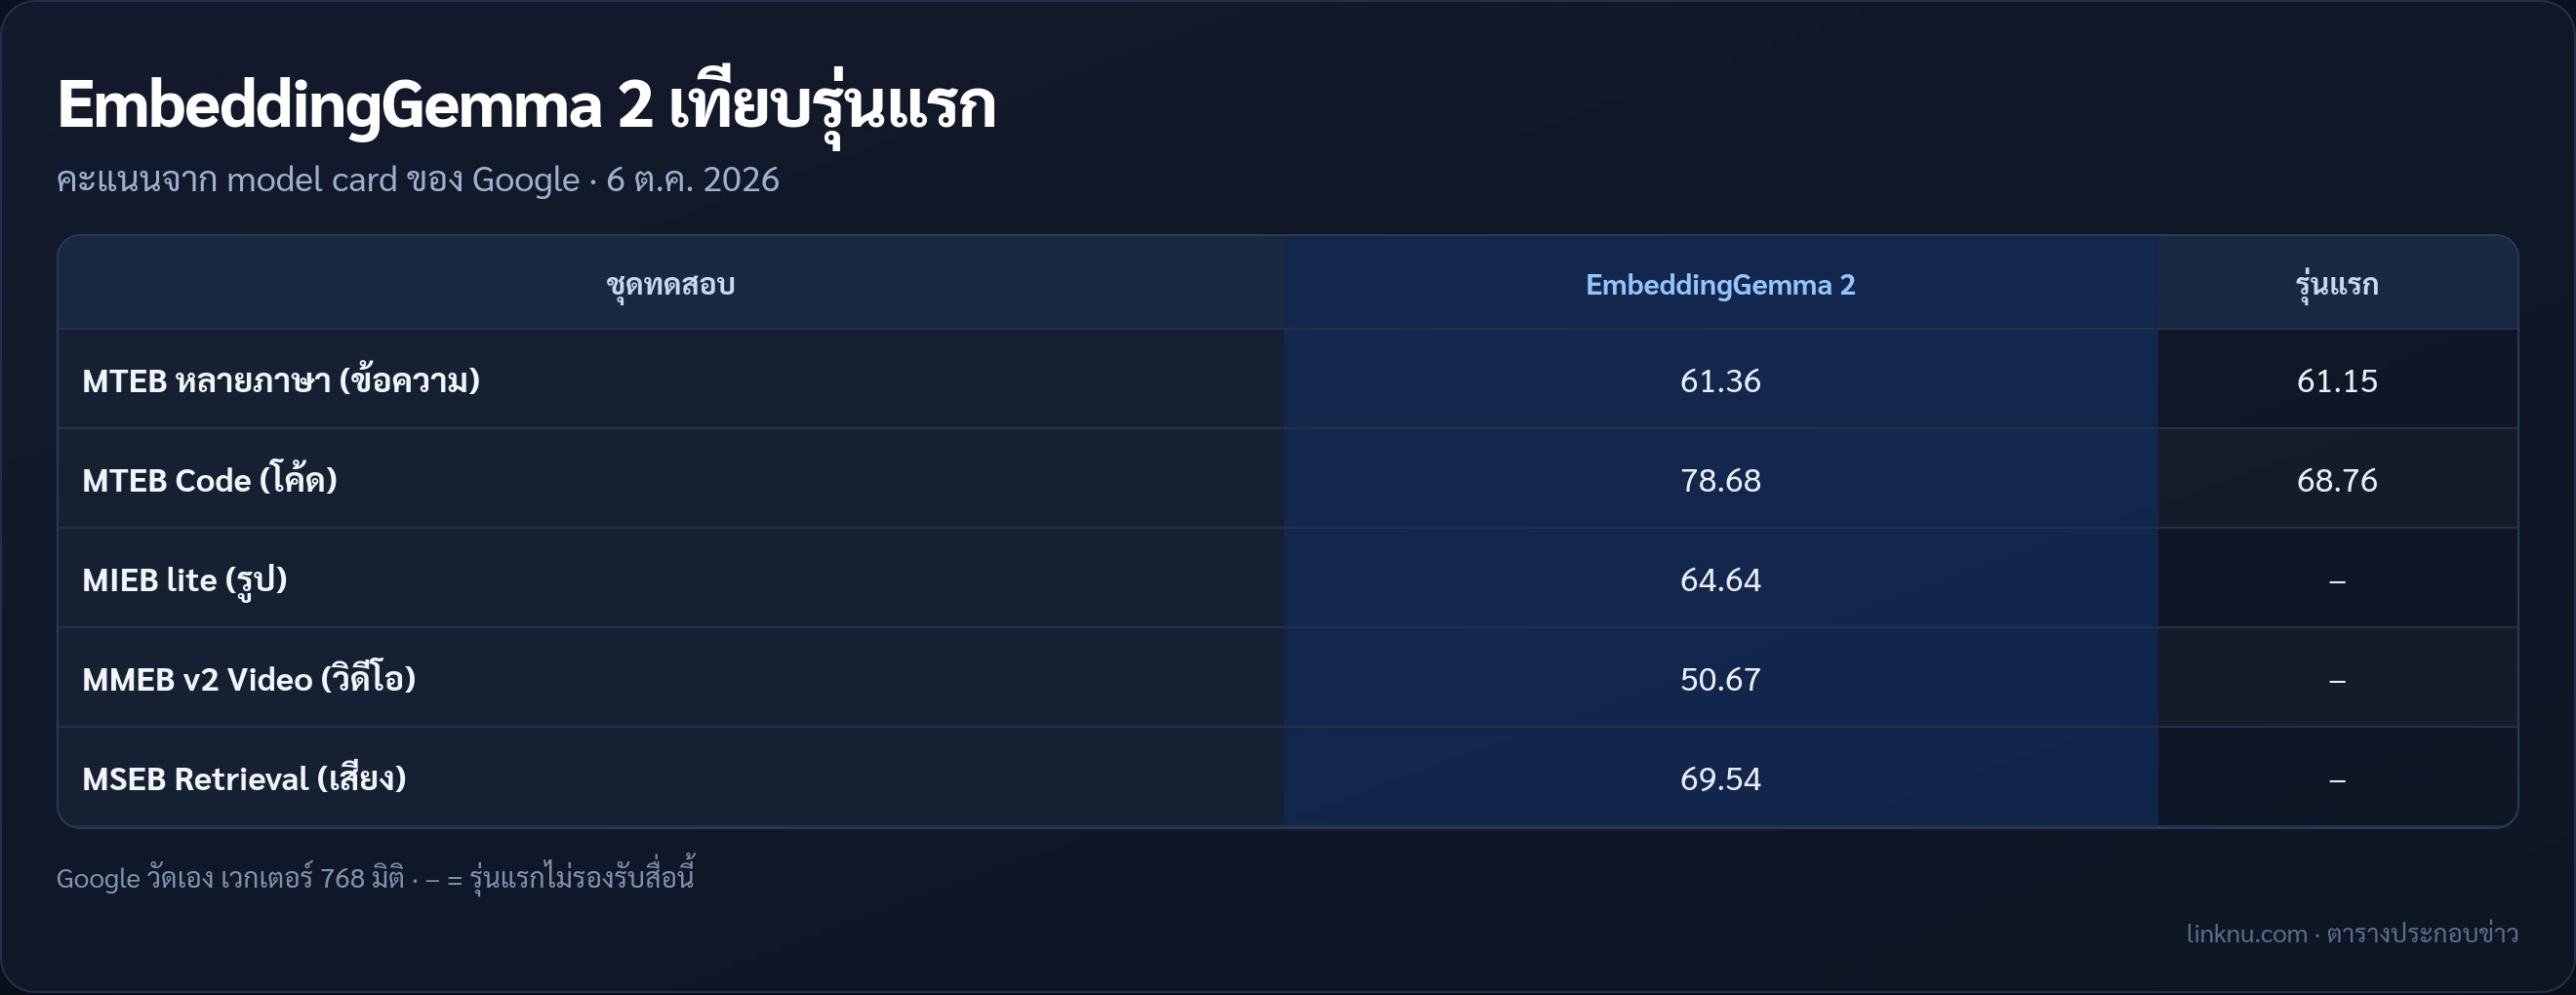
- คะแนนงานค้นโค้ด (MTEB Code) ขึ้นจาก 68.76 เป็น 78.68 ส่วนงานข้อความหลายภาษาใกล้เดิม 61.36 เทียบกับ 61.15 ของรุ่นแรก
- ใช้ร่วมกับเครื่องมือที่คนใช้กันอยู่ได้ทันที เช่น transformers, sentence-transformers, vLLM, llama.cpp, Ollama และ LM Studio
อย่าเข้าใจผิด
- นี่ไม่ใช่โมเดลแชตหรือโมเดลสร้างคำตอบ ต้องใช้คู่กับโมเดลอีกตัว เช่น Gemma 4 ถ้าอยากได้ระบบถามตอบ
- ตัวเลขคะแนนทั้งหมดมาจาก Google เอง ยังไม่มีคนนอกวัดซ้ำ
- บน Model Garden ของ Google Cloud ยังไม่มีให้ใช้ บริษัทบอกว่าจะตามมาเร็วๆ นี้
สรุป
เป็นของที่นักพัฒนาแอปบนมือถือหรือคนทำระบบค้นหาในเครื่องน่าจะได้ใช้จริง เพราะตัวเล็ก ฟรี เอาไปใช้เชิงพาณิชย์ได้ และค้นข้ามสื่อได้ในโมเดลเดียว เช่น พิมพ์ข้อความหาคลิปวิดีโอ หรืออัดเสียงหาไฟล์ที่ต้องการ โดยไม่ต้องส่งข้อมูลออกไปนอกเครื่อง
แหล่ง: Google Blog (blog.google) และ model card บน Hugging Face · 6 ต.ค. 2026