ตอนนี้ยังโหลดไม่ได้นะ บริษัทบอกว่ากำลังทำ red-teaming กับประเมินรอบสุดท้าย เปิดให้ลงชื่อขอใช้ก่อนได้ ส่วนน้ำหนักโมเดล รายงานเทคนิค และ model card จะตามมาภายในเดือนนี้
จุดที่ควรรู้
- เป็นโมเดล Mixture-of-Experts ขนาดรวม 501 พันล้านพารามิเตอร์ แต่ใช้งานจริงแค่ 23 พันล้านต่อครั้ง
- เทรนล่วงหน้าด้วยข้อมูล 23.8 ล้านล้านโทเคน ทั้งจากเว็บและชุดข้อมูลที่ซื้อลิขสิทธิ์มา
- รอบ reinforcement learning ใช้ GPU NVIDIA GB300 ราว 10,500 ตัว นาน 4 สัปดาห์ สร้าง rollout มากกว่า 100 ล้านครั้ง ใช้ sandbox ประมาณ 1.3 พันล้านตัวในการเทรนและตรวจคะแนน
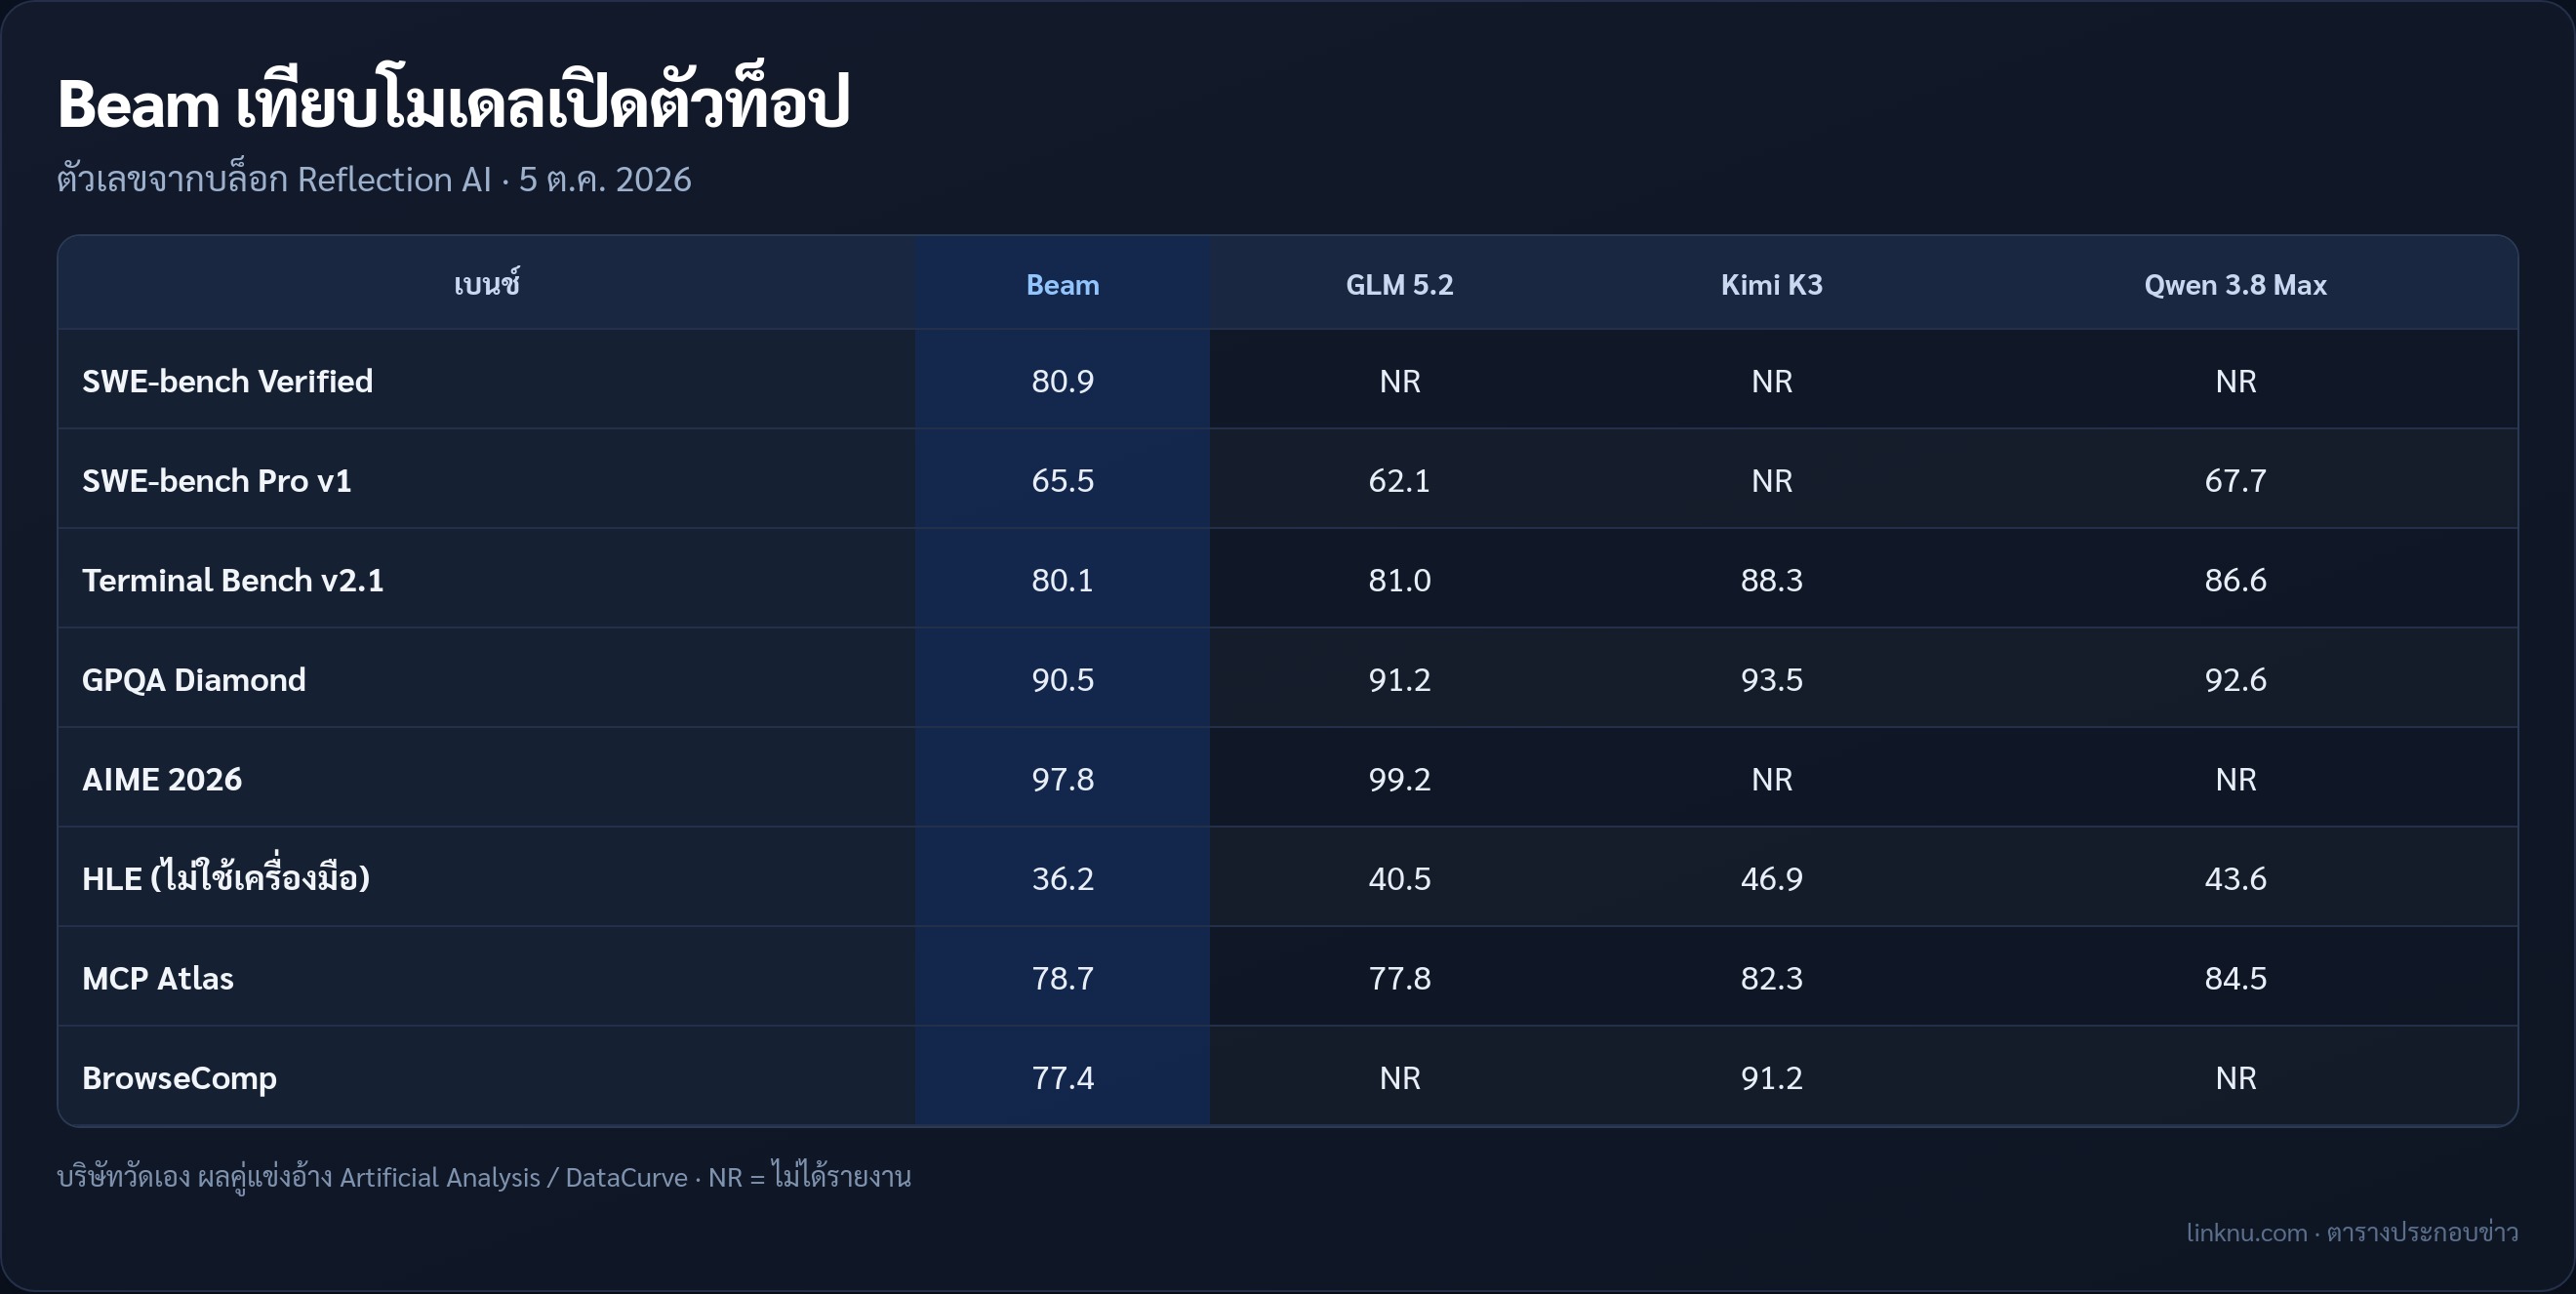
- คะแนนที่บริษัทรายงานเอง SWE-bench Verified 80.9, SWE-bench Pro v1 65.5, Terminal Bench v2.1 80.1, GPQA Diamond 90.5 และ AIME 2026 ได้ 97.8
- บริษัทเทียบว่าเก่งพอๆ กับ GLM-5.2 ในงานให้เหตุผล แต่ใช้พลังประมวลผลตอนรันน้อยกว่า 3–4 เท่า และเข้าใกล้ Qwen 3.8-Max ในงานโค้ดกับเอเจนต์
- บริษัทยอมรับเองว่า Kimi K3 ยังนำอยู่ถ้าวัดความสามารถดิบ จุดขายของ Beam คือความคุ้มตอนใช้งาน
อย่าเข้าใจผิด
- วันนี้เป็นการประกาศตัว ยังไม่ได้ปล่อยน้ำหนักให้โหลด และยังไม่มีราคา API ออกมา
- ตัวเลขเบนช์ทั้งหมดมาจากบริษัท บางตัวเอาผลของคู่แข่งมาจาก Artificial Analysis กับ DataCurve ยังไม่มีคนนอกวัดซ้ำ
- ตัวเลข 256K ในบล็อกคือความยาวสูงสุดของ rollout ตอนเทรน RL ไม่ได้บอกว่าเป็น context window ของโมเดลตอนใช้งาน
สรุป
Beam เป็นความพยายามของแล็บฝั่งสหรัฐที่จะทำโมเดลเปิดมาสู้กับโมเดลจีนอย่าง GLM, Qwen และ Kimi ใครทำงานโค้ดหรือเอเจนต์ในองค์กรน่าจะลองจับตา รอดูตอนปล่อยน้ำหนักจริงปลายเดือนนี้ว่าคะแนนจะยืนได้แค่ไหน
แหล่ง: Reflection AI blog (reflection.ai/blog/introducing-beam) · 5 ต.ค. 2026