งานแบบนี้เหมาะกับการคัดแยกตั๋วแจ้งปัญหา ส่งเรื่องให้ทีมที่ถูก หรือกรองเนื้อหา โปรแกรมเอาตัวเลขไปตั้งเกณฑ์ต่อได้เลย ไม่ต้องมาแกะข้อความ วันนี้เรียกผ่าน API ได้แล้ว และโหลดน้ำหนักไปรันเองได้ฟรีบน Hugging Face
สิ่งที่บริษัทประกาศ
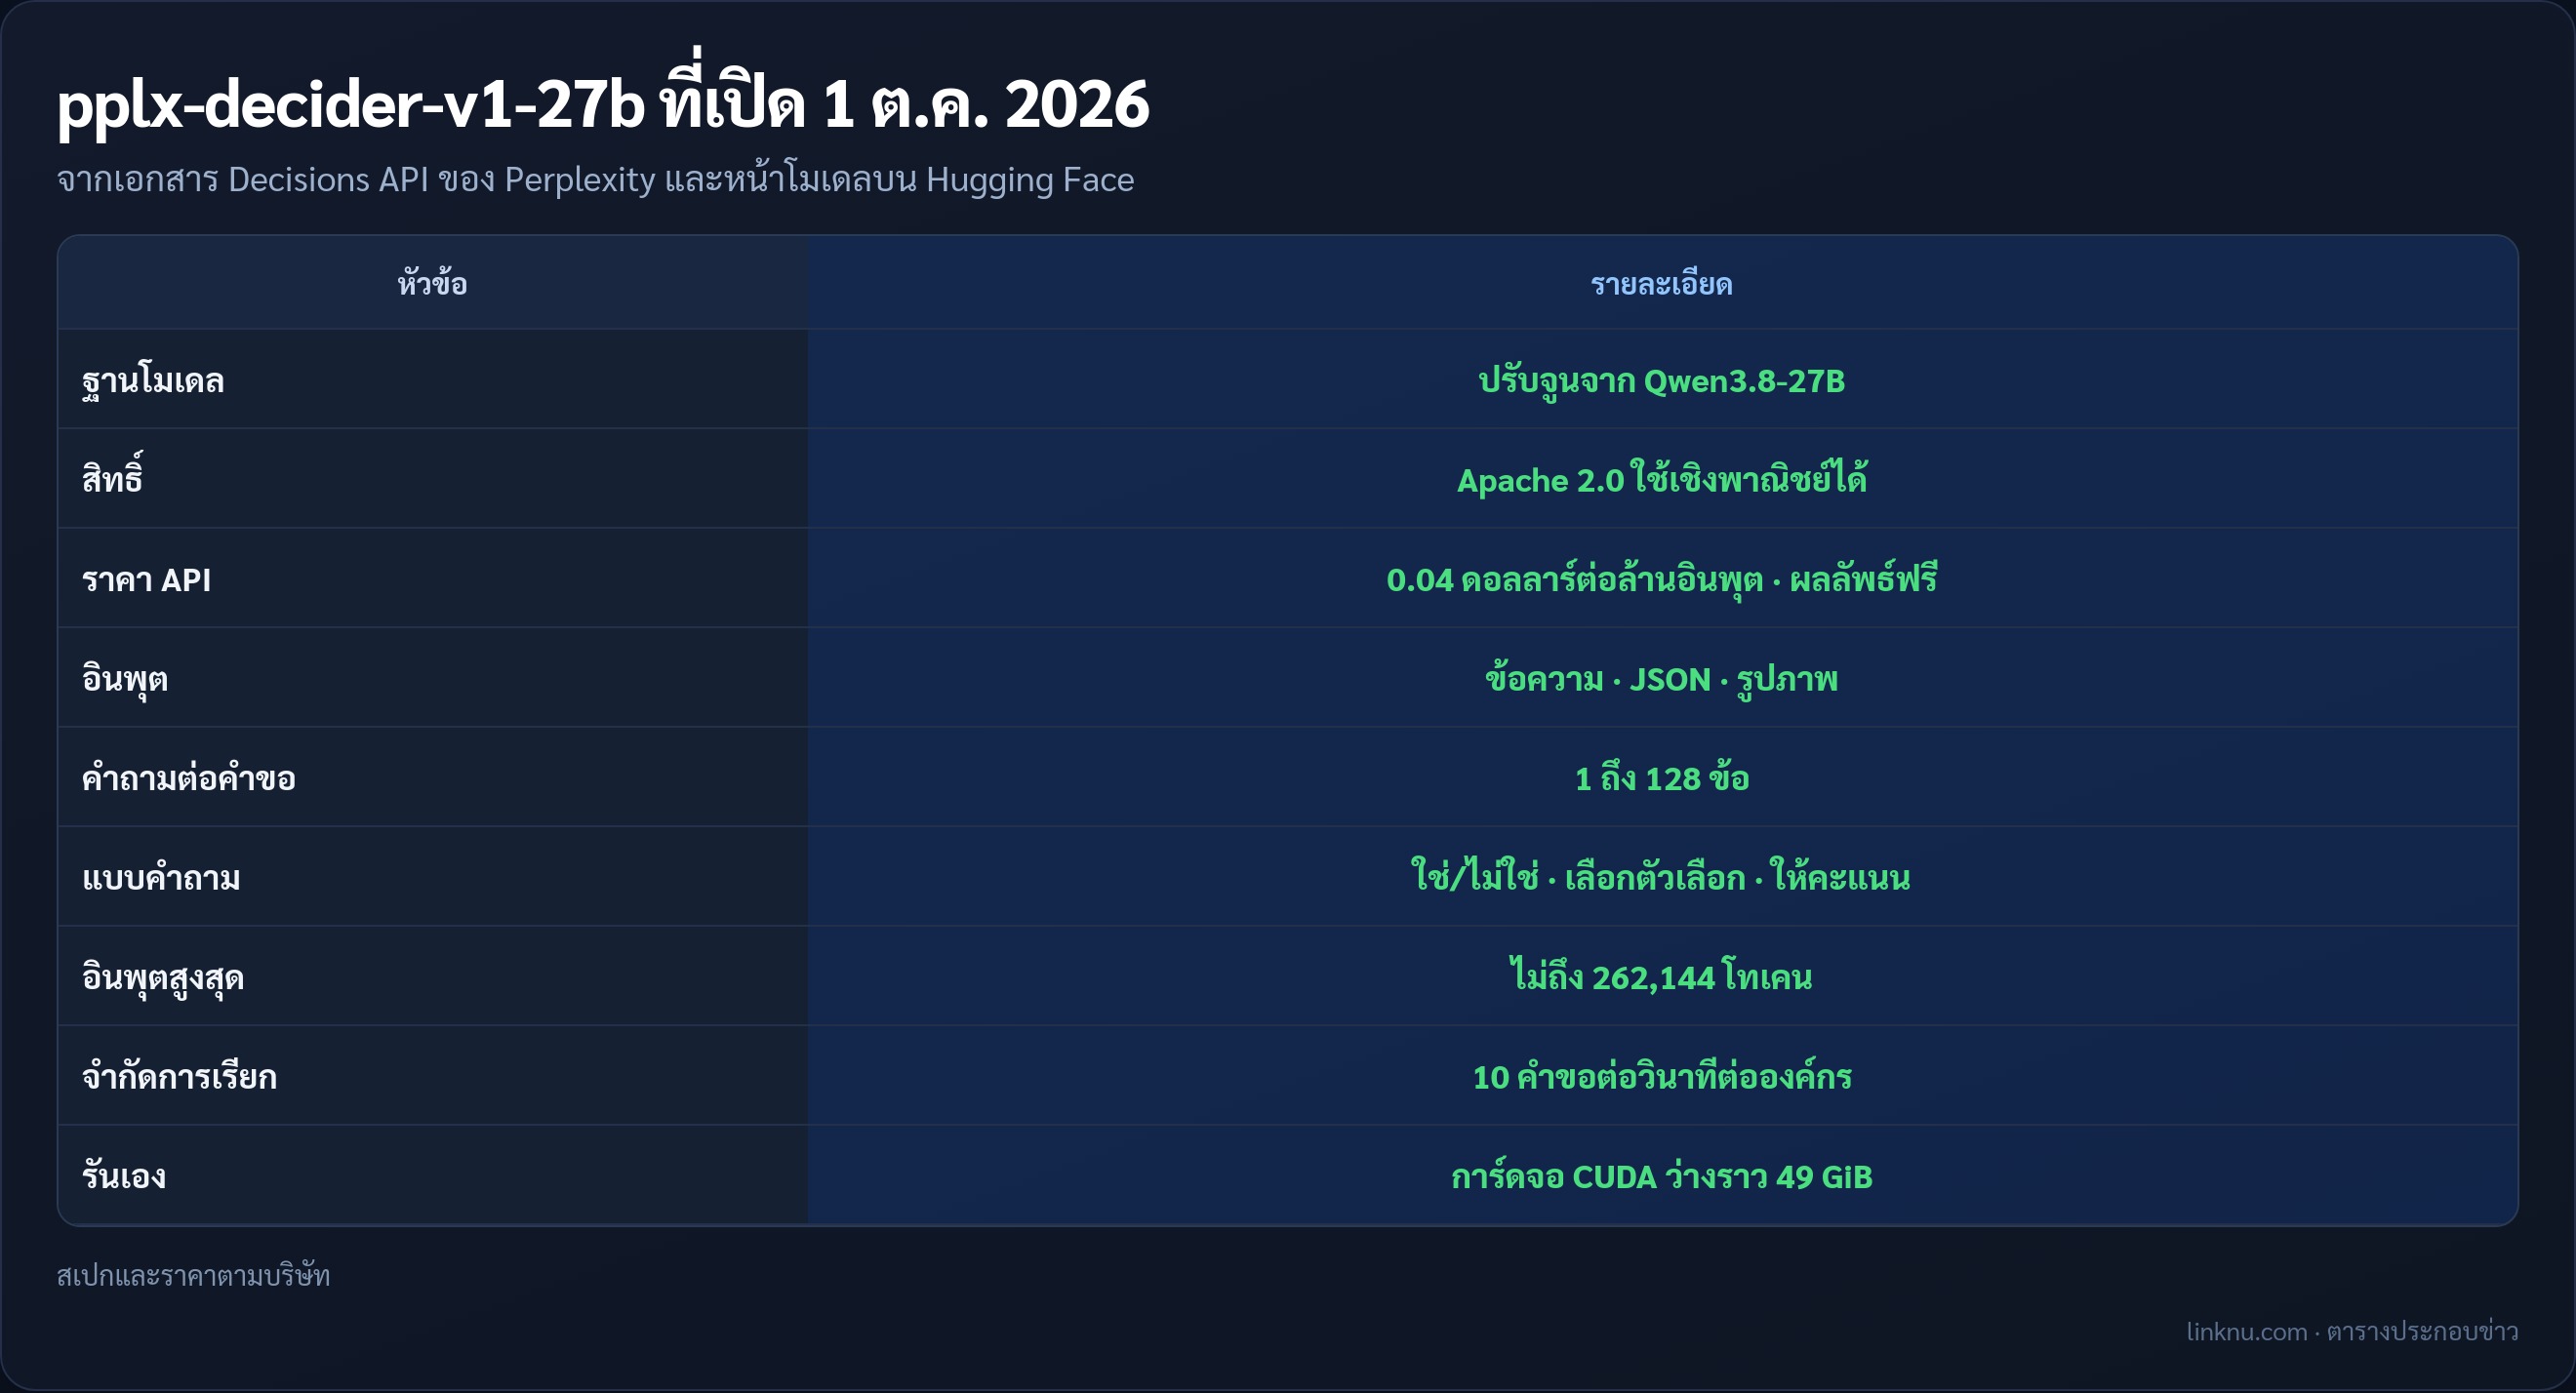
- ปรับจูนมาจาก Qwen3.8-27B สิทธิ์ Apache 2.0 ใช้เชิงพาณิชย์ได้
- รับได้ทั้งข้อความ JSON และรูปภาพ
- ถามได้ 1 ถึง 128 คำถามในคำขอเดียว มีสามแบบ คือ ใช่หรือไม่ใช่ เลือกจากตัวเลือก และให้คะแนนตามเกณฑ์
- อินพุตต่อคำขอต้องไม่ถึง 262,144 โทเคน
- ค่าอินพุต 0.04 ดอลลาร์ต่อล้านโทเคน ผลลัพธ์ไม่คิดเงิน และไม่มีค่าต่อคำขอ
- จำกัด 10 คำขอต่อวินาทีต่อองค์กร ทุกแพ็กเกจ
- ถ้ารันเอง ต้องมีการ์ดจอ CUDA ที่มีที่ว่างราว 49 GiB สำหรับน้ำหนัก บวกหน่วยความจำตอนทำงาน
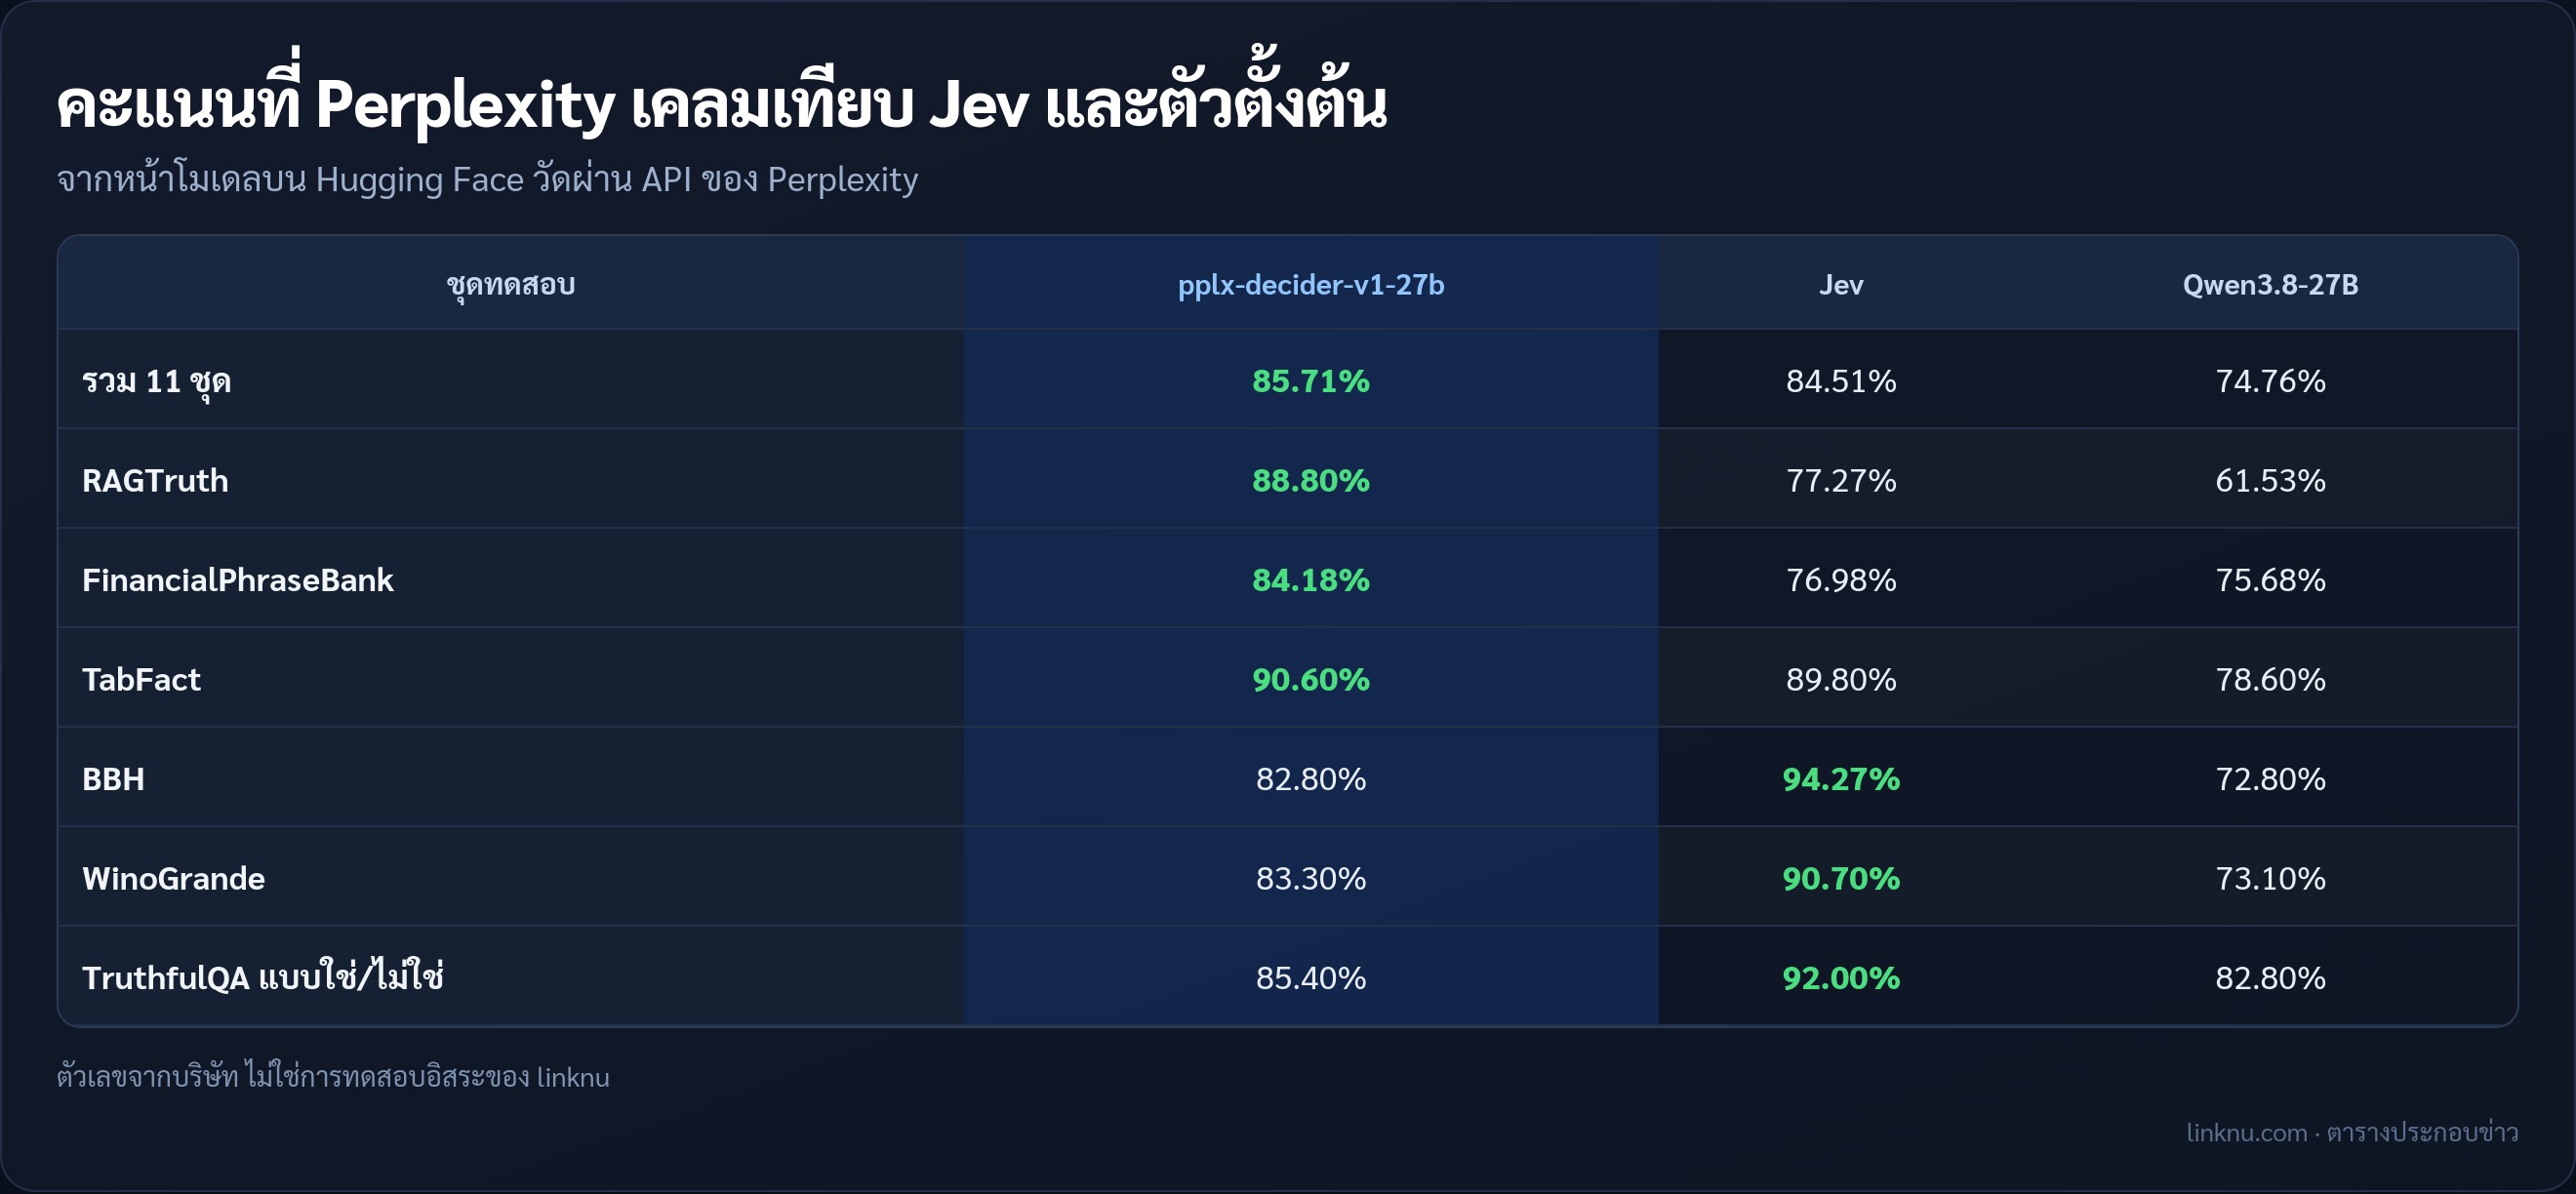
คะแนนที่บริษัทเคลม (ไม่ใช่การทดสอบอิสระของ linknu)
- รวม 11 ชุดทดสอบได้ 85.71% สูงกว่า Jev ของ TypeSafe AI ที่ 84.51% และสูงกว่า Qwen3.8-27B ตัวตั้งต้นที่ 74.76%
- เด่นสุดใน RAGTruth ชุดจับคำตอบที่แต่งขึ้นเอง ได้ 88.80% ส่วน Jev ได้ 77.27%
- แต่ยังแพ้ Jev หลายชุด เช่น BBH 82.80% ต่อ 94.27% และ WinoGrande 83.30% ต่อ 90.70%
- Perplexity วัดคะแนนพวกนี้ผ่าน API ของตัวเอง
ใครควรลอง
- ทีมที่ใช้โมเดลแชทตัวใหญ่แค่เพื่อติดป้าย คัดแยก หรือให้คะแนน แล้วอยากลดค่าใช้จ่าย
- คนทำระบบเอเจนต์ที่อยากมีด่านคัดกรองก่อนส่งงานยากไปให้โมเดลใหญ่
สรุป
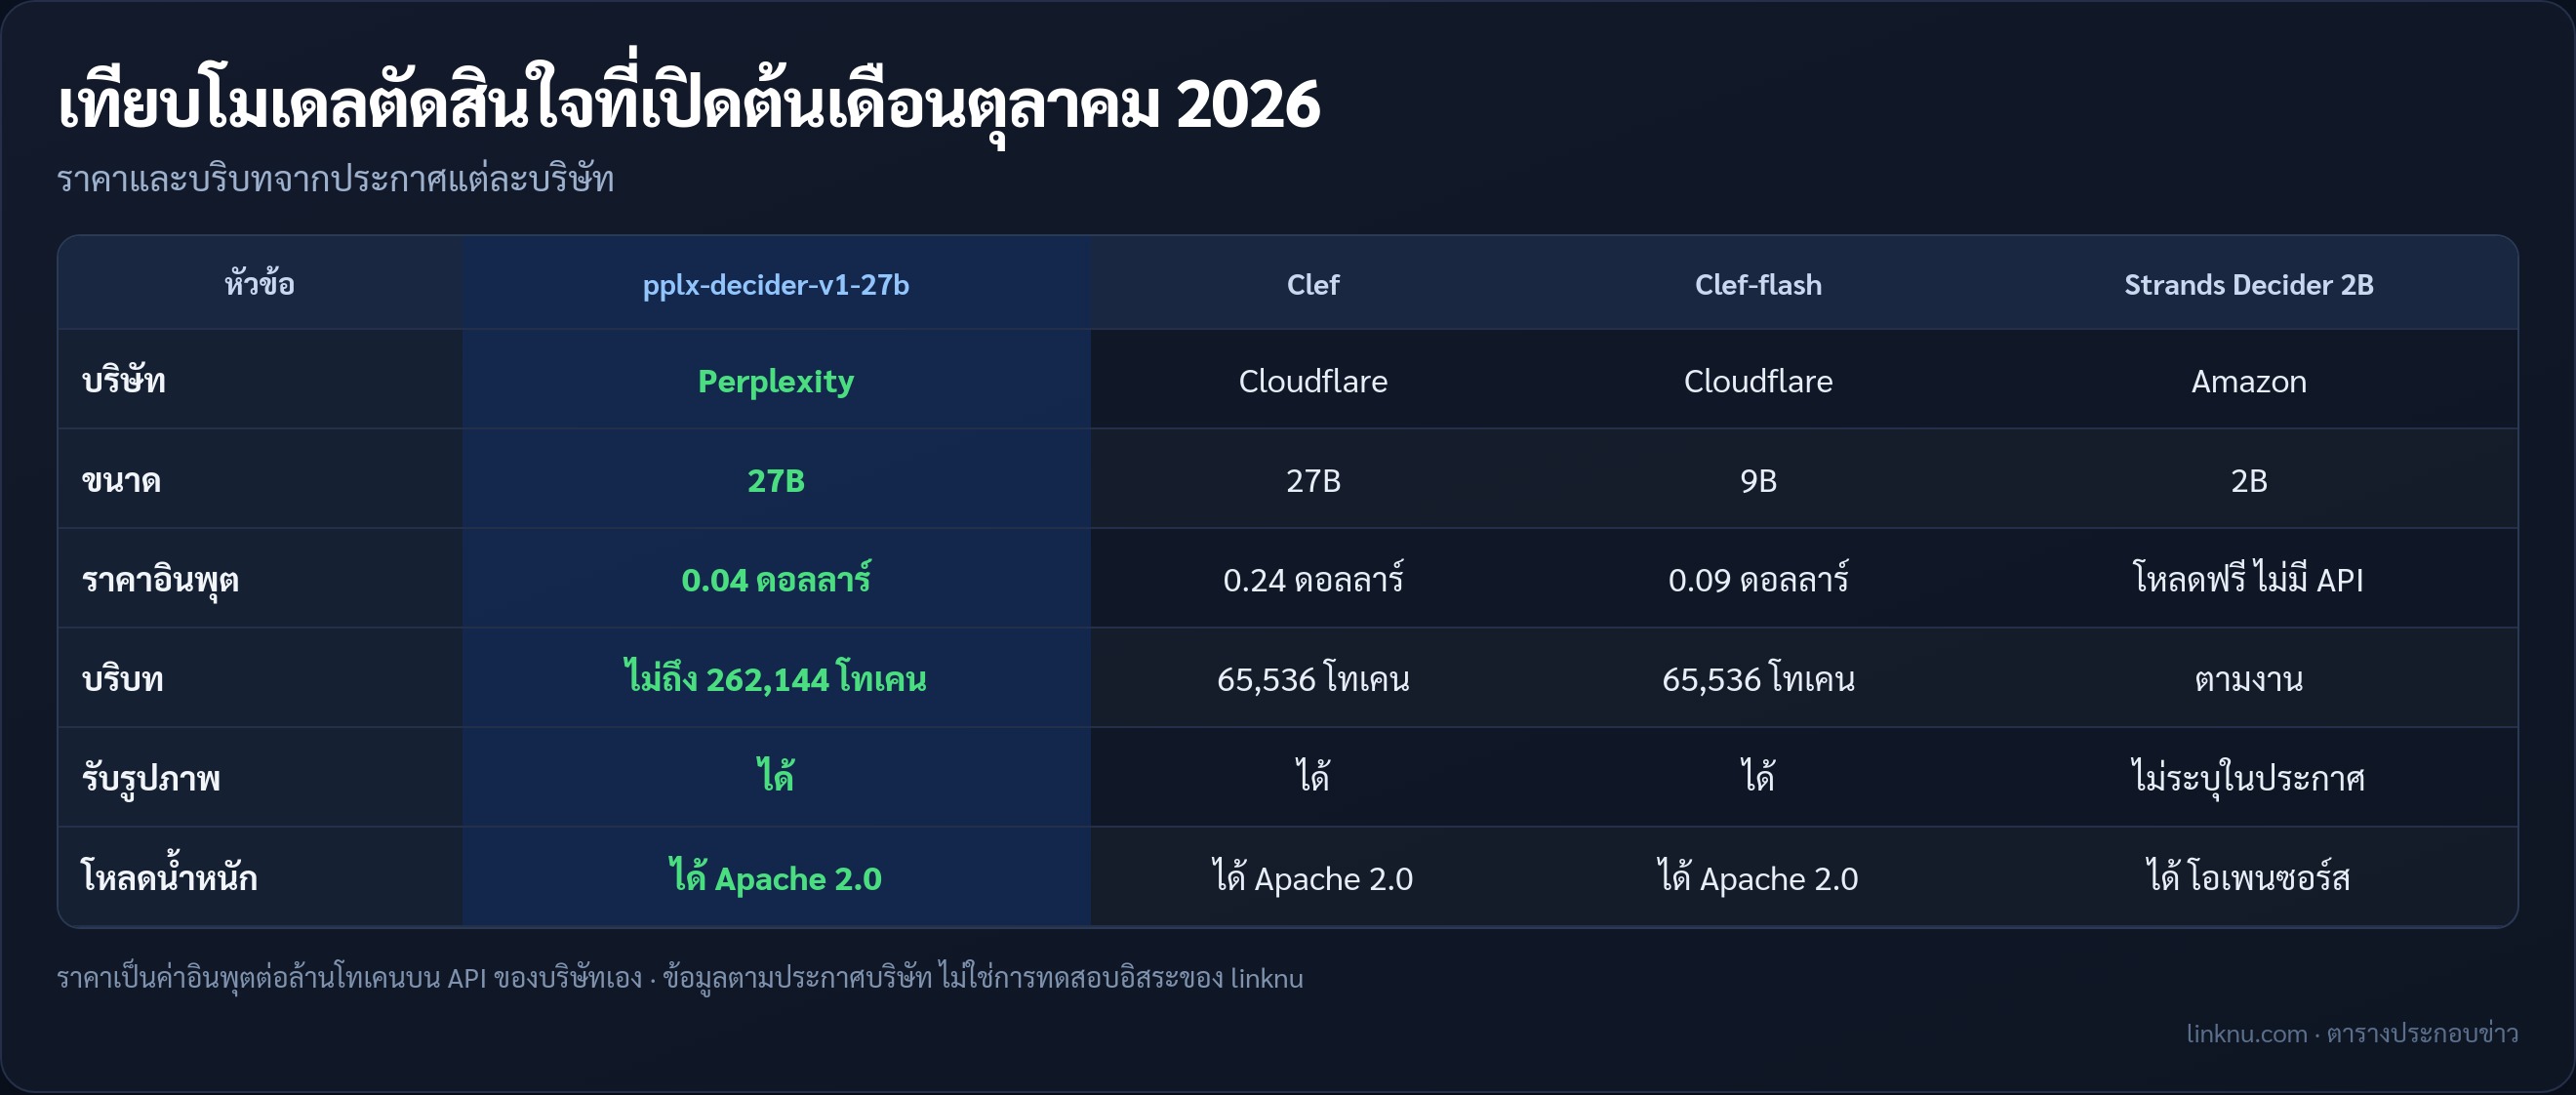
ต้นเดือนนี้มีโมเดลตัดสินใจออกมาติด ๆ กัน ทั้ง Clef ของ Cloudflare, Strands Decider ของ Amazon และตัวนี้ของ Perplexity ถ้างานของคุณคือเลือกคำตอบจากตัวเลือกที่กำหนดไว้แล้ว ลองเทียบราคากับความแม่นบนข้อมูลของตัวเองก่อนย้ายระบบ
แหล่ง: Perplexity · 1 ต.ค. 2026