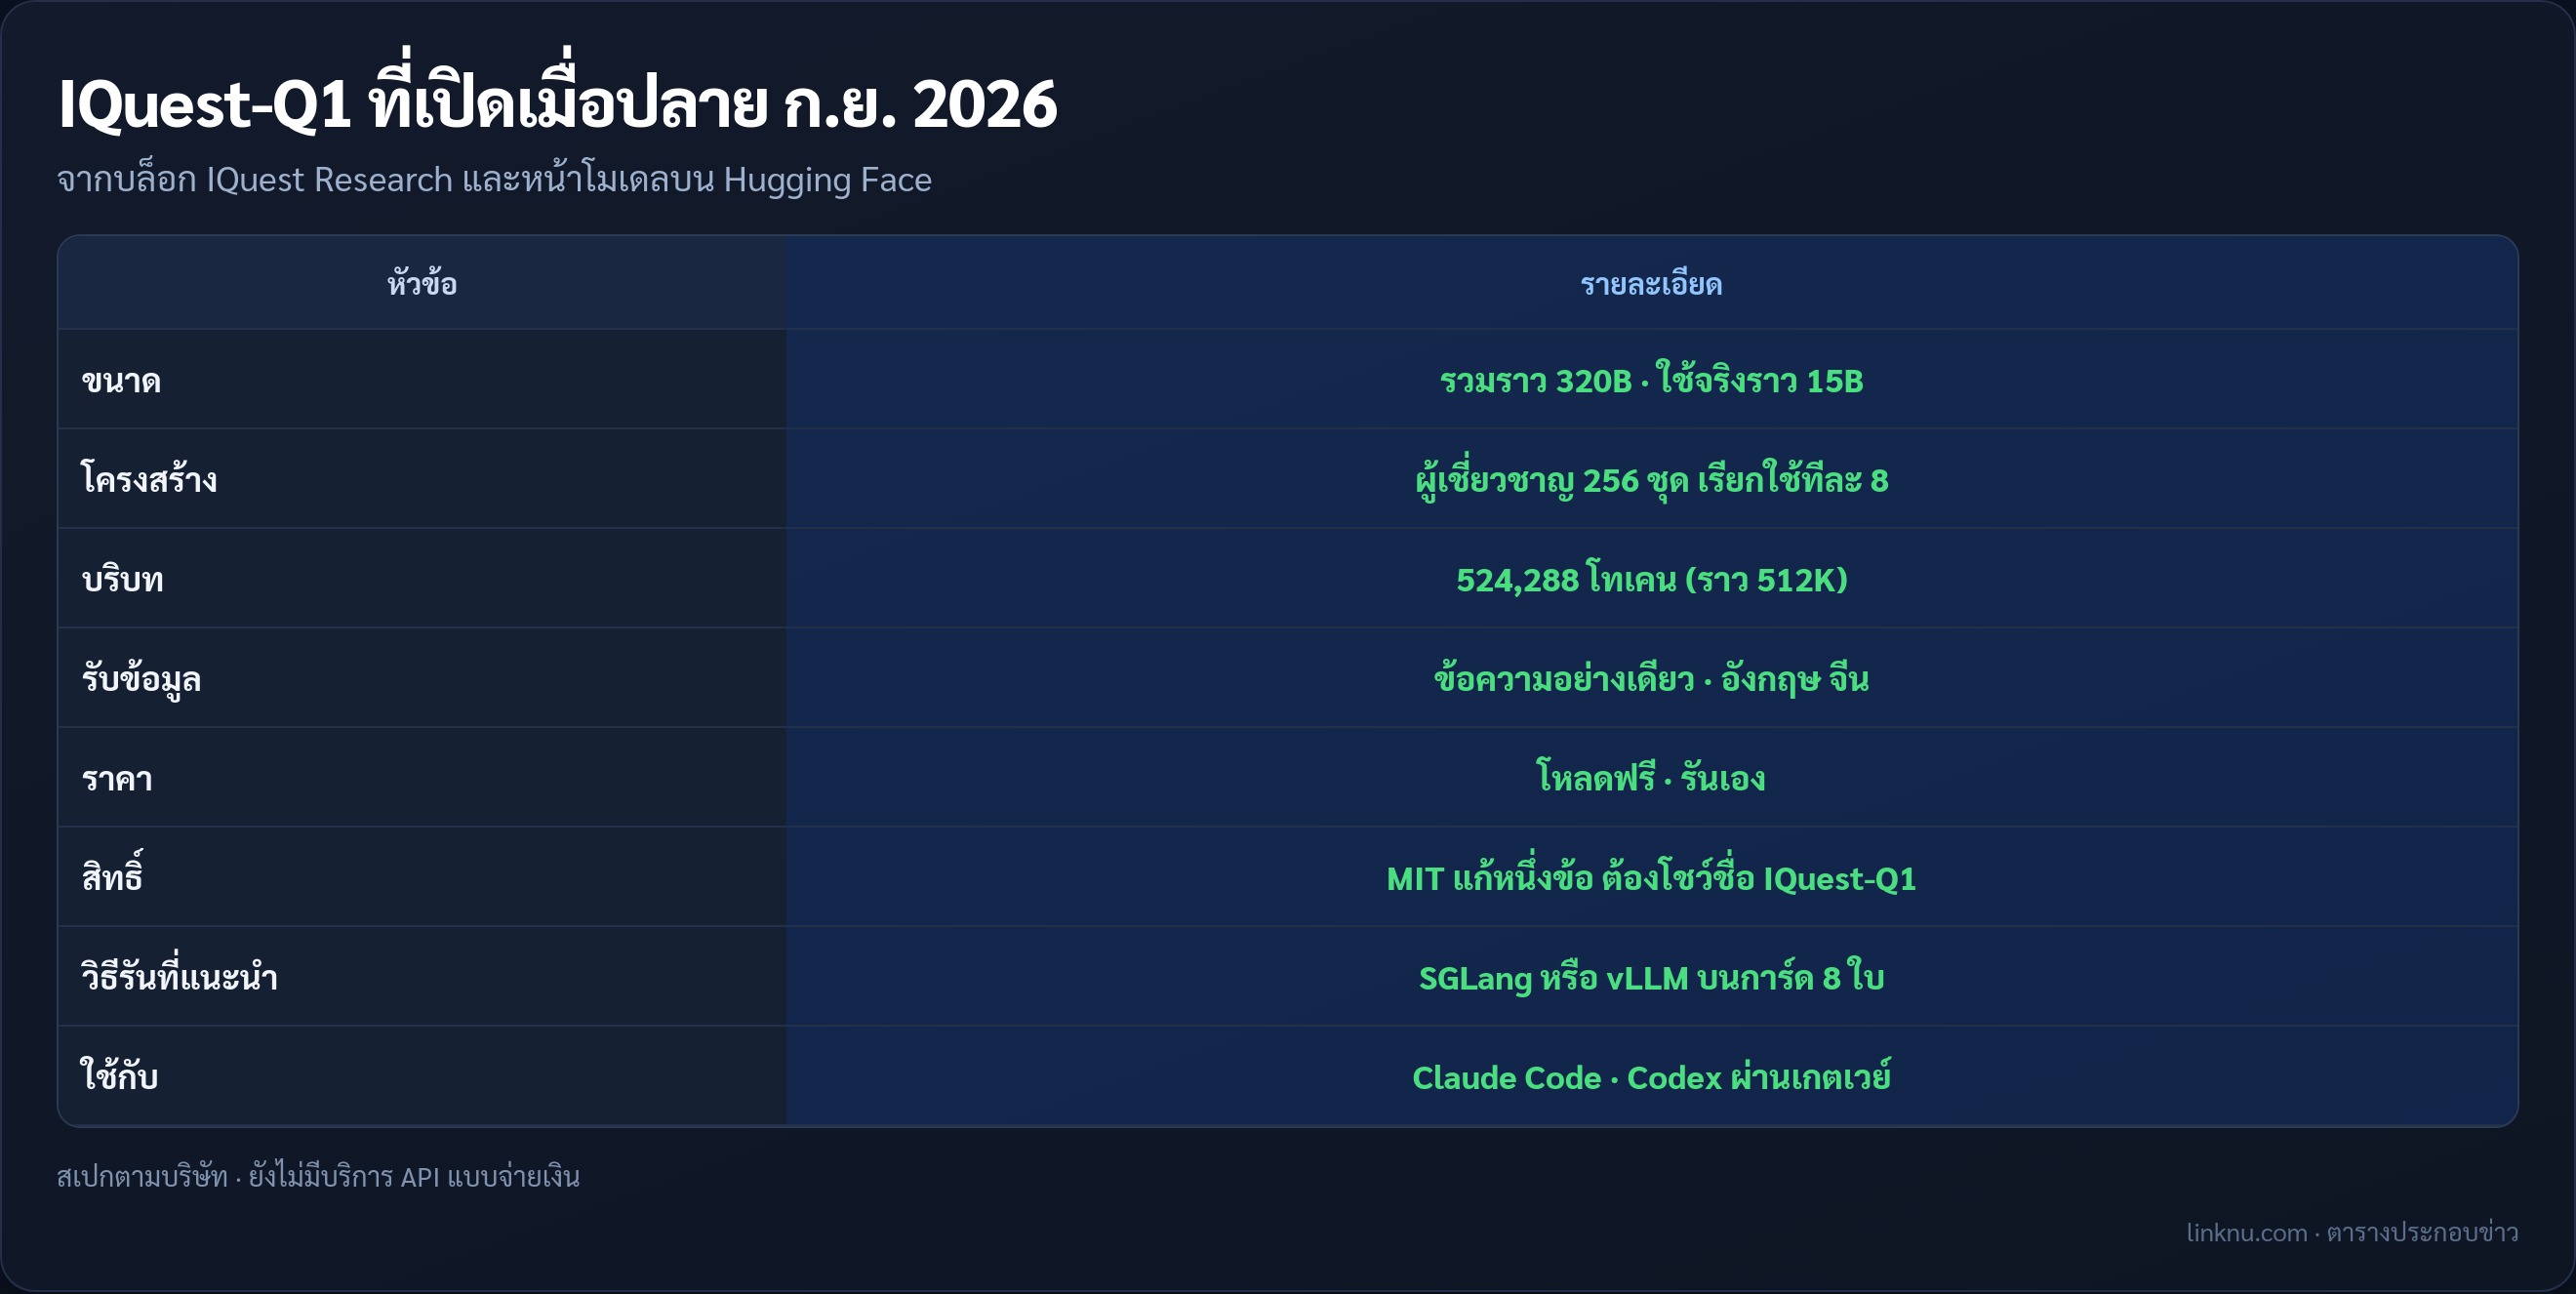
ขนาดรวมราว 320B แต่ตอนตอบใช้งานจริงแค่ราว 15B เลยกินแรงเครื่องน้อยกว่าที่ตัวเลขบอก ทีมบอกว่าเอาไปเสียบใช้กับ Claude Code หรือ Codex ได้ แต่ยังไม่มีบริการ API ให้จ่ายเงินใช้ ต้องหาเครื่องมารันเอง
สิ่งที่บริษัทประกาศ
- เป็นโมเดลแบบแบ่งผู้เชี่ยวชาญ มีทั้งหมด 256 ชุด แต่ละครั้งเรียกใช้แค่ 8 ชุด
- อ่านบริบทได้ยาวสุด 524,288 โทเคน หรือราว 512K
- รับได้แค่ข้อความ ยังไม่รับรูป เสียง หรือวิดีโอ
- สิทธิ์ใช้งานเป็น MIT ที่แก้เพิ่มหนึ่งข้อ ถ้าเอาไปทำสินค้าขายต้องโชว์ชื่อ IQuest-Q1 ให้เห็นชัดบนหน้าจอ
- ระหว่างพัฒนา ทีมให้โมเดลช่วยไล่หาบั๊กในระบบเทรนของตัวเองด้วย โดยมีคนคุมอยู่
- คู่มือแนะนำให้รันบนการ์ดจอ 8 ใบ ผ่าน SGLang หรือ vLLM
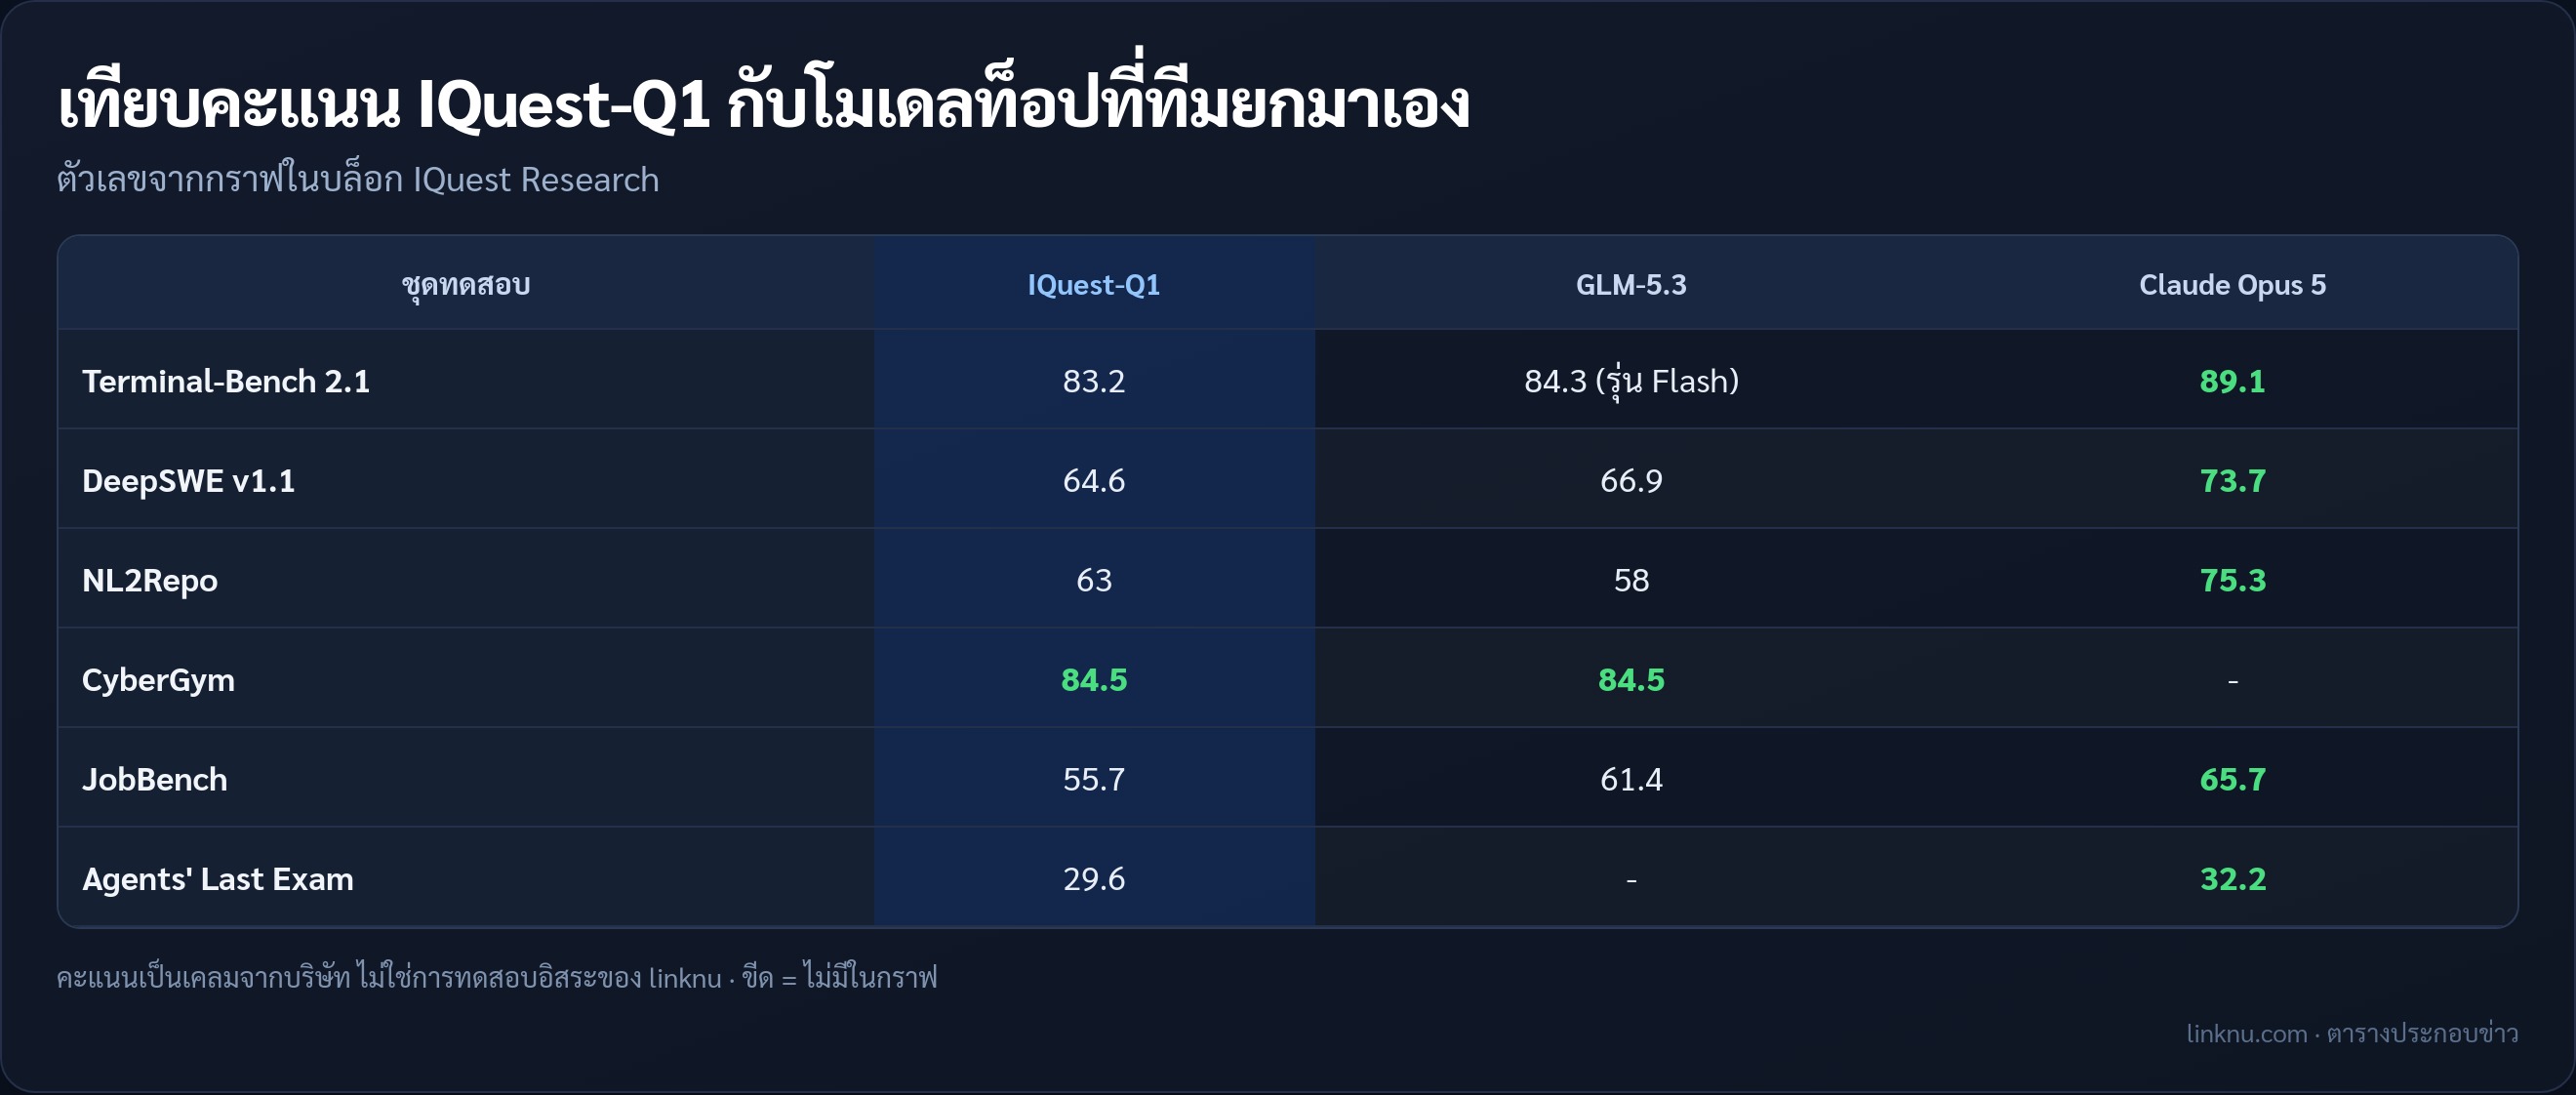
คะแนนที่บริษัทเคลม (ไม่ใช่การทดสอบอิสระของ linknu)
- Terminal-Bench 2.1 ได้ 83.2 ส่วน Claude Opus 5 ได้ 89.1
- DeepSWE v1.1 ได้ 64.6 ต่ำกว่า GLM-5.3 ที่ได้ 66.9
- CyberGym ได้ 84.5 เท่ากับ GLM-5.3 พอดี
- ข้อสอบเอเจนต์ชุด Agents' Last Exam ได้ 29.6 ใกล้กับ Claude Opus 5 ที่ได้ 32.2
- ชุดทดสอบที่ทีมทำขึ้นเองได้ 53.7 ส่วน GPT-5.6 Sol ได้ 58.5
ใครควรลอง
- ทีมที่อยากได้โมเดลเขียนโค้ดแบบเอเจนต์ไว้รันในเครื่องตัวเอง ไม่อยากส่งโค้ดออกไปข้างนอก
- คนที่ใช้ Claude Code หรือ Codex อยู่แล้ว และอยากลองสลับมาใช้โมเดลเปิดดูบ้าง
สรุป
IQuest-Q1 ยังไม่ชนะโมเดลปิดตัวท็อป แต่ใกล้พอให้ทีมที่มีเครื่องแรงลองเอามาทำงานจริงได้ ทีมเองก็ยอมรับว่ายังอยู่ช่วงต้น บางทีมันลืมเงื่อนไขหรือวนลองแบบเดิมซ้ำ ใครเอาไปใช้ควรมีคนตรวจงานทุกครั้ง
แหล่ง: IQuest Research · 29 ก.ย. 2026