จุดเด่นคือไม่ได้หาแค่ท่อนที่มีคำตอบ แต่ดึงท่อนที่ใช้ยืนยันคำตอบมาด้วย ท่อนที่พูดลอยๆ อย่าง "บริษัทนี้" ก็ยังรู้ว่าหมายถึงใคร ตอนนี้โหลดมารันเองได้ฟรีบน Hugging Face ส่วน API ของ Perplexity ยังไม่มีรุ่นนี้
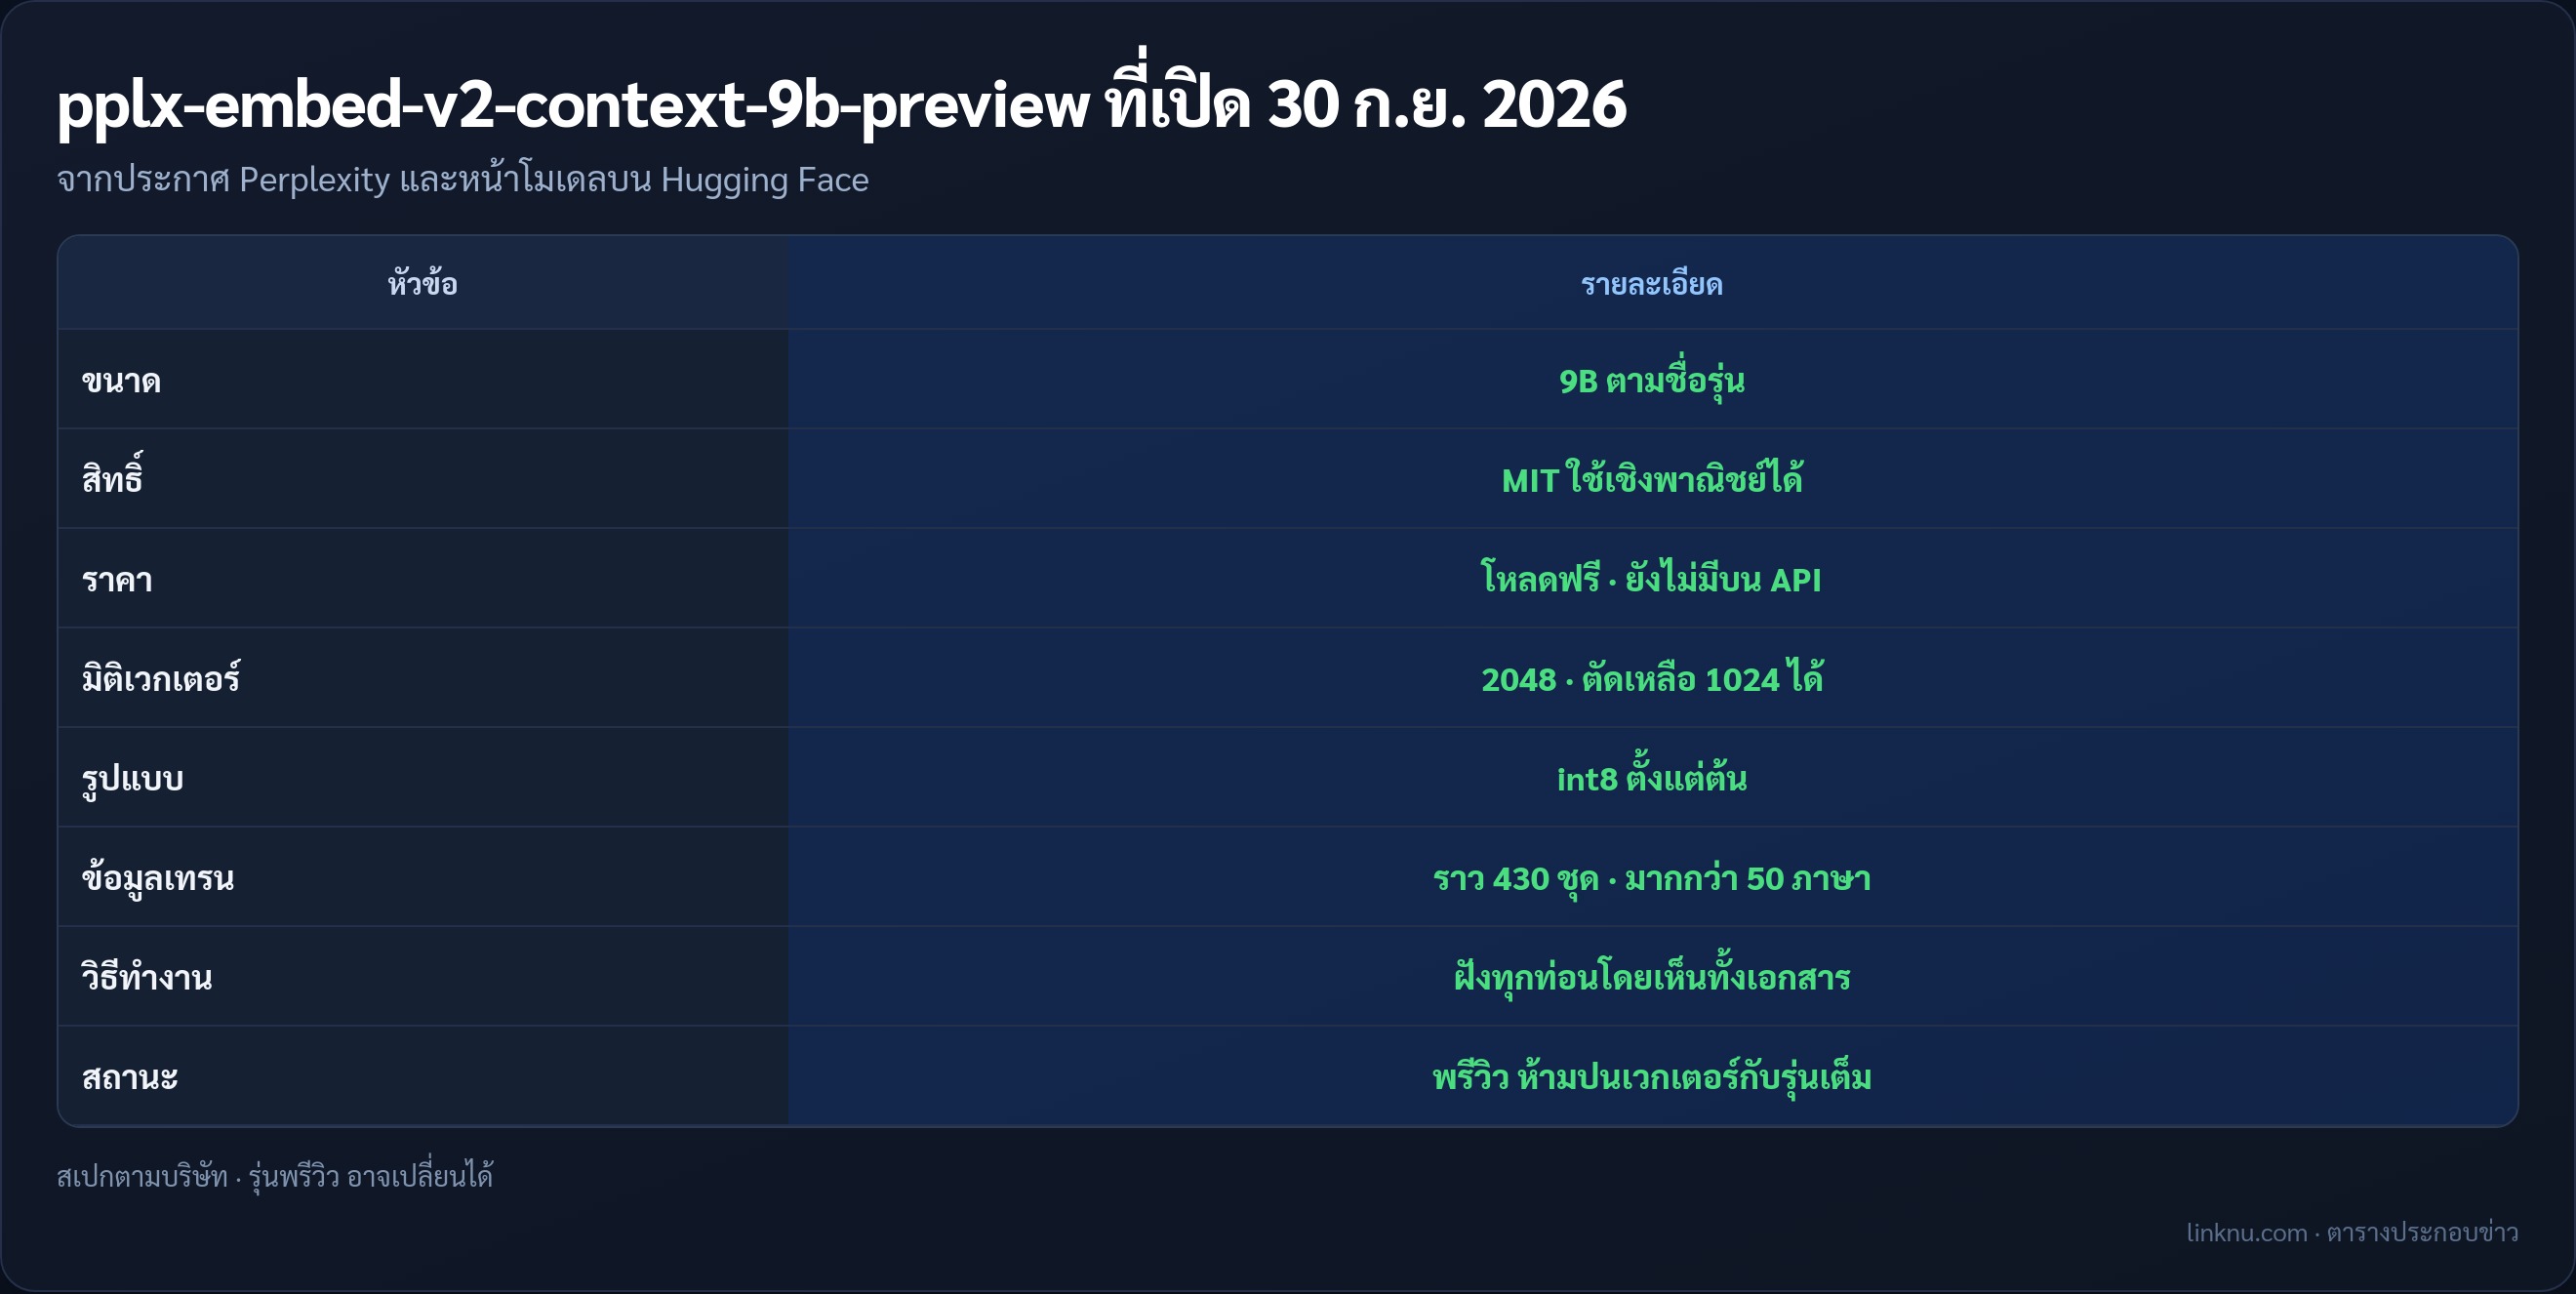
สิ่งที่บริษัทประกาศ
- ขนาด 9B ตามชื่อรุ่น สิทธิ์ MIT ใช้เชิงพาณิชย์ได้
- เวกเตอร์ 2048 มิติ ตัดเหลือ 1024 มิติได้ และออกมาเป็น int8 ตั้งแต่ต้น
- เทรนจากข้อมูลราว 430 ชุด มากกว่า 50 ภาษา
- ใช้โมเดลบีบบริบทของ Perplexity เป็นครูให้คะแนนว่าท่อนไหนเกี่ยวกับคำถาม
- ยังเป็นรุ่นพรีวิว น้ำหนักกับวิธีเรียกใช้อาจเปลี่ยน ห้ามเอาเวกเตอร์ไปปนกับรุ่นจริงที่จะออกทีหลัง
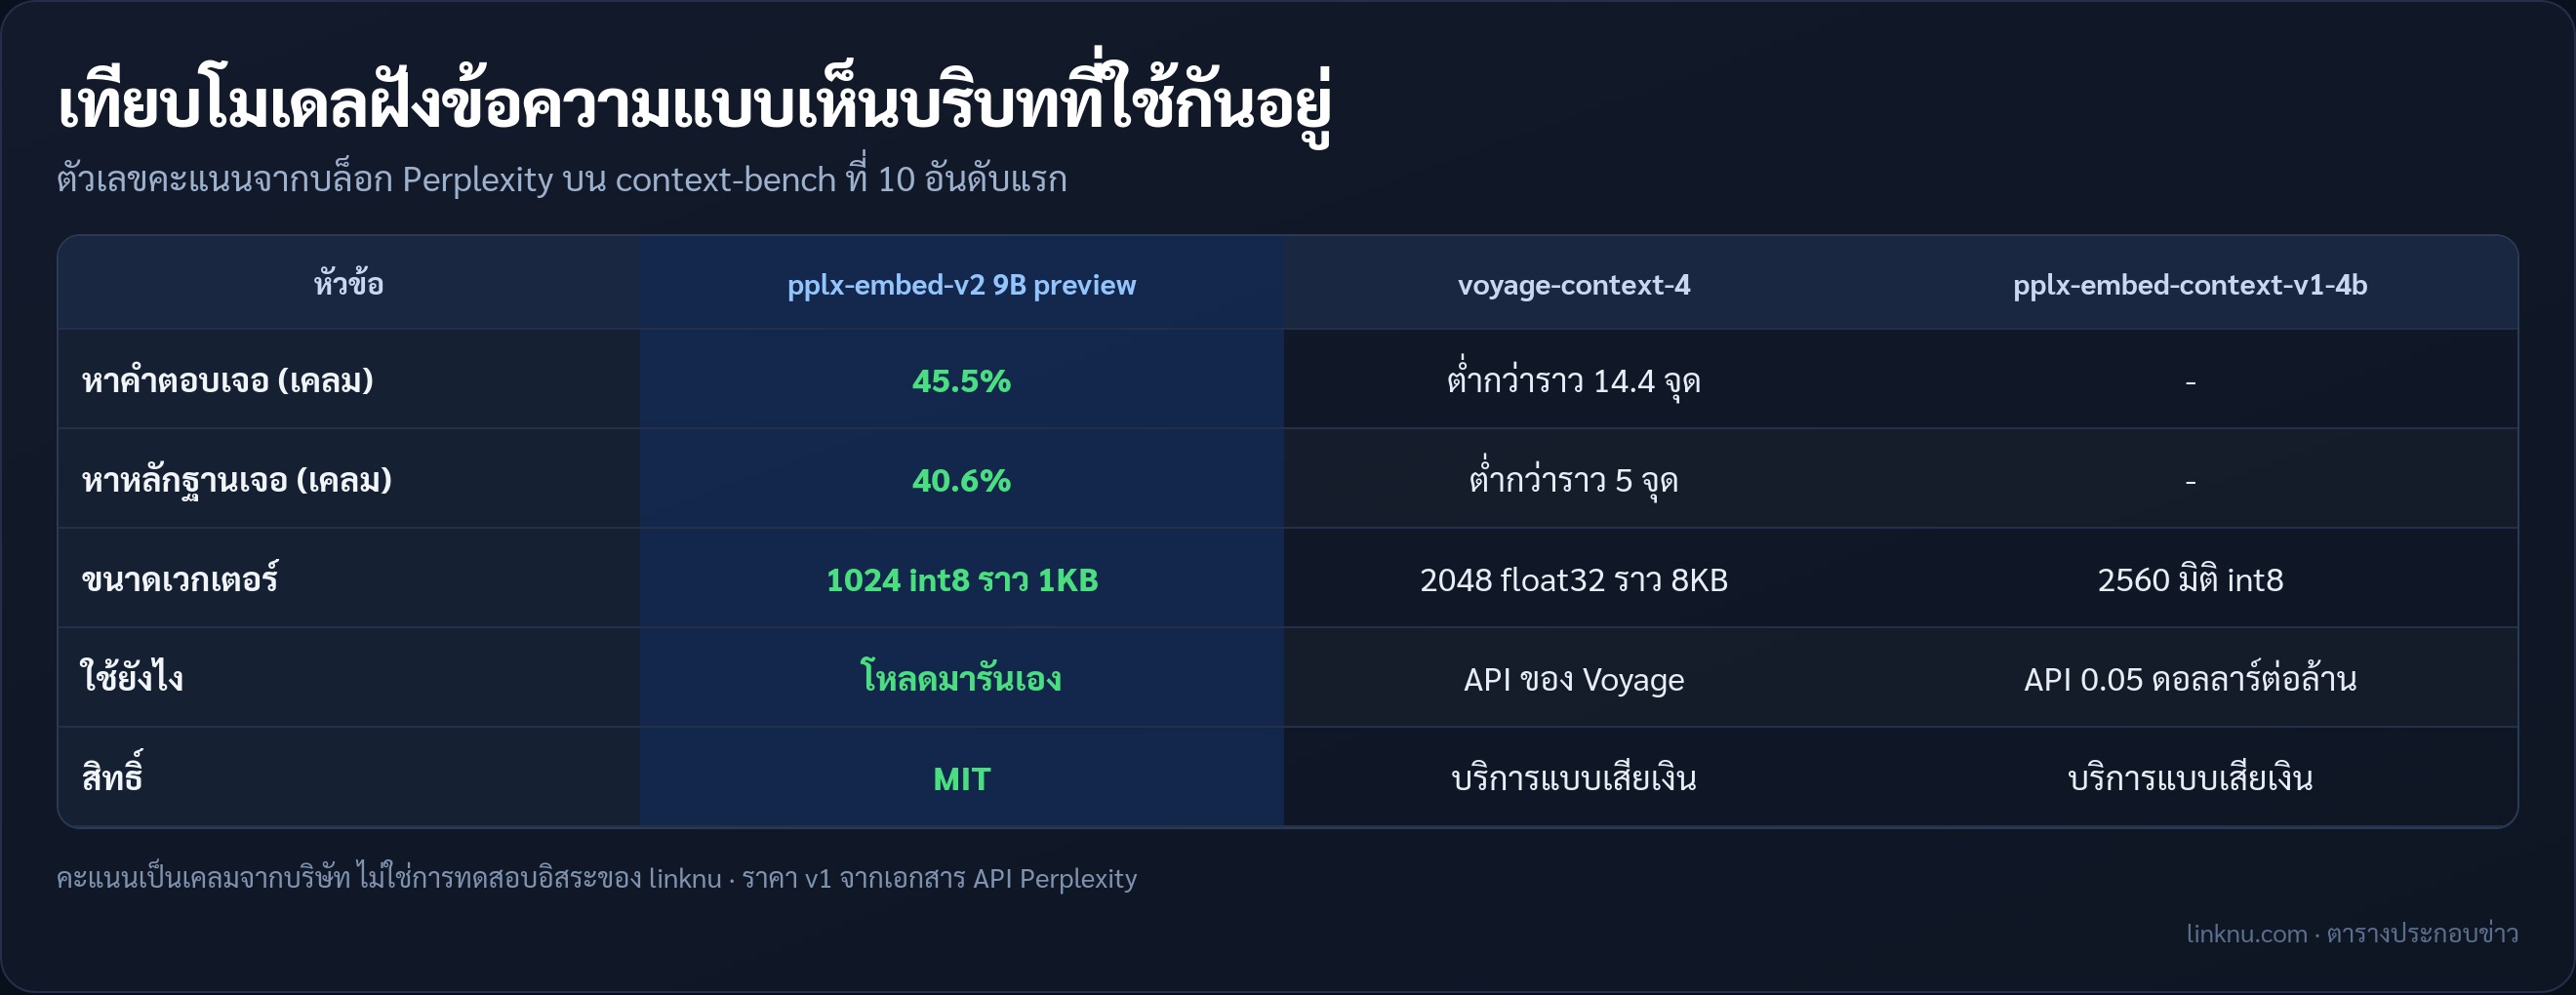
คะแนนที่บริษัทเคลม (ไม่ใช่การทดสอบอิสระของ linknu)
- ทำคะแนนนำบน context-bench ชุดทดสอบลับของ turbopuffer และบน ConTEB ชุดทดสอบสาธารณะ
- ที่ 10 อันดับแรก หาท่อนคำตอบเจอ 45.5% และหาท่อนหลักฐานเจอ 40.6%
- เหนือ voyage-context-4 ราว 14.4 จุดเรื่องหาคำตอบ และราว 5 จุดเรื่องหาหลักฐาน
- เวกเตอร์ 1024 มิติแบบ int8 กินที่ราว 1KB ต่อชิ้น เล็กกว่าของ Voyage แบบ 2048 มิติที่ราว 8KB แต่คะแนนยังสูงกว่านิดหน่อยในชุดทดสอบของ Perplexity เอง
ใครควรลอง
- ทีมที่ทำระบบค้นเอกสารยาว เช่น คู่มือ สัญญา รายงาน ที่ท่อนเดียวอ่านแล้วไม่ครบความ
- คนที่อยากรันโมเดลฝังข้อความบนเครื่องตัวเอง ไม่อยากส่งข้อมูลออกไปข้างนอก
สรุป
Perplexity กำลังบอกว่าการค้นเอกสารที่ดีต้องเอาหลักฐานมาด้วย ไม่ใช่แค่ท่อนเดียวที่ดูตรงคำถาม ใครใช้ RAG อยู่ลองเทียบกับโมเดลเดิมได้เลย แต่อย่าเพิ่งย้ายระบบจริงทั้งหมดจนกว่าจะออกรุ่นเต็ม
แหล่ง: Perplexity · 30 ก.ย. 2026