รอบนี้เพิ่มดึงข้อมูลจากฟอร์ม ตารางหลายหน้า และลายมือภาษาอินเดีย พร้อมลดจุดที่เคยหลอนและไม่คงที่ ตามบล็อกทางการของบริษัท
จุดที่ควรรู้
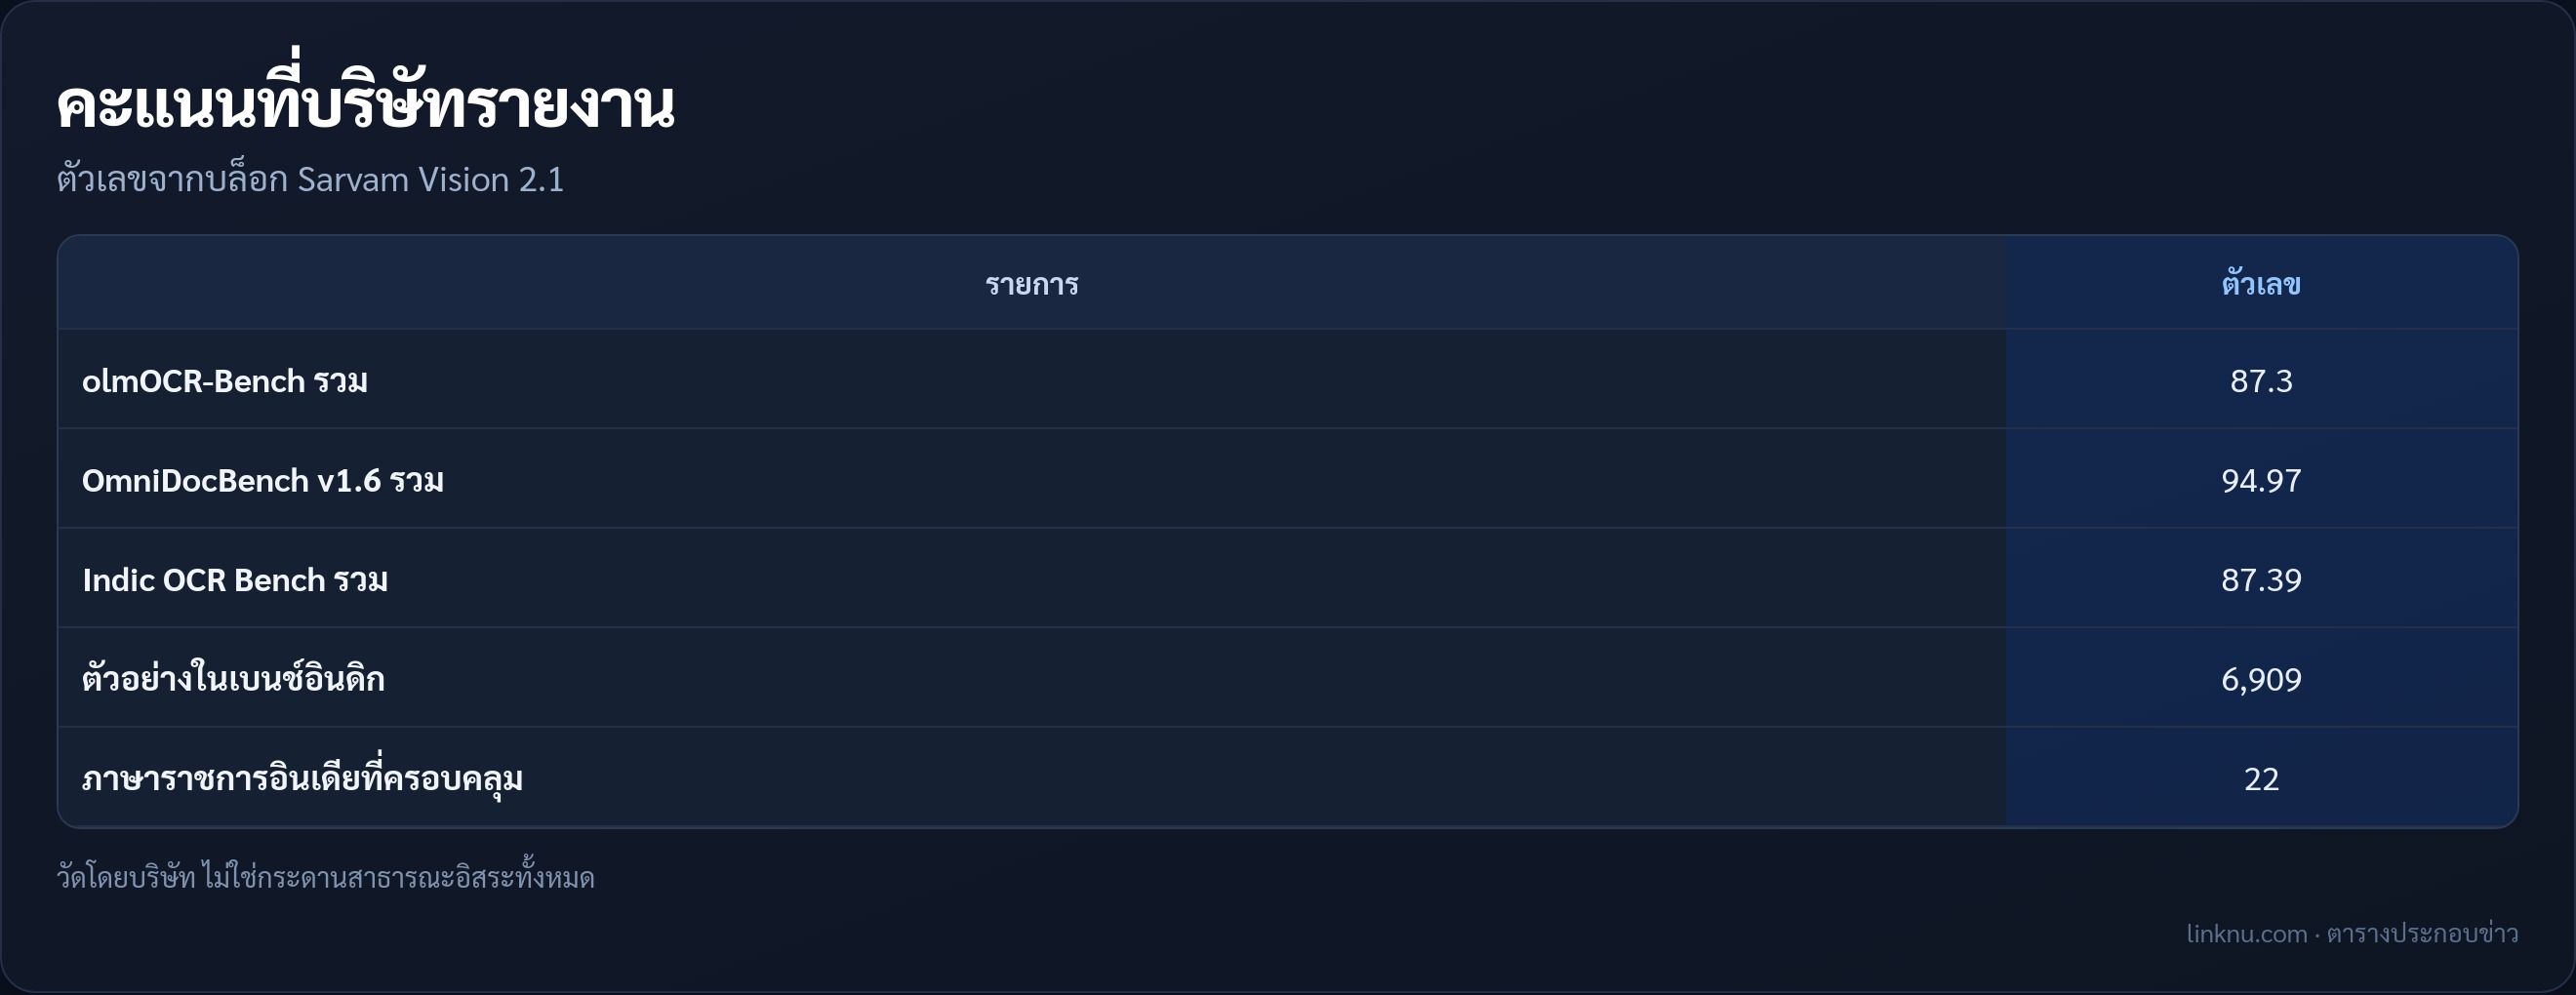
- บริษัทอ้างคะแนนรวม olmOCR-Bench 87.3 สูงกว่า Infinity-Parser2 Pro ที่ 86.1 และ Opus 5 ที่ 85.1 ในการทดสอบของบริษัทเอง
- OmniDocBench เวอร์ชัน 1.6 ได้รวม 94.97 ตามหลัง PaddleOCR-VL 1.6 ที่ 96.01 แต่บริษัทบอกว่าโมเดลอยู่บนเส้นพาเรโตของสองเบนช์รวมกัน
- เปิดชุดทดสอบ Indic OCR Bench 6,909 ตัวอย่างครอบคลุม 22 ภาษาราชการอินเดีย บริษัทอ้างความแม่นยำรวม 87.39 สูงกว่าคู่แข่งในตารางเดียวกัน
- ใช้โครงแฮร์เนสกับโมเดลวิชั่น มีตัวแยกเลย์เอาต์และความหมาย และเครือข่ายจัดลำดับการอ่าน ฝึกแบบ supervised แล้วตามด้วย RLVR
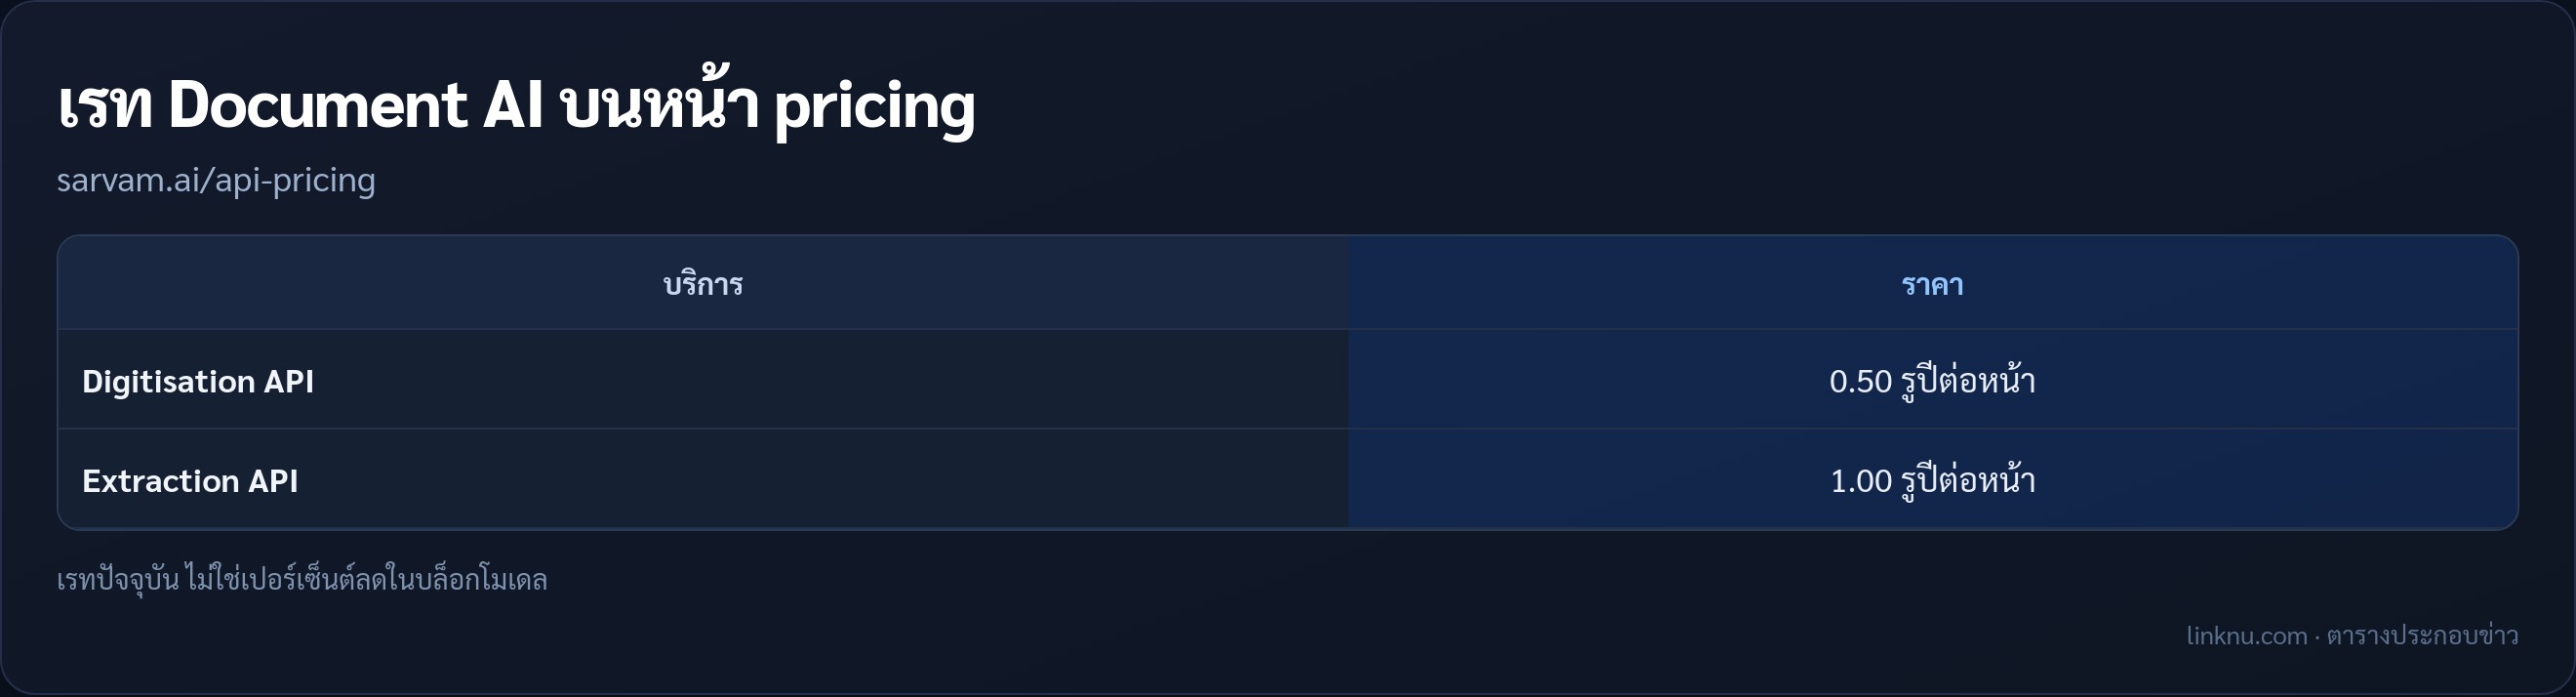
- เพจราคา API ของบริษัทระบุ Document AI ดิจิไทซ์ 0.50 รูปีต่อหน้า สกัดข้อมูล 1.00 รูปีต่อหน้า ชุดทดสอบอินดิกอยู่บน Hugging Face ที่ sarvamai/indic-ocr-bench
อย่าเข้าใจผิด
- ตัวเลขเบนช์ส่วนใหญ่มาจากการวัดของบริษัทเอง ไม่ใช่กระดานสาธารณะอิสระทั้งหมด
- นี่คืออัปเกรดโฟกัสเอกสารและภาษาอินเดีย ไม่ใช่โมเดลแชทอเนกประสงค์รุ่นใหญ่แบบ GPT หรือ Gemini
- บริษัทบอกว่าราคาเสิร์ฟถูกลงกว่าตอนเปิดตัว แต่ตัวเลข 0.50 และ 1.00 รูปีต่อหน้าคือเรท Document AI บนหน้า pricing ปัจจุบัน ไม่ใช่การลดเป็นเปอร์เซ็นต์ในบล็อกโมเดล
สรุป
อยากทำระบบอ่านเอกสารหลายภาษาอินเดียหรือดึงฟอร์มตารางจากสแกน Vision 2.1 เปิดใช้ผ่าน API ของ Sarvam แล้ว และมีเบนช์อินดิกโหลดทดสอบได้บน Hugging Face
แหล่ง: Sarvam AI blog · sarvam.ai/api-pricing · 24 ก.ย. 2026