มีอะไรในชุดนี้
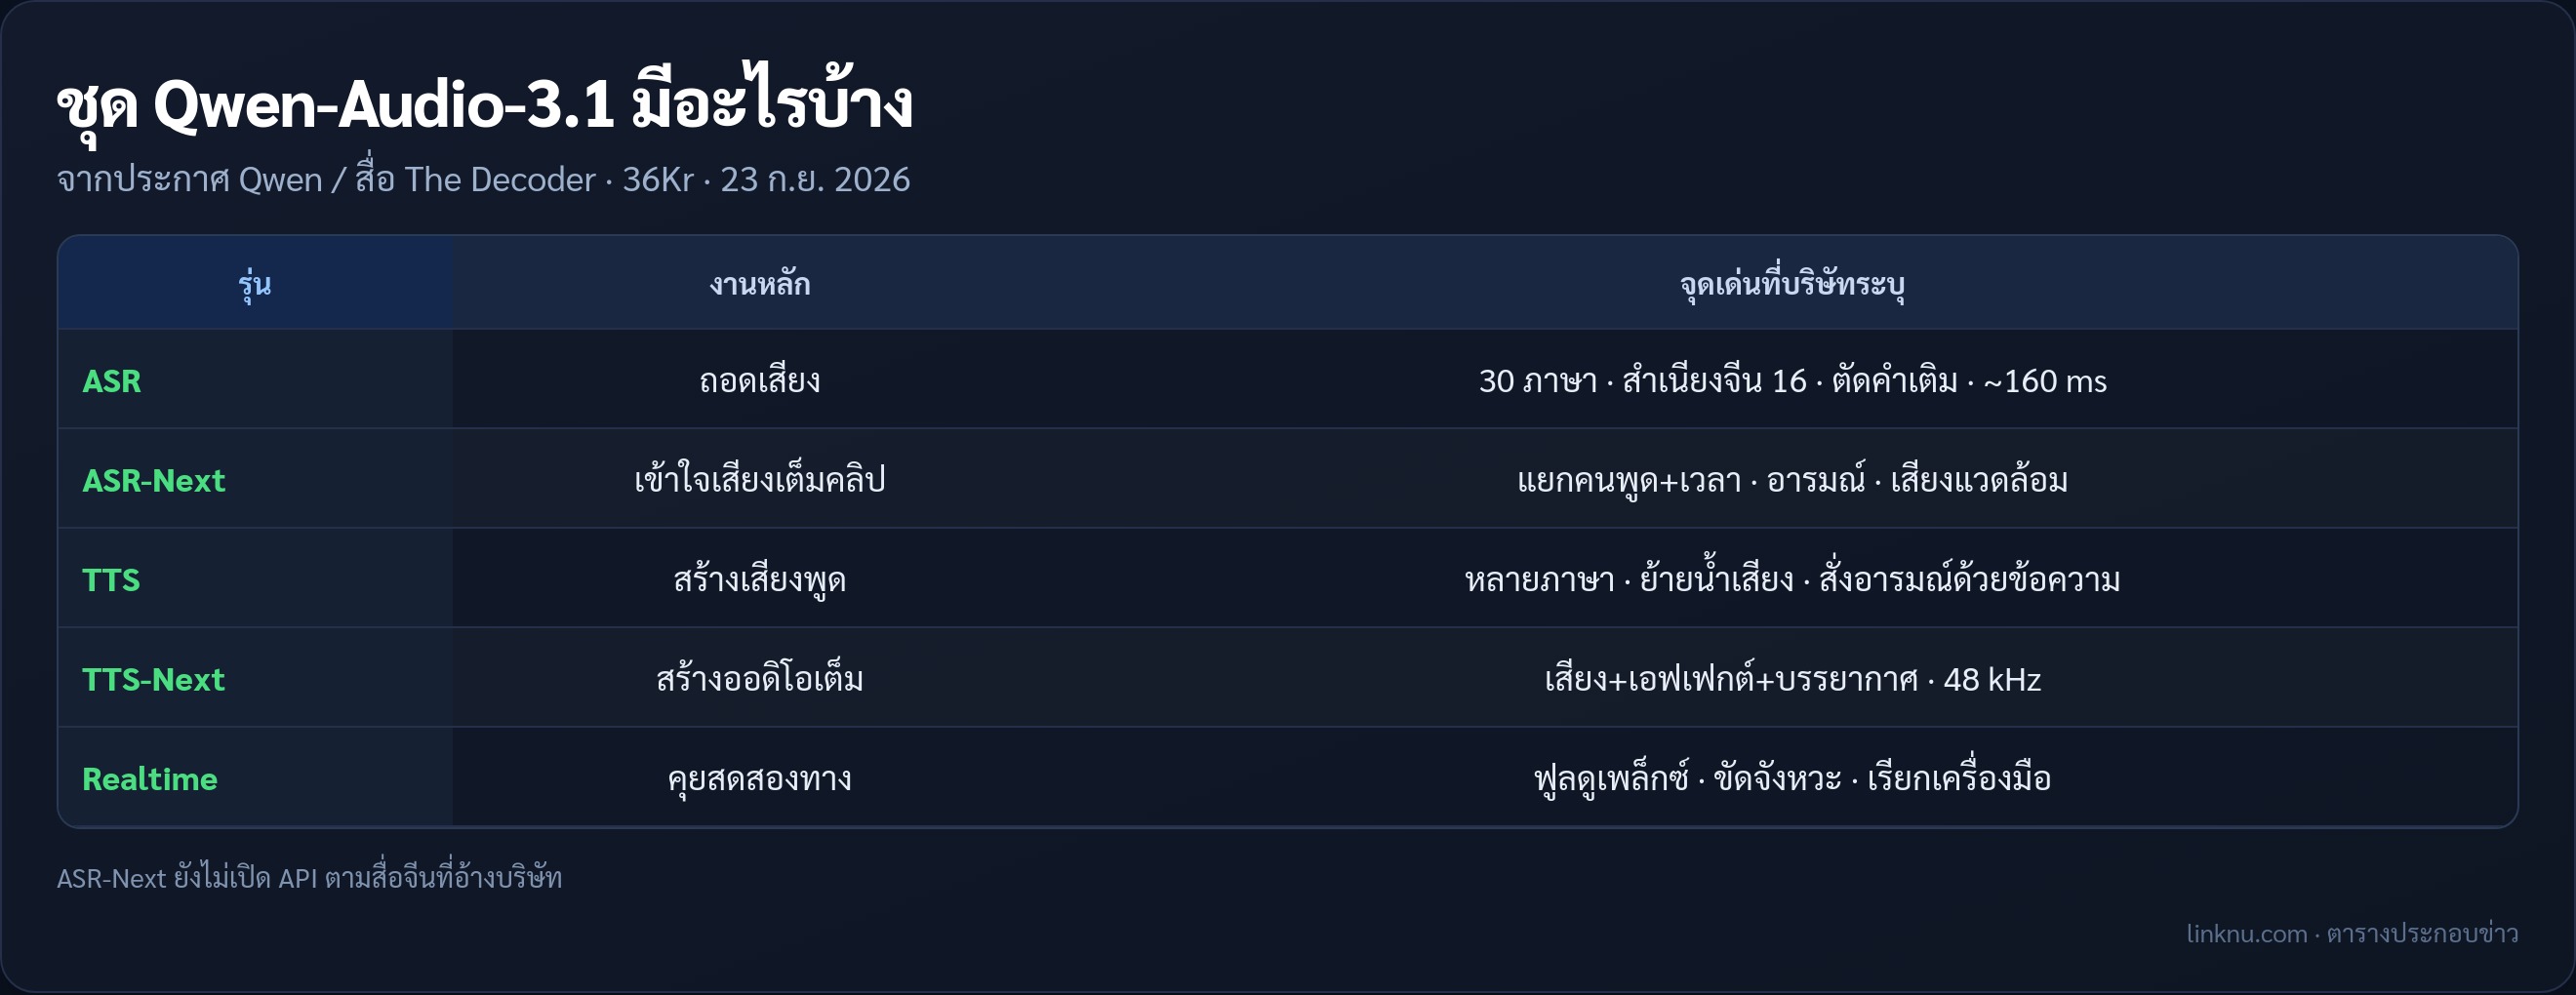
- Qwen-Audio-3.1-ASR ถอดเสียงได้ราว 30 ภาษาและสำเนียงจีน 16 แบบ ตัดคำเติมและคำซ้ำให้ ตอบตัวอักษรแรกประมาณ 160 มิลลิวินาที ตามตัวเลขบริษัท
- Qwen-Audio-3.1-ASR-Next แยกคนพูดพร้อมเวลา แล้วบอกอารมณ์ เสียงแวดล้อม และเสียงเครื่องจักรในคลิปเดียวกัน API ยังไม่เปิดตามสื่อจีน
- Qwen-Audio-3.1-TTS สังเคราะห์หลายภาษา ย้ายน้ำเสียงข้ามภาษาได้ คุมอารมณ์ จังหวะ และสไตล์ด้วยข้อความสั่ง
- Qwen-Audio-3.1-TTS-Next รวมโมเดลภาษาเข้ากับดิฟฟิวชัน สร้างเสียงพูด เอฟเฟกต์ และบรรยากาศในพาสเดียว ออก 48 กิโลเฮิรตซ์
- Qwen-Audio-3.1-Realtime คุยแบบฟังกับพูดพร้อมกัน ขัดจังหวะได้ ปรับจังหวะตามอารมณ์ผู้ใช้ และเรียกเครื่องมือภายนอกได้
ราคาที่เอกสารและสื่ออ้างอิง
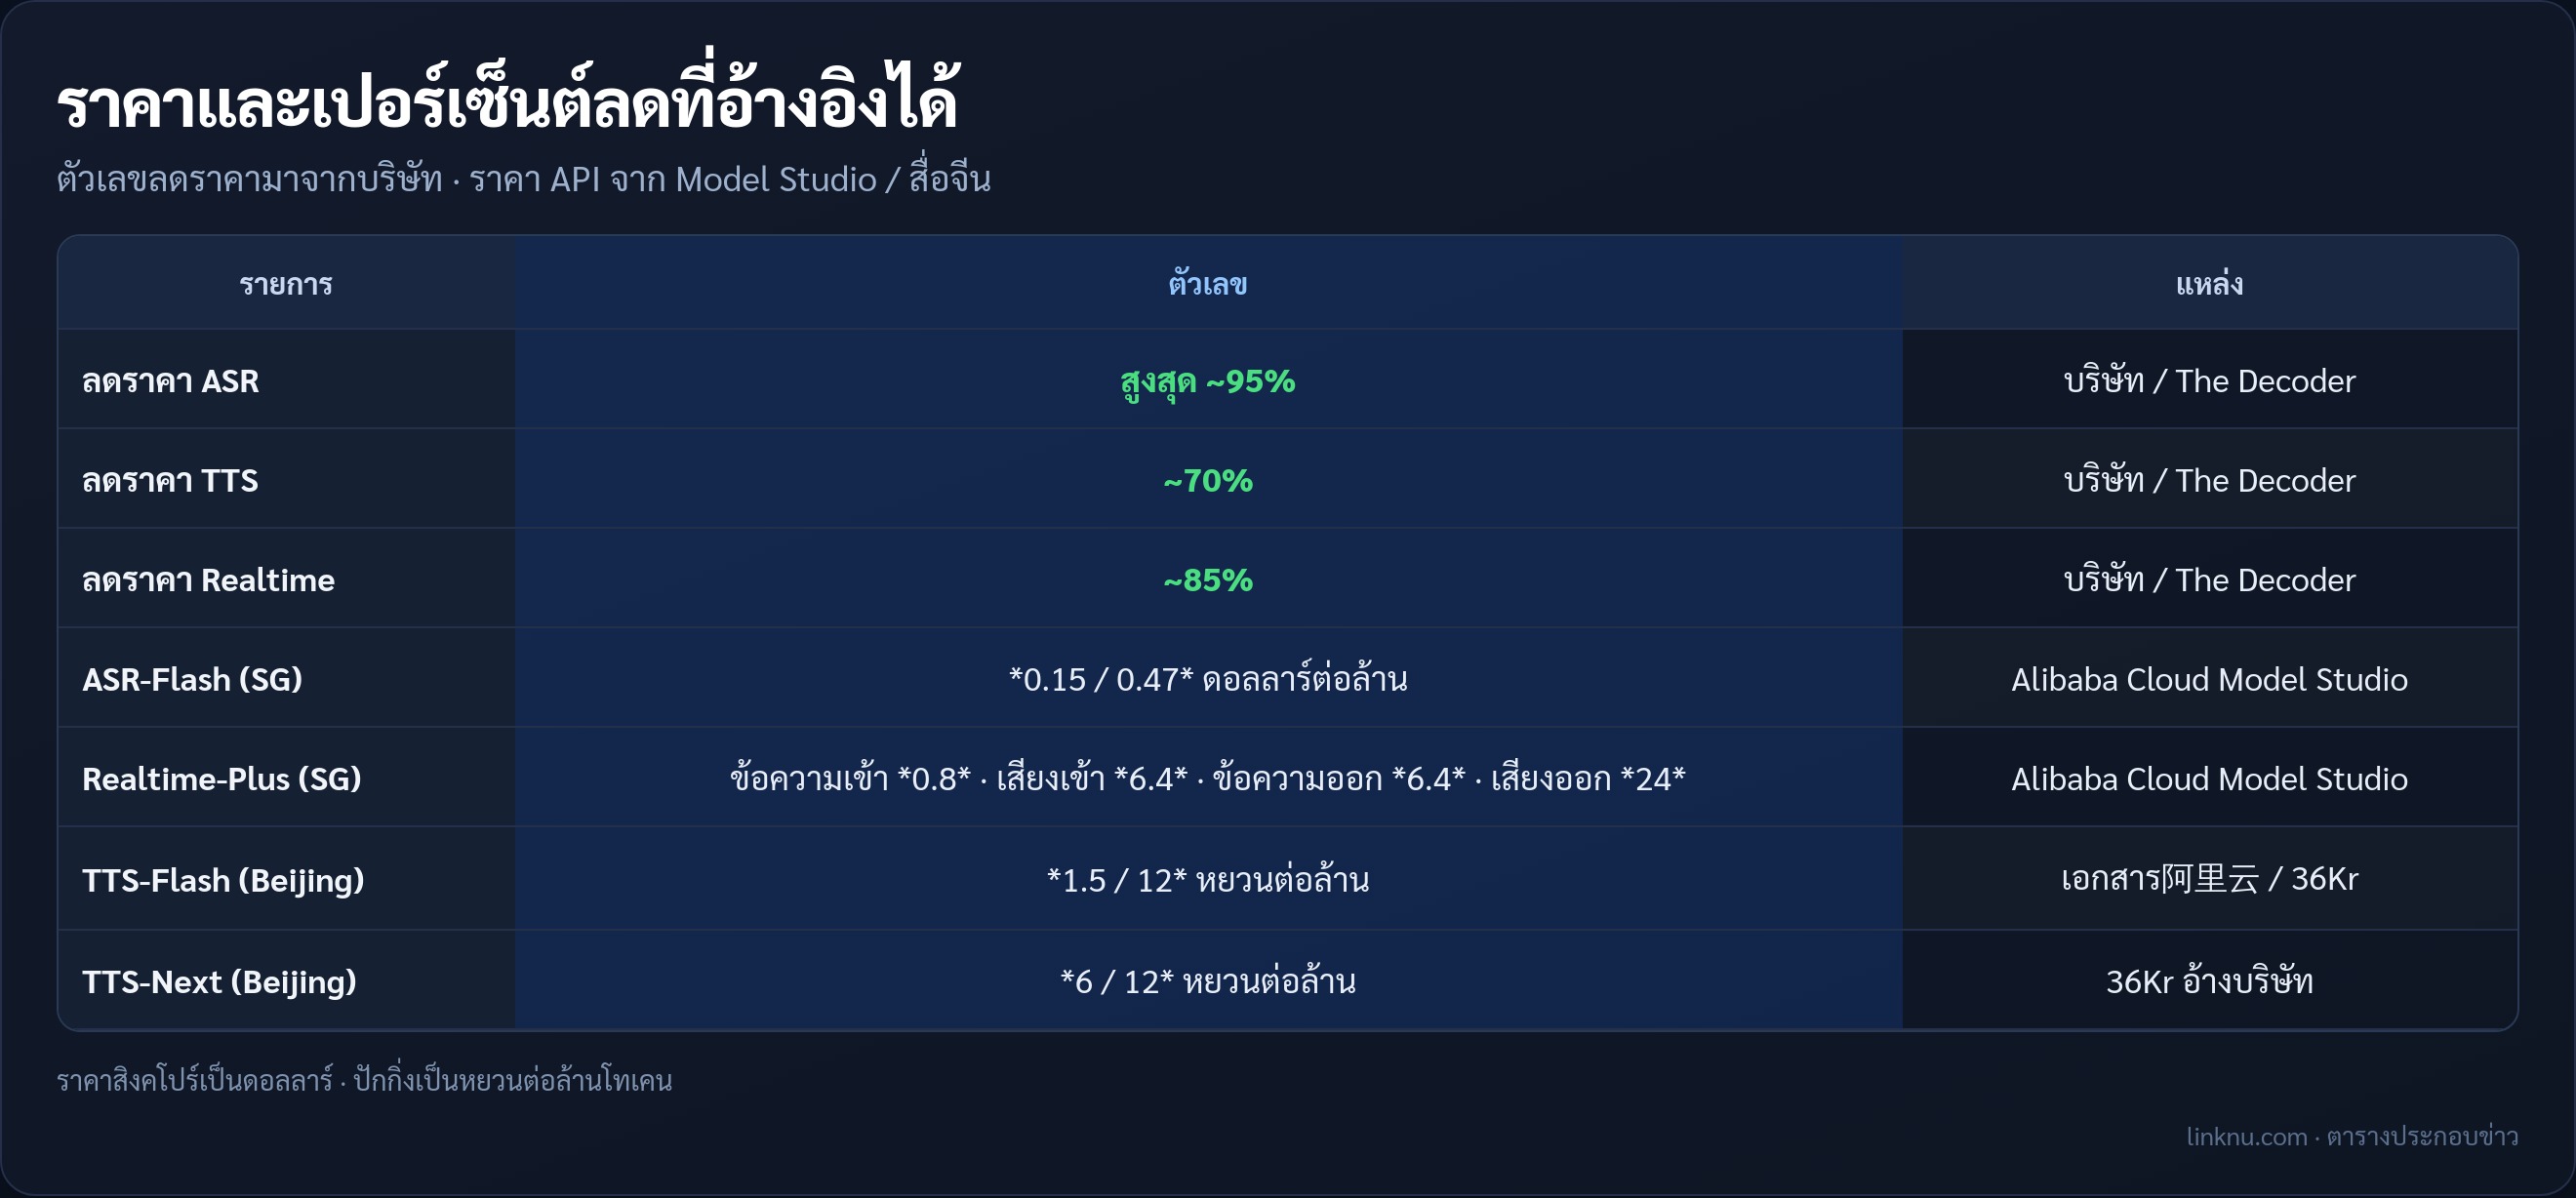
- บริษัทประกาศลด TTS ประมาณ 70% Realtime ประมาณ 85% ASR สูงสุดประมาณ 95%
- หน้า Model Studio สิงคโปร์ ระบุ ASR-Flash เข้า 0.15 / ออก 0.47 ดอลลาร์ต่อล้านโทเคน
- Realtime-Plus สิงคโปร์ ข้อความเข้า 0.8 · เสียงเข้า 6.4 · ข้อความออก 6.4 · เสียงออก 24 ดอลลาร์ต่อล้านโทเคน
- โซนปักกิ่งสื่อจีนอ้าง TTS-Flash เข้า 1.5 / ออก 12 หยวนต่อล้านโทเคน และ TTS-Next เข้า 6 / ออก 12 หยวนต่อล้านโทเคน
อย่าเข้าใจผิด
- ไม่ใช่แค่ต่อยอด Realtime Plus อย่างเดียว รอบนี้เปิดครบห้าโมเดลพร้อมกัน
- ไม่ใช่ Qwen3.8-LiveTranslate รุ่นล่ามสดที่พรีวิวงาน Yunqi แยกชุด
- ตัวเลขลดราคาและคะแนนเบนช์ส่วนใหญ่มาจากบริษัทหรือสื่อจีนที่อ้างบริษัท ไม่ใช่กระดานอิสระ
สรุป
อยากทำแอปถอดเสียง พากย์ หรือคุยสด ตอนนี้ Qwen มีชุดเสียงครบห้าตัว และบริษัทบอกว่าราคาถูกลงชัดทั้ง ASR TTS และ Realtime
แหล่ง: The Decoder · 36Kr / 智东西 · Alibaba Cloud Model Studio · 23 ก.ย. 2026