โมเดลทำอะไรบ้าง
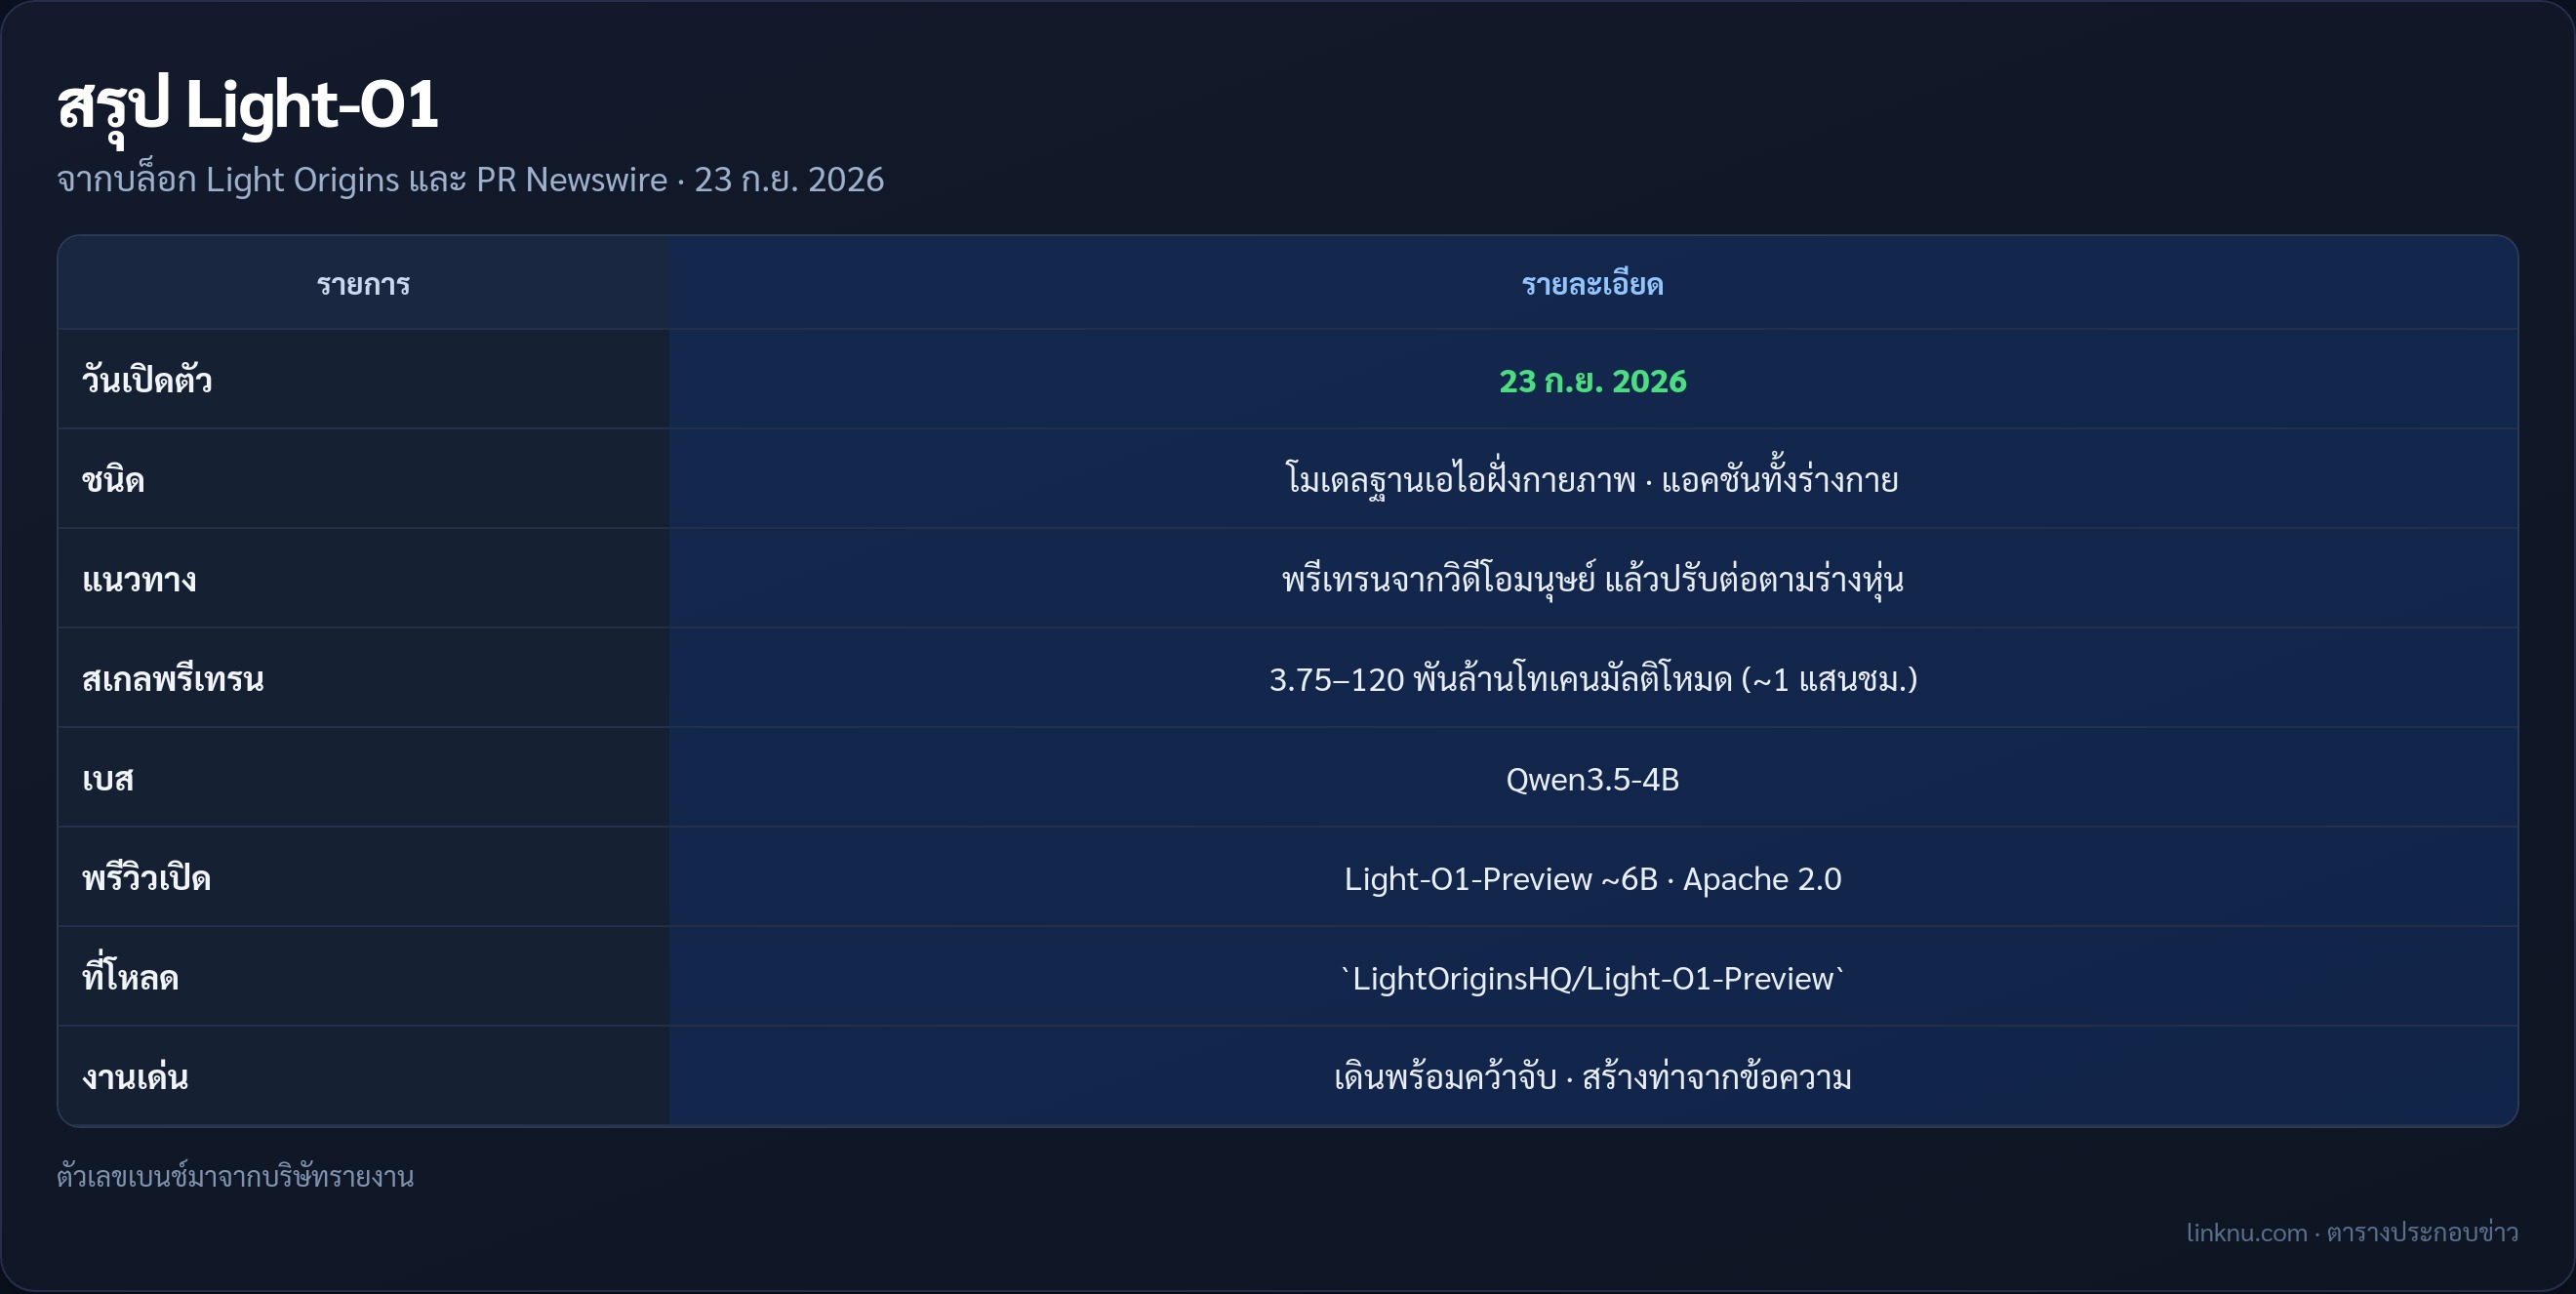
- เรียนไพรเออร์แอคชันมนุษย์จากวิดีโอ แล้วถ่ายโอนข้ามร่างหุ่นได้
- ทดลองสเกลพรีเทรน 6 ระดับ จาก 3.75 พันล้านถึง 120 พันล้านโทเคนมัลติโหมด ประมาณ 1 แสนชั่วโมงแอคชันมนุษย์
- ทำงานเดินพร้อมคว้าจับตามคำสั่งในฉากจริง เช่น เก็บขยะ เช็ดโต๊ะ เปิดตู้ใส่รองเท้า
- สร้างท่าทางทั้งร่างกายจากข้อความ เช่น คุกเข่า ตีกอล์ฟ ยืนขาเดียว
- เปิด Light-O1-Preview ประมาณ 6 พันล้านพารามิเตอร์ ที่ `LightOriginsHQ/Light-O1-Preview` บน Hugging Face ภายใต้ Apache 2.0 พร้อมโค้ดและเพลย์กราวด์
ผลที่บริษัทรายงาน
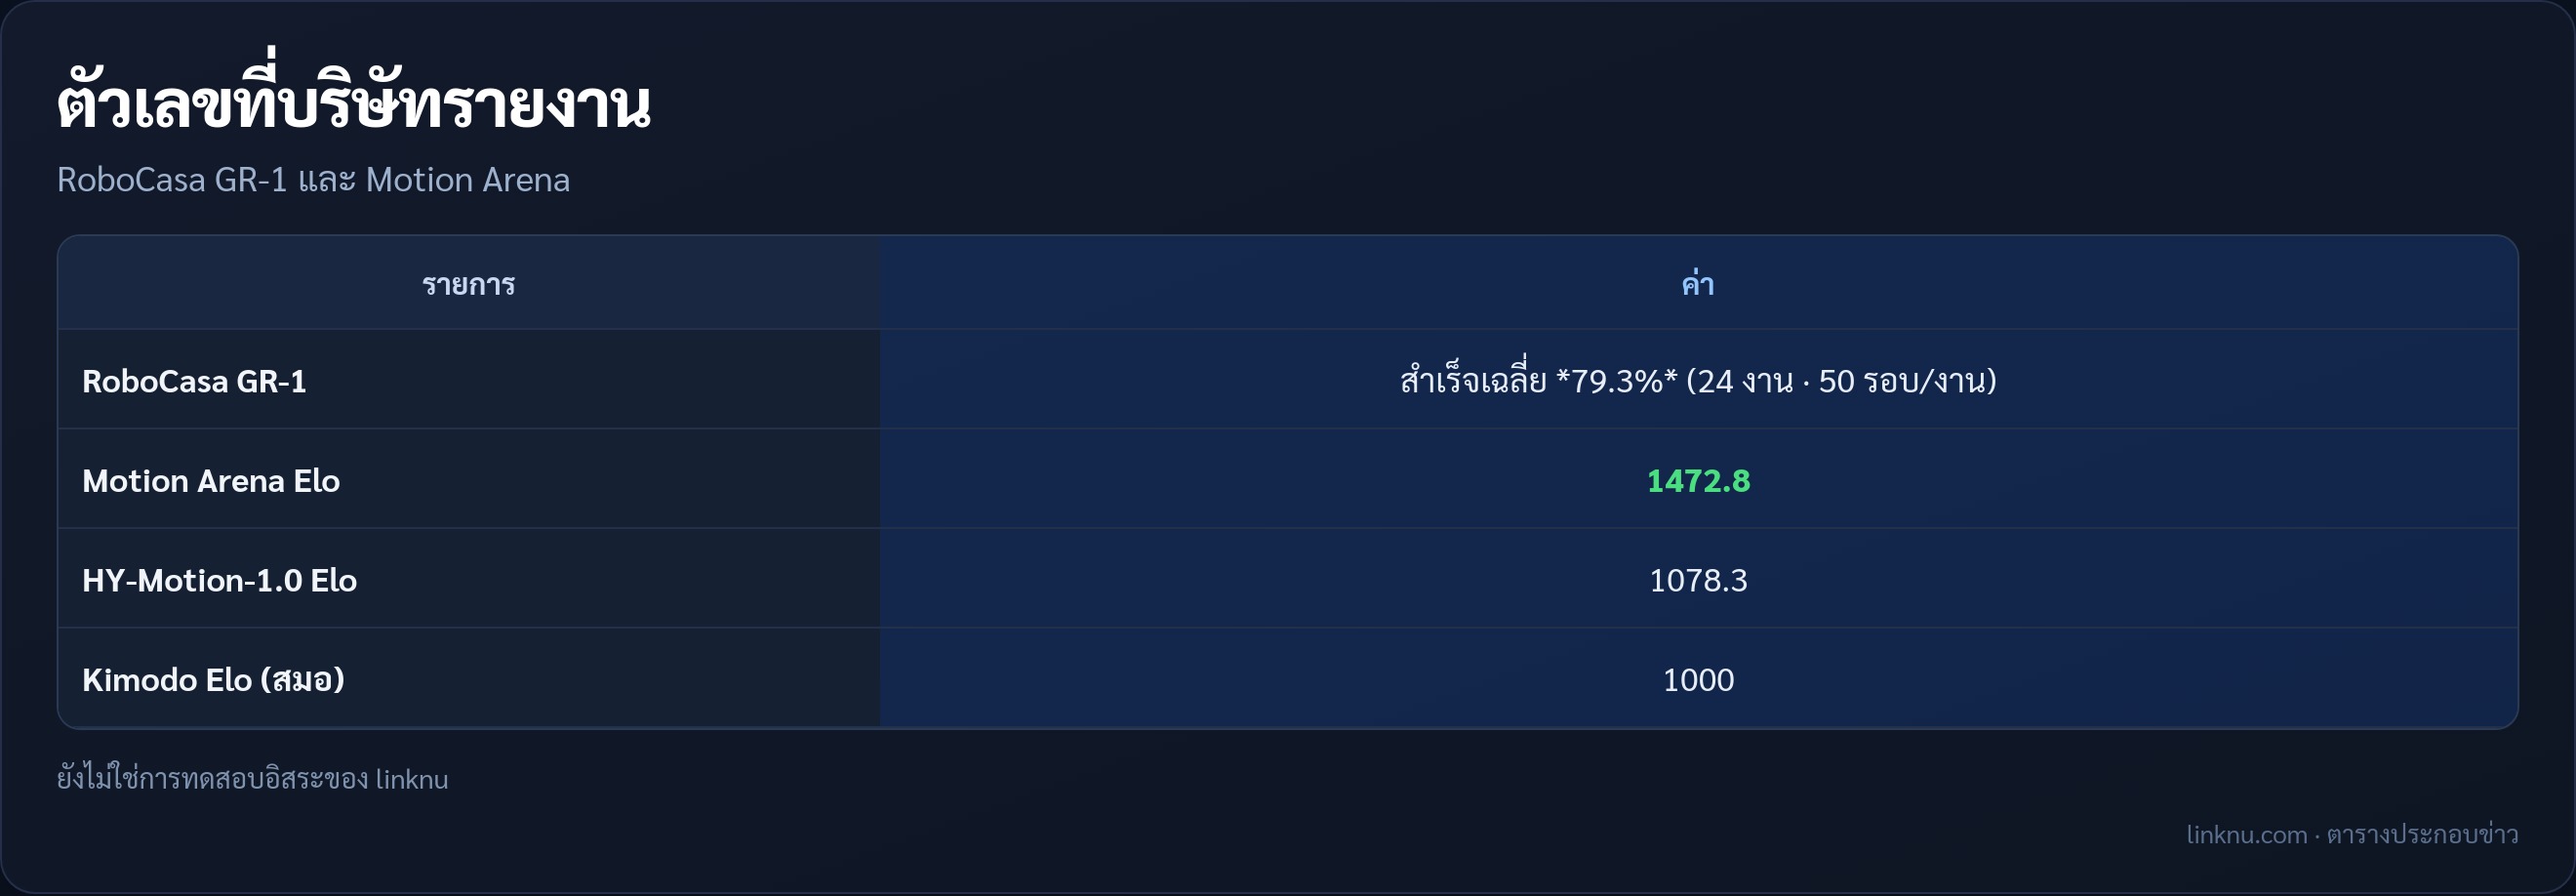
- RoboCasa GR-1 (24 งานครัวจำลอง) สำเร็จเฉลี่ย *79.3%* สูงกว่าเบสไลน์ที่บริษัทเทียบ
- Motion Arena คะแนน Elo *1472.8* นำ HY-Motion-1.0 ที่ 1078.3
- ขนาดพรีเทรนใหญ่ขึ้นแล้วค่าความคลาดเคลื่อนหลังปรับต่อกับข้อมูล egocentric / G1 / LightBot ลดตามเส้นกำลัง
อย่าเข้าใจผิด
- Light-O1 ไม่ใช่รุ่นเดียวกับ LightNav-0 ที่โฟกัสนำทางข้ามประเภทหุ่น
- ตัวเลขเบนช์มาจากบล็อกและข่าวบริษัท ยังไม่ใช่การทดสอบอิสระของ linknu
- น้ำหนักที่เปิดตอนนี้คือ Light-O1-Preview ไม่ใช่เช็กพอยต์พรีเทรนเต็มทุกสเกล
สรุป
อยากได้โมเดลหุ่นที่เรียนจากวิดีโอมนุษย์แล้วถ่ายโอนข้ามร่าง Light Origins เปิด Light-O1 และพรีวิวให้ลองแล้ววันนี้
แหล่ง: Light Origins · PR Newswire · 23 ก.ย. 2026