เกิดอะไรขึ้น
- xAI ประกาศ Grok 4.7 สถานะ GA ใช้งานจริงตั้งแต่วันนี้ (xAI)
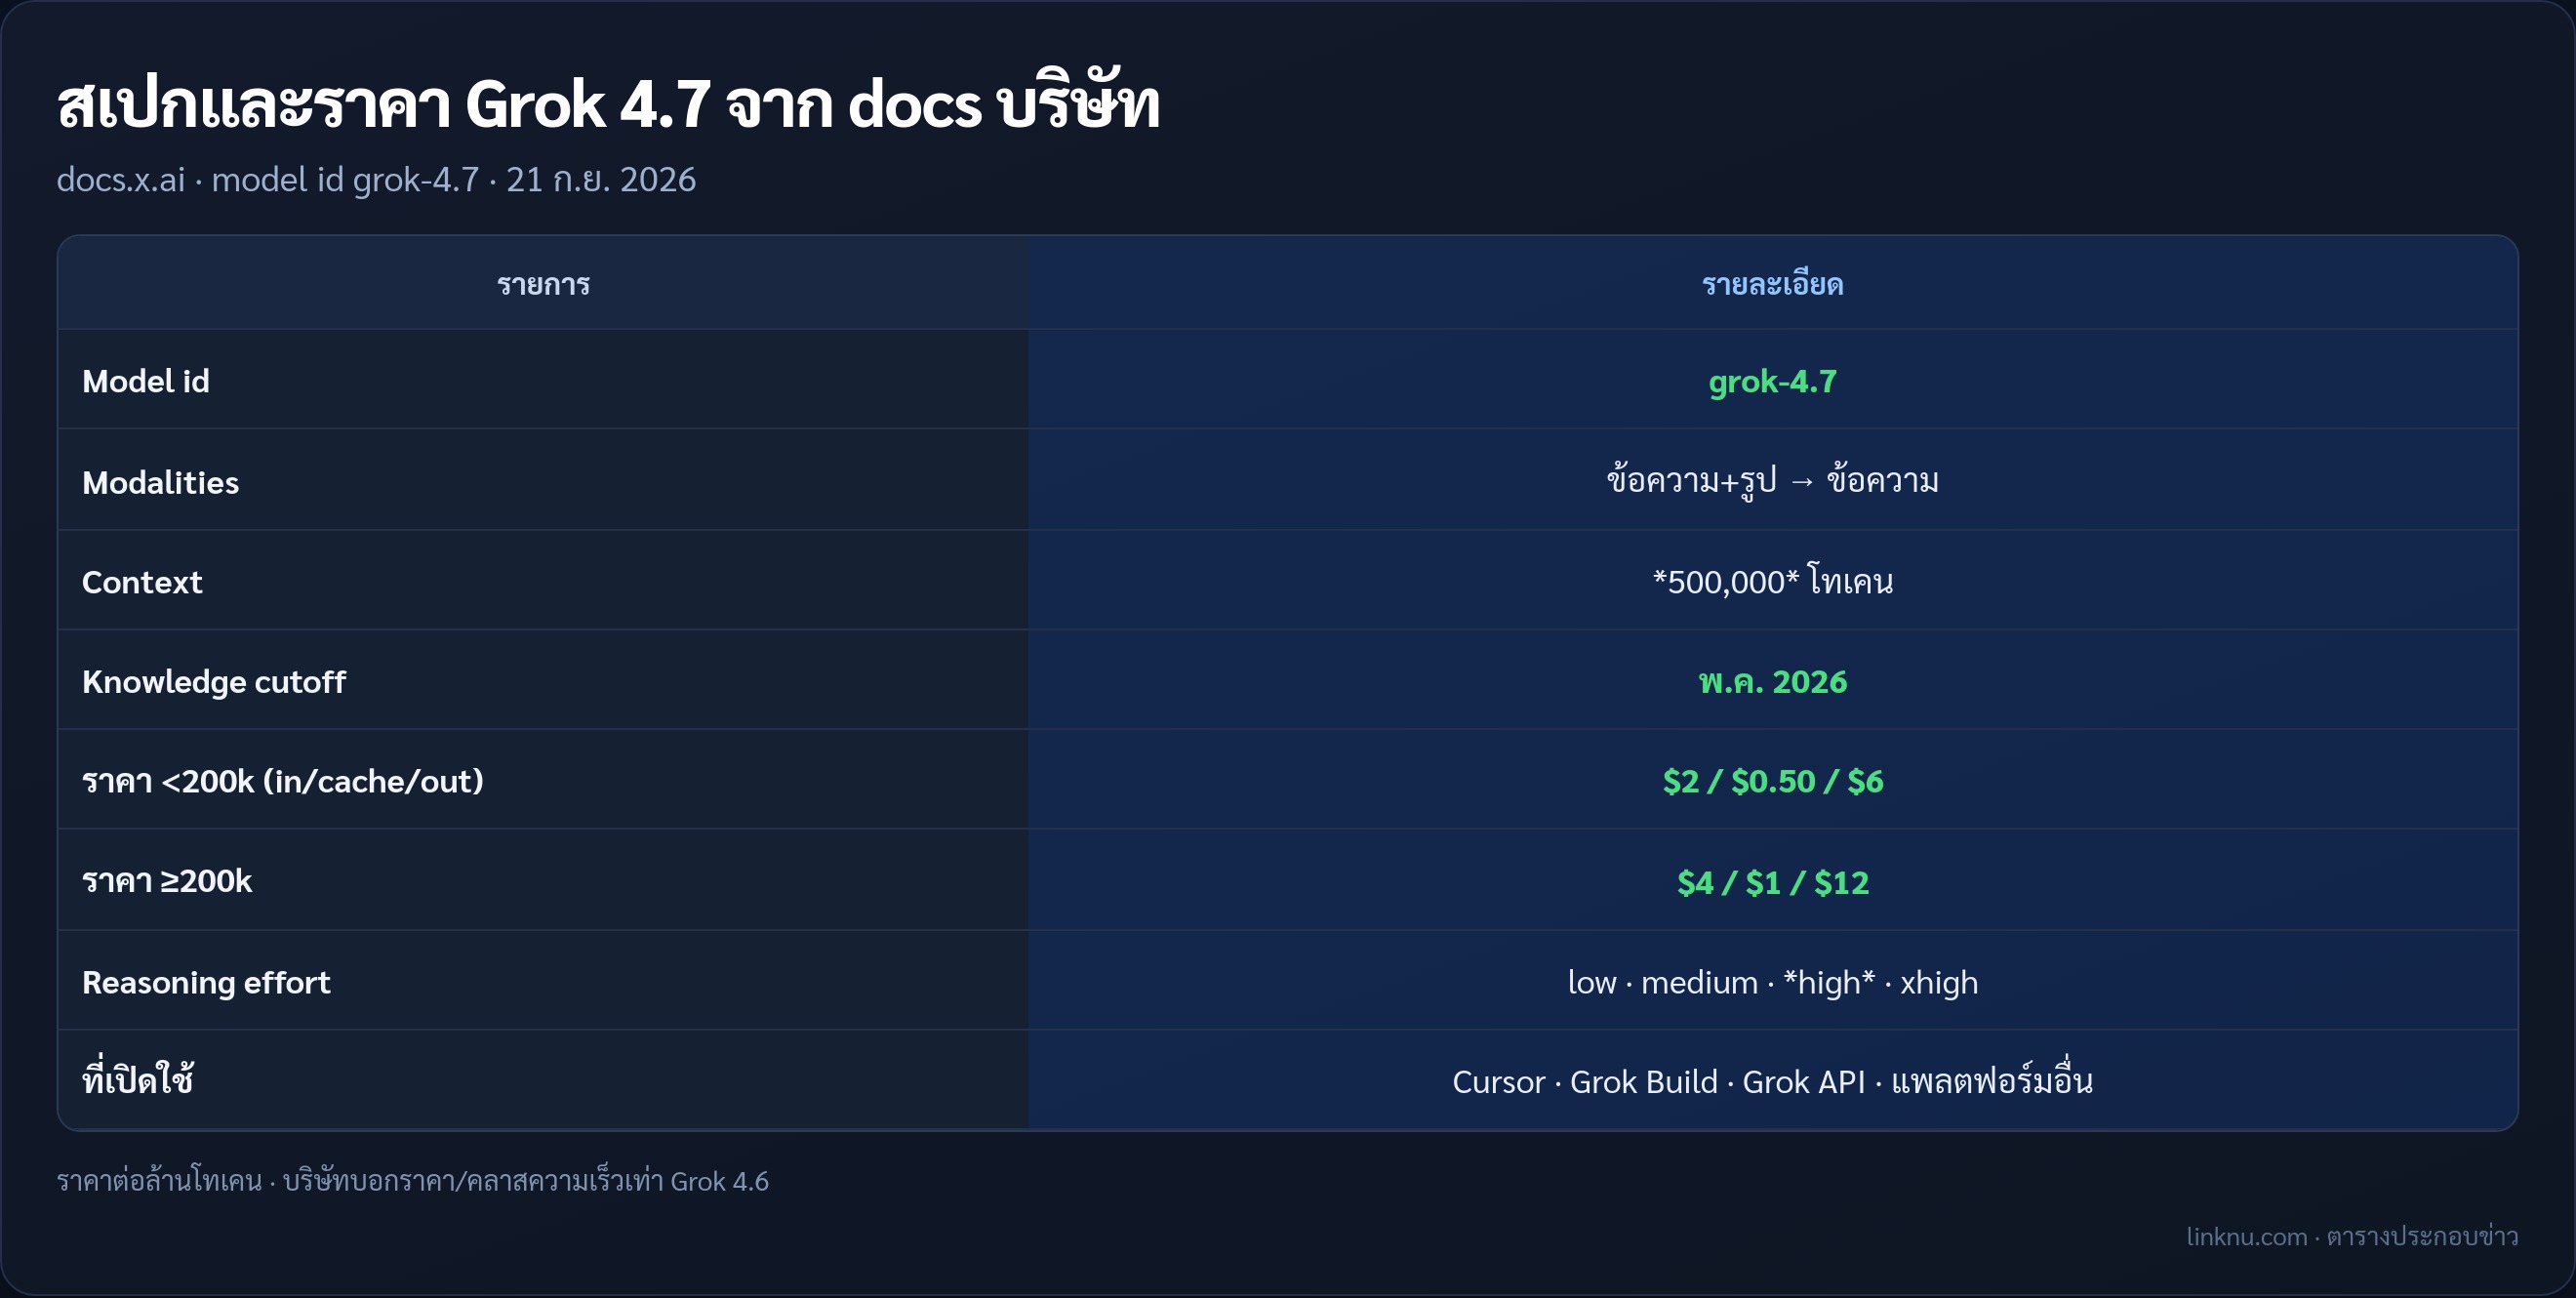
- รับข้อความกับรูปเข้า ตอบออกเป็นข้อความ context 500,000 โทเคน คือความจำที่โมเดลอ่านได้ในครั้งเดียว (docs xAI)
- บริษัทนี้บอกว่าโมเดลใหญ่กว่ารุ่น 4.6 ฝึกต่อด้วย RL นานขึ้น คือการฝึกแบบให้รางวัล (xAI)
- ตัวใหม่เข้าใจ harness ของ Grok Bot โดยตรง คือชุดเครื่องมือที่โมเดลหยิบใช้ทำงาน (xAI)
- เปิดใช้บน Cursor, Grok Build, Grok API คือช่องให้นักพัฒนาเรียกใช้โมเดล รวมถึงแพลตฟอร์มอื่น (xAI)
ตัวเลขและไทม์ไลน์ที่ต้องรู้
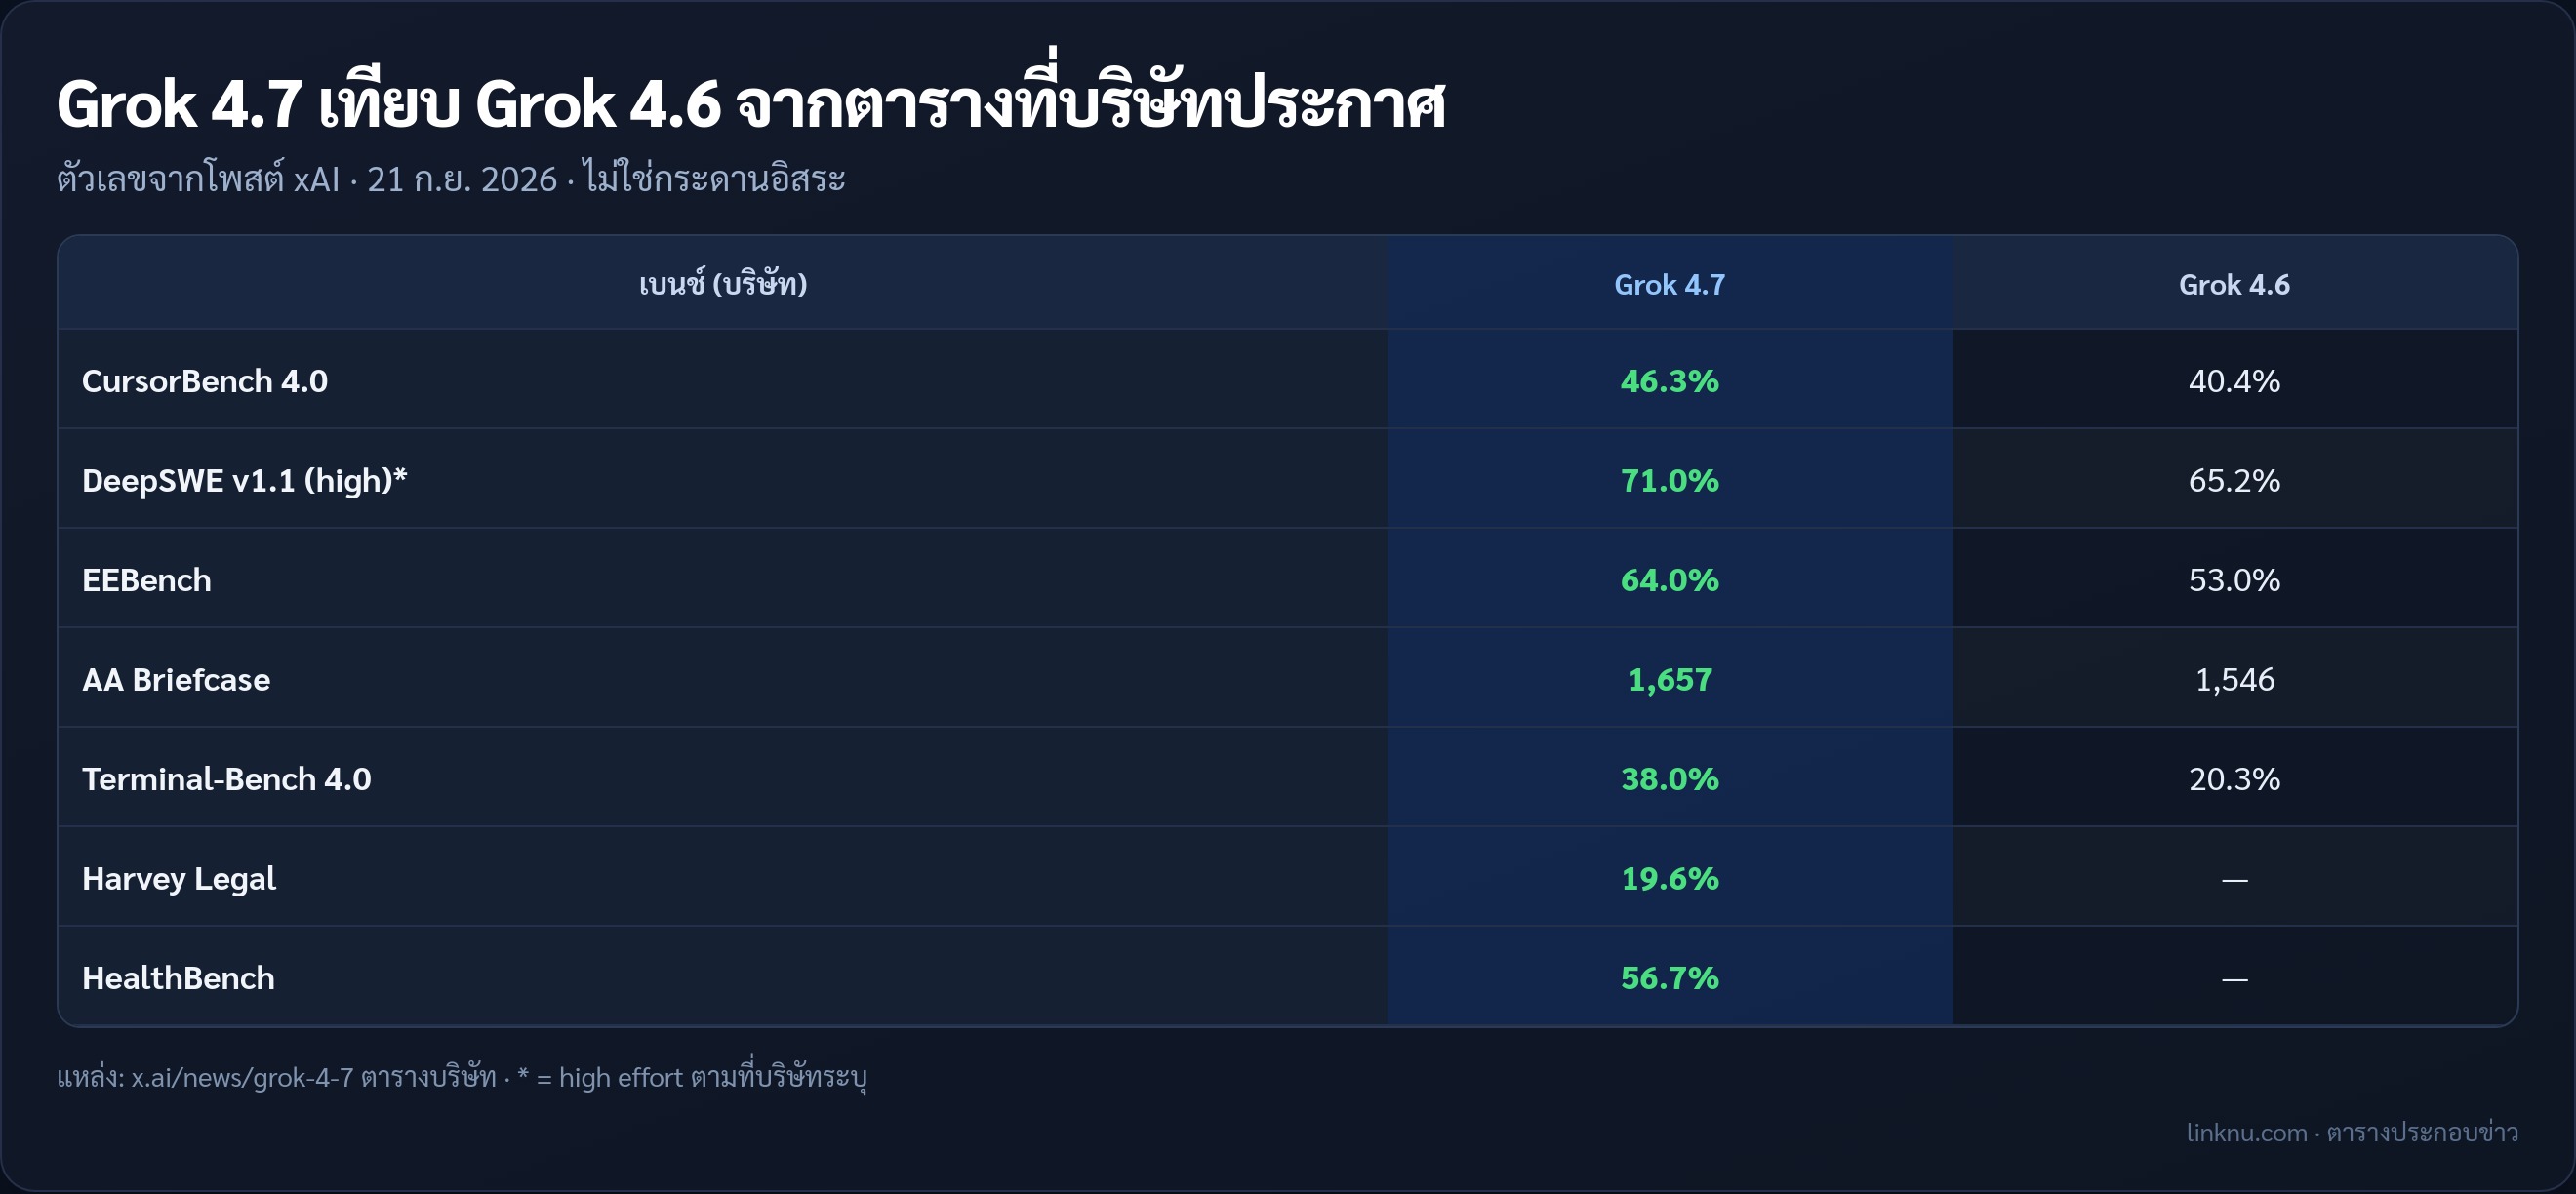
- ตัวเลขชุดนี้มาจากตารางที่บริษัทประกาศเอง CursorBench 4.0 Grok 4.7 ได้ 46.3% รุ่น 4.6 ได้ 40.4% (xAI)
- DeepSWE v1.1 แบบ high effort ได้ 71.0% รุ่นเดิม 65.2% (xAI)
- EEBench 64.0% จากเดิม 53.0% AA Briefcase ทำได้ 1,657 จากเดิม 1,546 (xAI)
- Terminal-Bench 4.0 พุ่งจาก 20.3% เป็น 38.0% ในตารางเดียวกัน (xAI)
- Harvey Legal 19.6% กับ HealthBench 56.7% ก็อยู่ในตารางบริษัท (xAI)
- ความรู้ของโมเดลหยุดที่ พ.ค. 2026 (docs xAI)
ราคาและที่เปิดใช้
- งานสั้นกว่า 200,000 โทเคน ราคาต่อล้านโทเคน input $2 cached $0.50 output $6 (docs xAI)
- งานตั้งแต่ 200,000 ขึ้นไป เป็น $4 $1 $12 บริษัทนี้บอกราคาเท่า Grok 4.6 (docs xAI)
- ปรับระดับความคิดได้ 4 แบบ low medium high xhigh เริ่มที่ high (docs xAI)
- มีตัวแปร fast บริษัทอ้างว่าเร็วขึ้นราว 2 เท่า ราคาราว 2 เท่า (xAI)
- Vercel แจ้งใน changelog ว่ามีโมเดลนี้ให้ใช้แล้ว (Vercel)
อย่าเข้าใจผิด
- คะแนนทุกตัวมาจากตารางที่บริษัทประกาศ ยังไม่ใช่ผลทดสอบจากกระดานอิสระ (xAI)
- ตารางนี้เทียบ GPT-5.6 Sol Max กับ Fable 5.1 Max ด้วย แต่คนจัดตารางคือบริษัทนี้เอง (xAI)
- ความเร็วของตัวแปร fast เป็นคำอ้างของบริษัท ยังไม่มีฝ่ายอื่นวัดซ้ำ (xAI)
สรุป
Grok 4.7 มาแล้วในราคาเดิม ตัวเลขของบริษัทชี้ว่างานเทอร์มินัลเก่งขึ้นเกือบเท่าตัว เอาไปคุยต่อได้ แต่จำไว้ว่าเป็นตารางที่บริษัทวัดเอง
แหล่ง: xAI · 21 ก.ย. 2026