โมเดลนี้ทำอะไรได้
- เป็น base คือรุ่นฐานที่ยังไม่ถูกแต่งให้คุยเป็นแชท เอาไปฝึกต่อเป็นผู้ช่วยหรือเอเจนต์ได้เอง
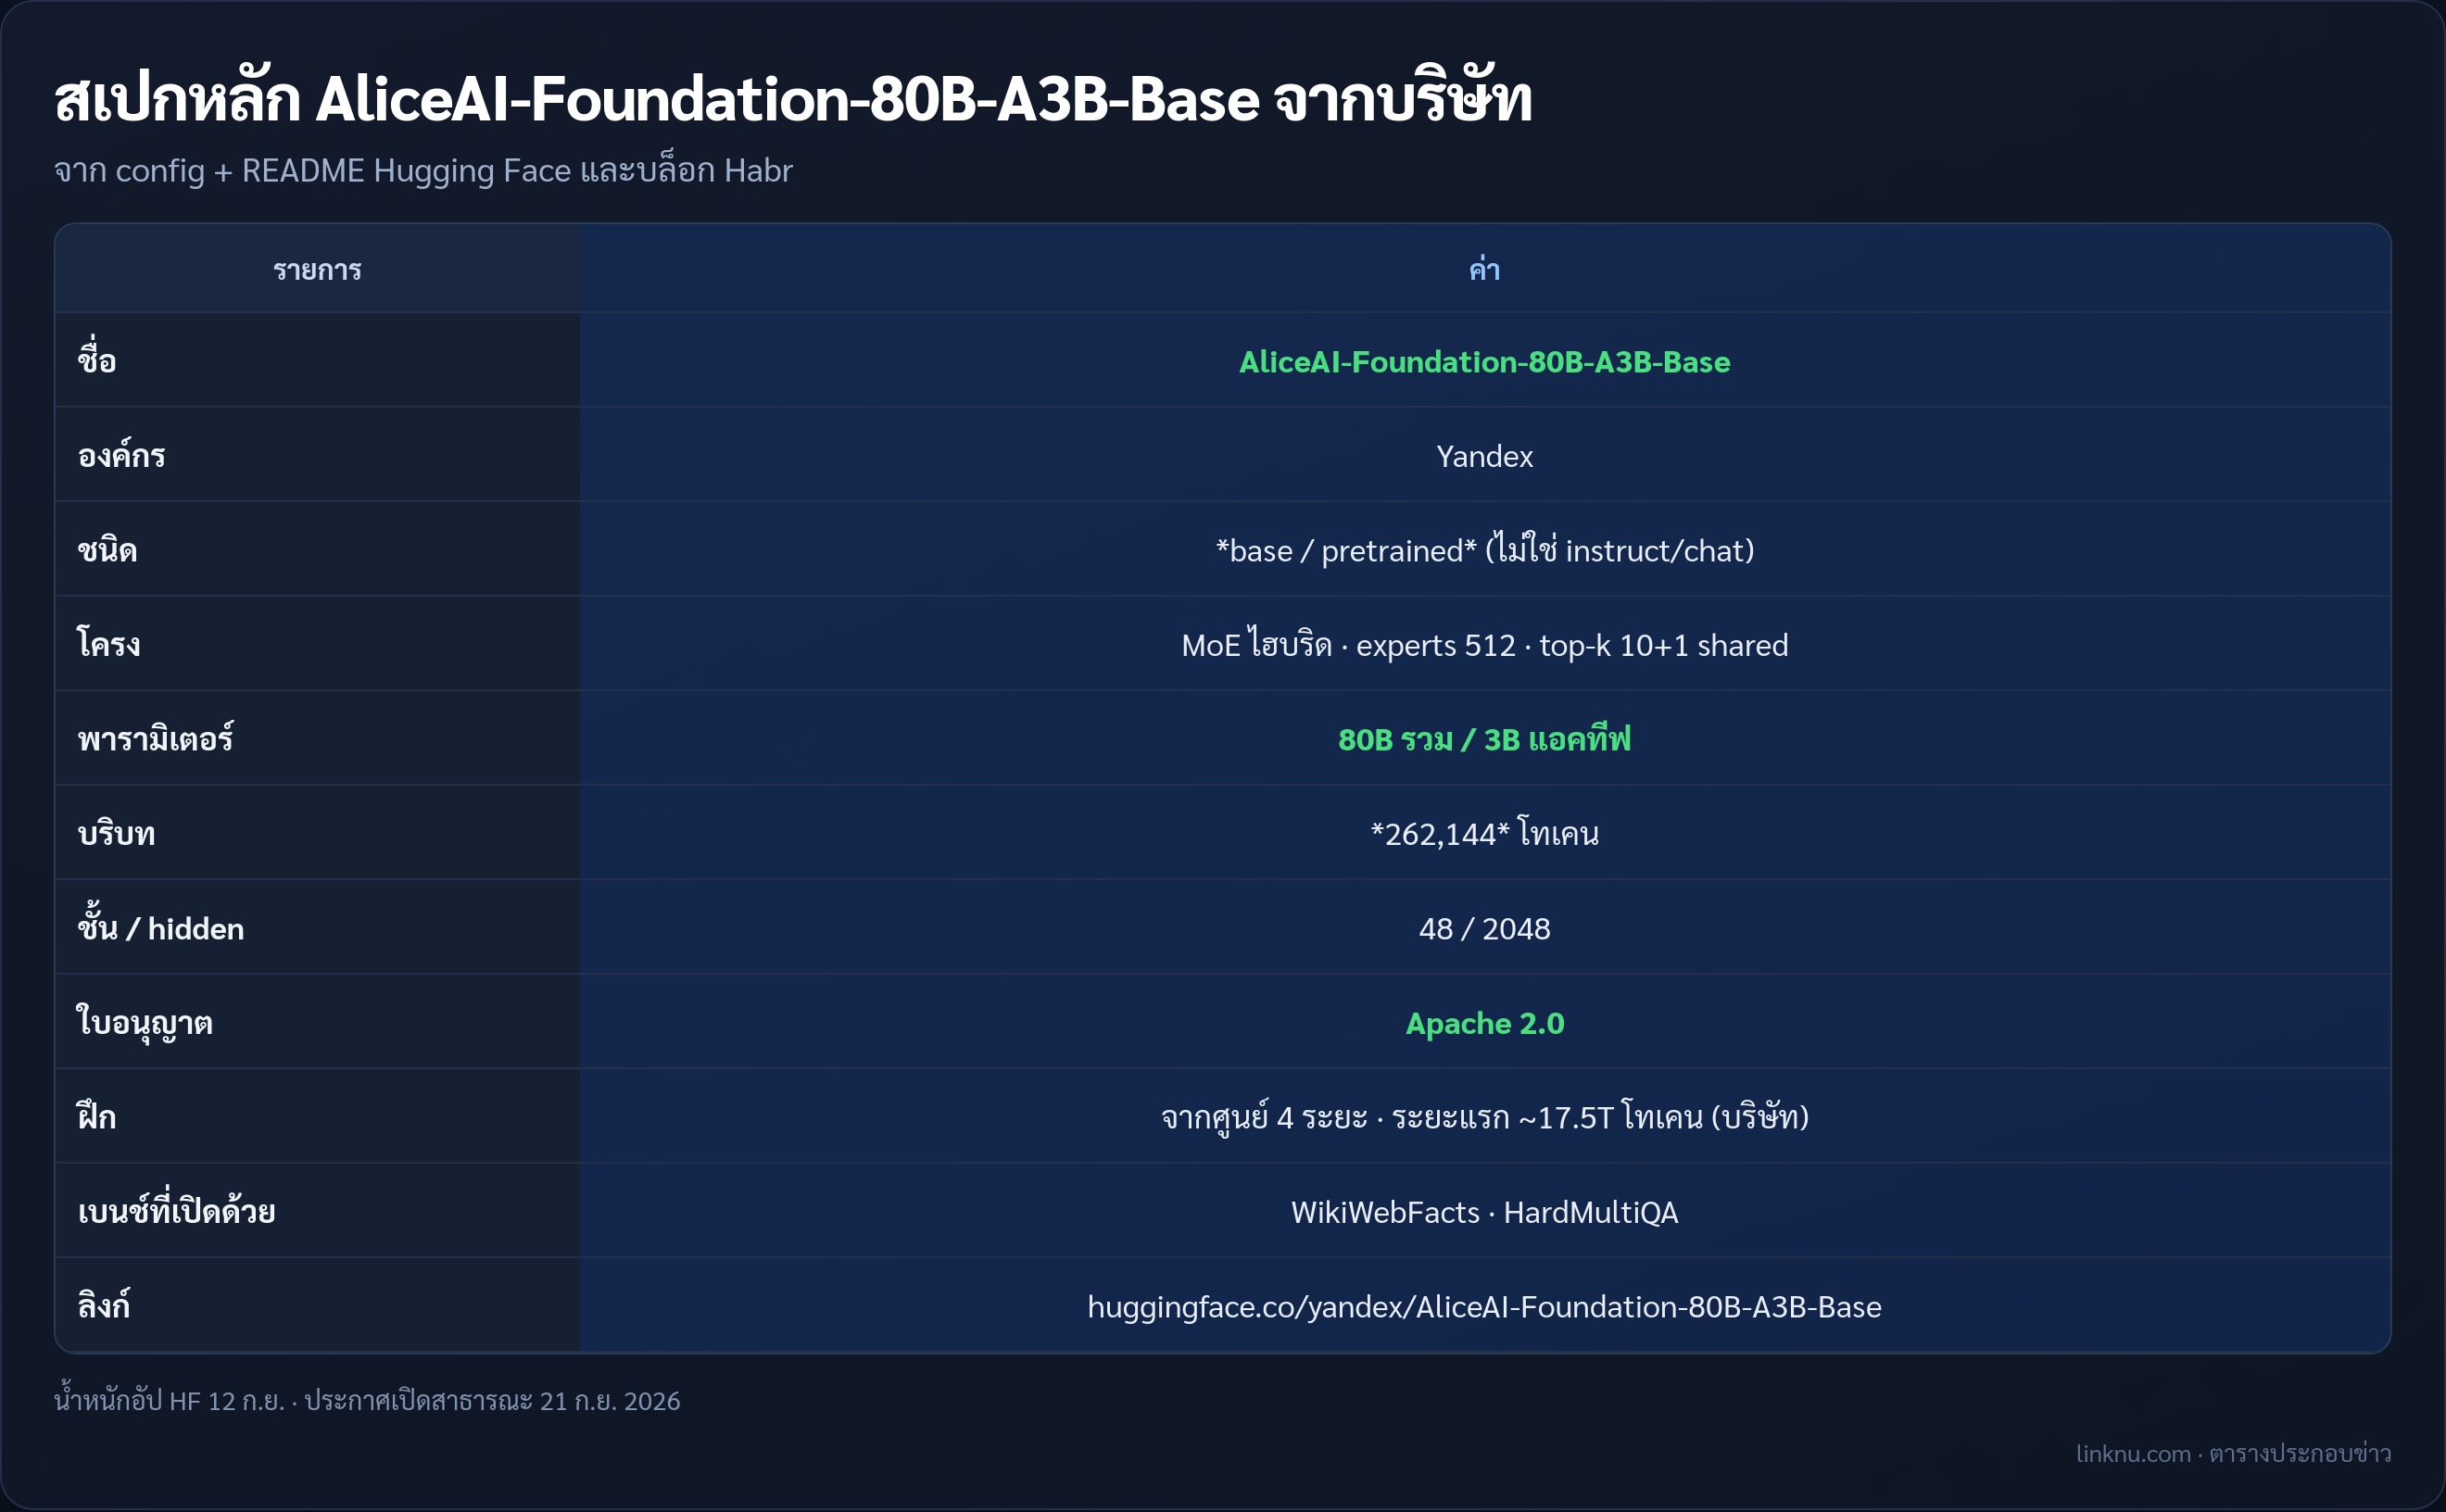
- ใช้โครง MoE คือเลือกผู้เชี่ยวชาญมาทำงานทีละส่วน พารามิเตอร์รวม 80B แต่จ่ายจริงราว 3B ต่อโทเคน รันเบากว่าที่ตัวเลขดู
- ความจำยาว context ถึง 262,144 โทเคน อ่านเอกสารยาว ๆ ได้ในครั้งเดียว
- แข็งภาษารัสเซียกับอังกฤษ และเป็นฐานของโมเดลคิดรวมรุ่นหน้ากับเอเจนต์ของ Alice AI (Yandex Habr 21 ก.ย.)
ตัวเลขที่บริษัทประกาศ
- ฝึกต่อเนื่อง 4 ระยะ ระยะแรกกลืนข้อมูลทั่วไปราว 17.5 ล้านล้านโทเคน ก่อนขยายความจำจาก 8K ไป 32K และ 256K แล้วปิดท้ายด้วยช่วงฝึกให้คิดแบบเอเจนต์ที่ลดความจำเหลือ 128K (บริษัทเล่าเอง)
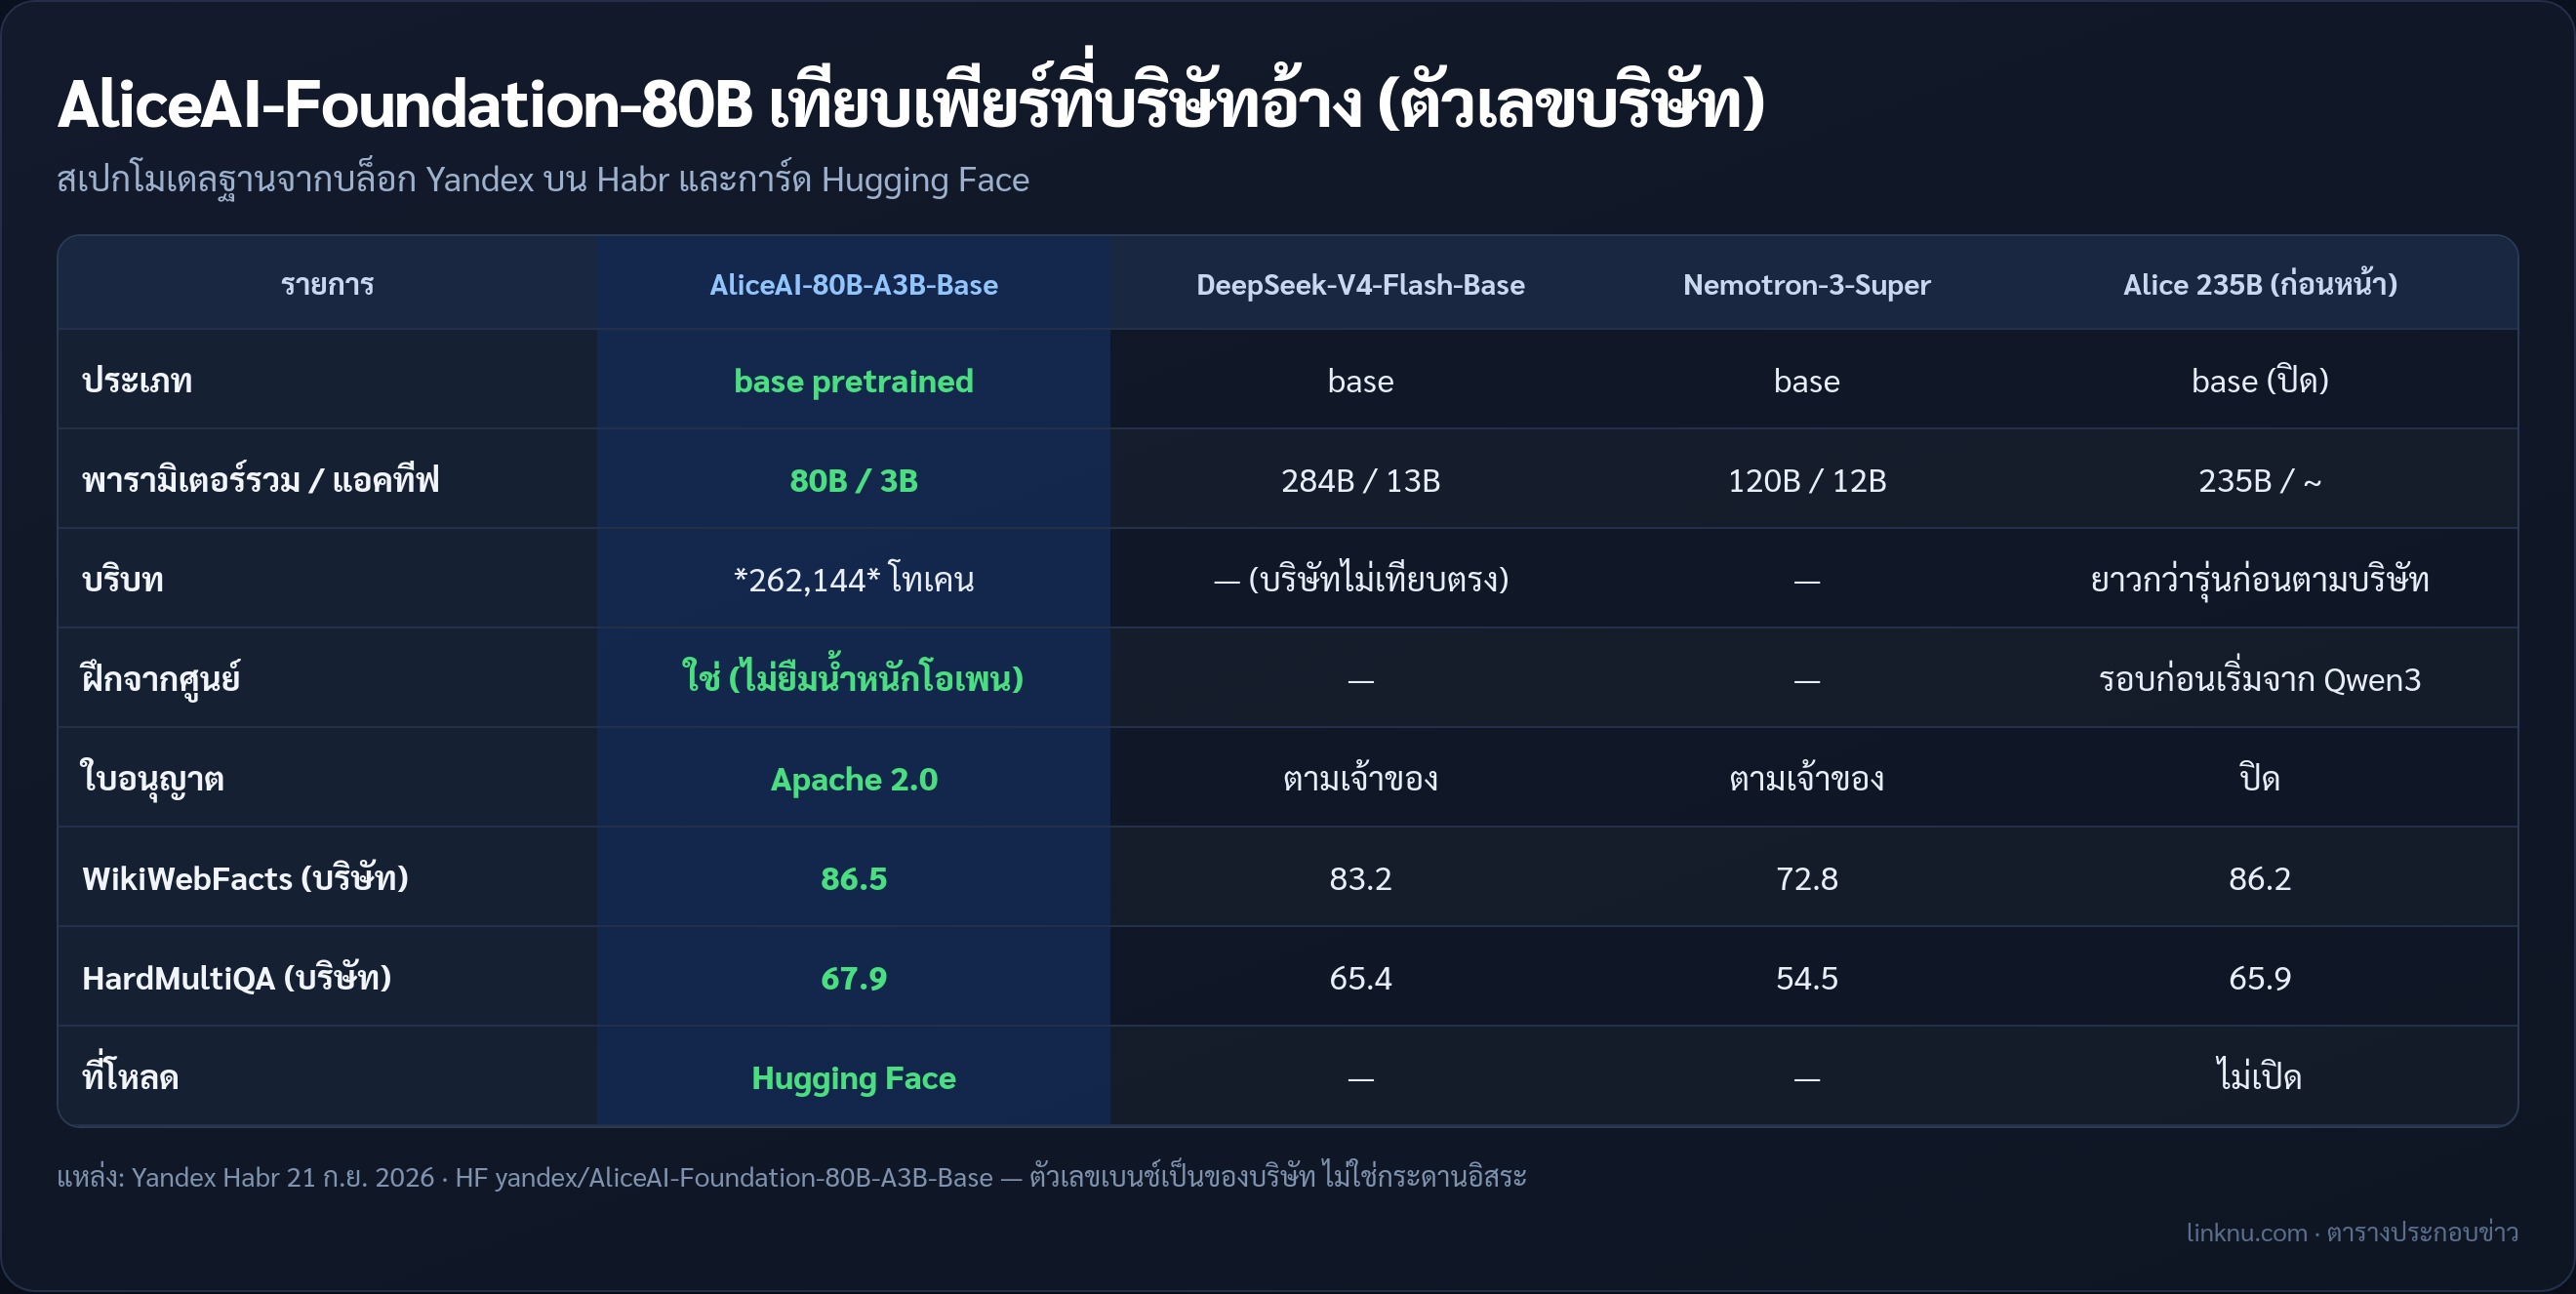
- บริษัทวัดเทียบภายในแล้วอ้างว่าชนะ DeepSeek-V4-Flash-Base ตัว 284B กับ Nemotron-3-Super ตัว 120B ได้หลายงาน รวมถึงเทียบ GLM-4.5-Air-Base และ Qwen3.5-35B-A3B-Base ด้วย (ตัวเลขนี้บริษัทประกาศเอง)
- แรงกว่า Alice AI LLM 235B รุ่นปิดเมื่อปีก่อน ทั้งที่พารามิเตอร์รวมน้อยกว่าราว 3 เท่า และตัวที่ทำงานจริงน้อยกว่าราว 7 เท่า (บริษัทประกาศเอง)
อย่าเข้าใจผิด
- โหลดมาแล้วคุยกับมันเลยไม่ได้ เพราะไม่มีส่วนแต่งให้เป็นแชท ต้องฝึกต่อเองก่อน
- น้ำหนักขึ้น Hugging Face ไปแล้วตั้งแต่ 12 ก.ย. แต่วันประกาศเปิดอย่างเป็นทางการคือ 21 ก.ย. 2026
- ต่างจากรอบก่อนที่ Yandex เคยเริ่มจากต่อยอด Qwen3 ครั้งนี้ฝึกใหม่จากศูนย์ทั้งหมด ไม่ยืมน้ำหนักโอเพนของแล็บอื่นมาตั้งต้น
ที่โหลดได้
- โหลดฟรีบน Hugging Face ที่ yandex/AliceAI-Foundation-80B-A3B-Base ใบอนุญาต Apache 2.0 ใช้การค้าได้
- รองรับการรันผ่าน Transformers และ vLLM ตั้งแต่แรก
- ได้ชุดวัดความรู้จริง WikiWebFacts กับ HardMultiQA ที่เน้นภาษารัสเซีย พร้อมวิธีวัดผลครบ เปิดให้ทุกคนใช้ด้วย
สรุป
Yandex ครั้งนี้ไม่ได้แค่แจกน้ำหนัก แต่แจกทั้งชุดวัดผลและเล่าวิธีฝึกแบบละเอียด ทีมไหนทำงานกับภาษารัสเซียควรลองโหลดมาเล่นดู
แหล่ง: Yandex · Habr · 21 ก.ย. 2026