โมเดลนี้ทำอะไรได้
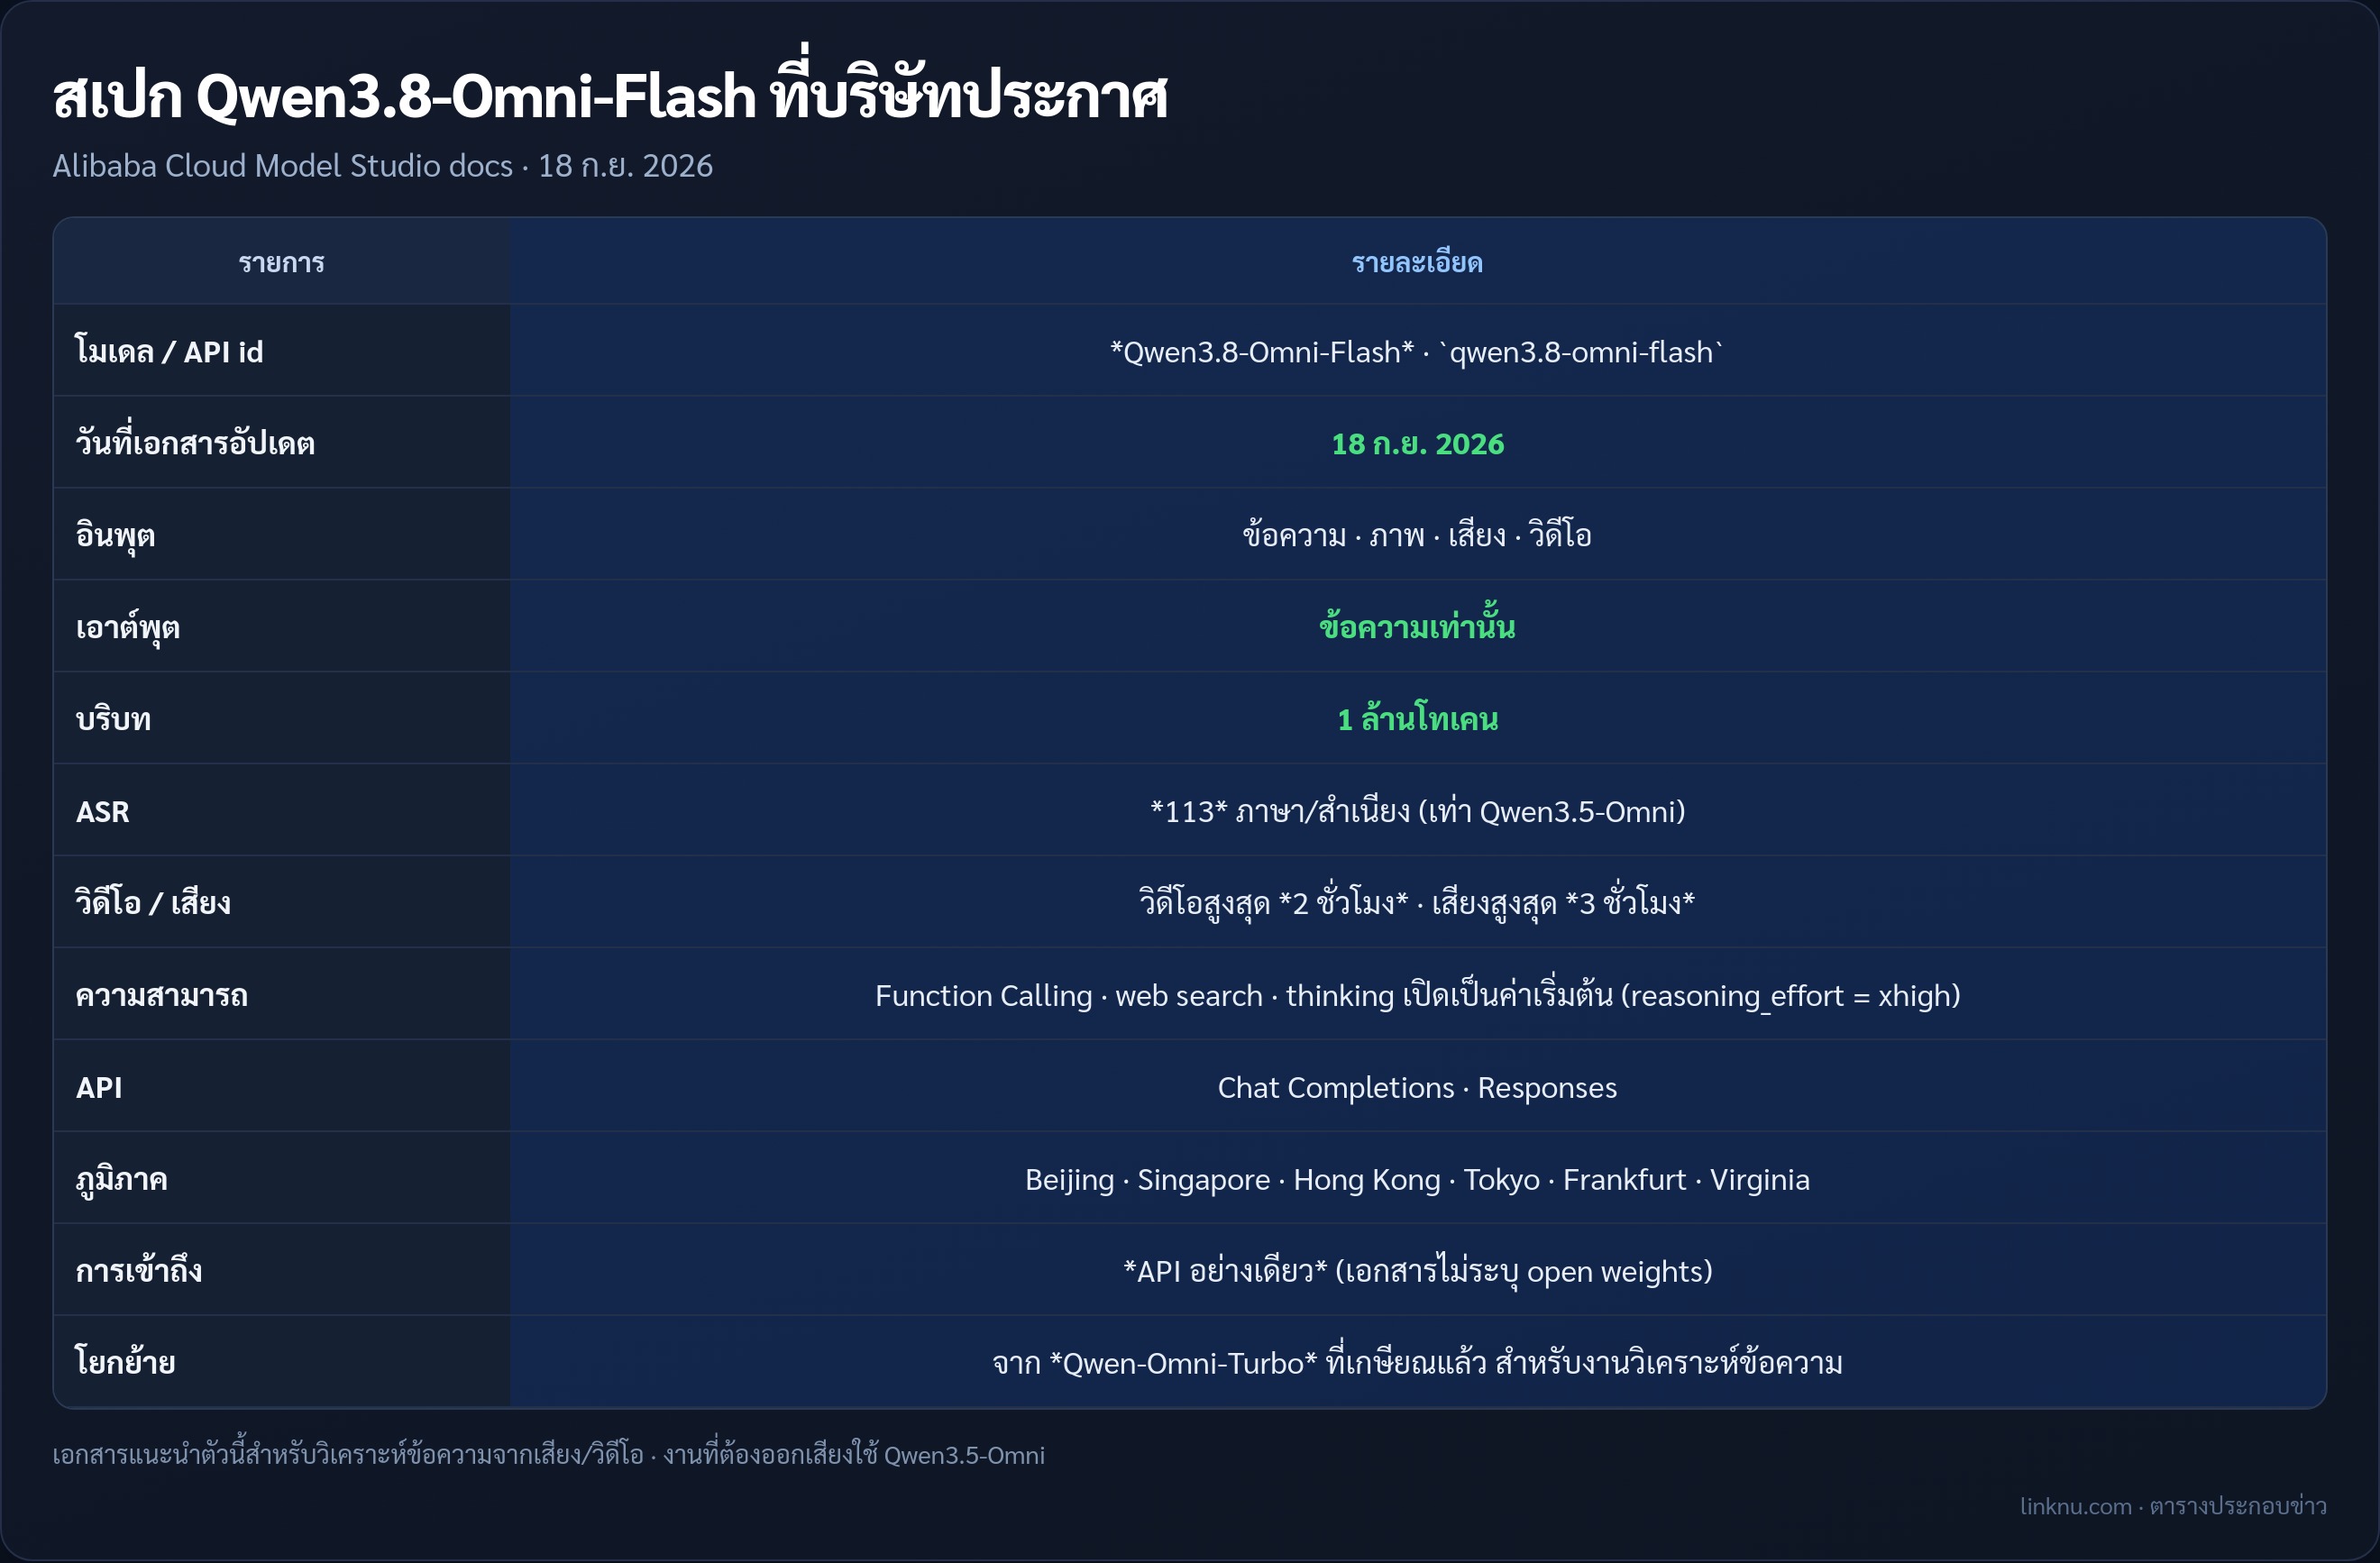
- รับอินพุตสี่แบบ ข้อความ ภาพ เสียง วิดีโอ แต่ตอบออกมาเป็นข้อความอย่างเดียว (Alibaba Cloud docs 18 ก.ย.)
- ถอดเสียงพูดเป็นตัวหนังสือได้ 113 ภาษาและสำเนียง
- วิดีโอยาวได้ถึง 2 ชั่วโมง เสียงยาวได้ถึง 3 ชั่วโมง
- มี context คือความจำยาวของโมเดล ถึง 1 ล้านโทเคน
การคิดกับเครื่องมือเสริม
- โหมด thinking เปิดมาตั้งแต่ค่าเริ่มต้น ระดับ reasoning_effort ตั้งไว้ xhigh
- ต่อ Function Calling ได้ คือให้โมเดลเรียกใช้เครื่องมือภายนอกเอง
- ค้นเว็บด้วย web search ได้ในตัว
ราคาและที่เปิดใช้
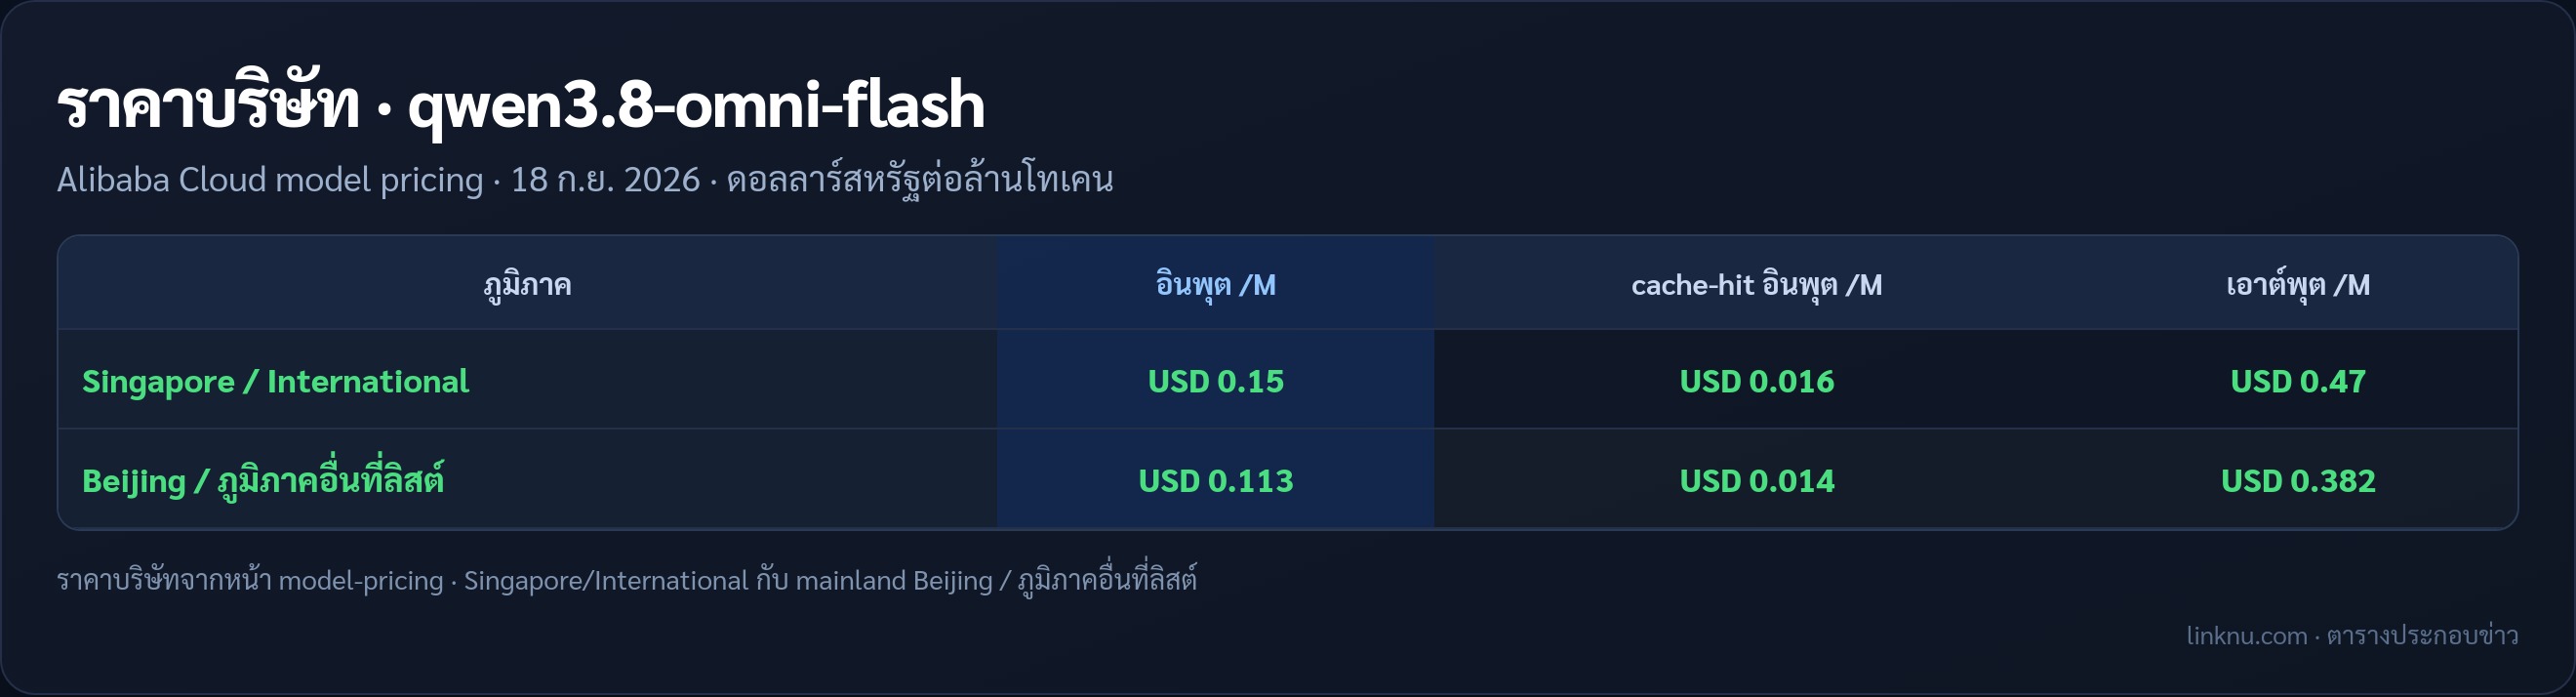
- Singapore กับ International อินพุต USD 0.15 ต่อล้านโทเคน เอาต์พุต USD 0.47 cache-hit อินพุต USD 0.016
- Beijing และภูมิภาคอื่นที่ลิสต์ อินพุต USD 0.113 เอาต์พุต USD 0.382 cache-hit USD 0.014 แพงกว่าถูกกว่านิดเดียว cache-hit คือข้อมูลที่เคยประมวลแล้ว เรียกซ้ำได้ถูกกว่ามาก
- เปิด 6 ภูมิภาค China (Beijing), Singapore, China (Hong Kong), Japan (Tokyo), Germany (Frankfurt), US (Virginia)
- เรียกใช้ผ่าน API แบบ Chat Completions กับ Responses
อย่าเข้าใจผิด
- ตัวนี้ไม่เปล่งเสียงพูด ถ้างานต้องได้เสียงตอบ เอกสารแนะนำ Qwen3.5-Omni แทน
- ใช้ผ่าน API อย่างเดียว เอกสารทางการไม่ได้พูดถึง open weights
- ใครยังติด Qwen-Omni-Turbo อยู่ ตัวนั้นเกษียณไปแล้ว ให้ย้ายมา Qwen3.8-Omni-Flash สำหรับงานวิเคราะห์ข้อความจากเสียงกับวิดีโอ
สรุป
งานไหนต้องให้ AI ฟัง ดู อ่าน แล้วตอบเป็นตัวหนังสือ Qwen3.8-Omni-Flash คือชื่อที่ Alibaba Cloud แนะนำ ส่วนงานที่ต้องให้ AI พูดออกเสียง ให้ไปดู Qwen3.5-Omni คนละตัวกัน
แหล่ง: Alibaba Cloud · 18 ก.ย. 2026