เกิดอะไรขึ้น
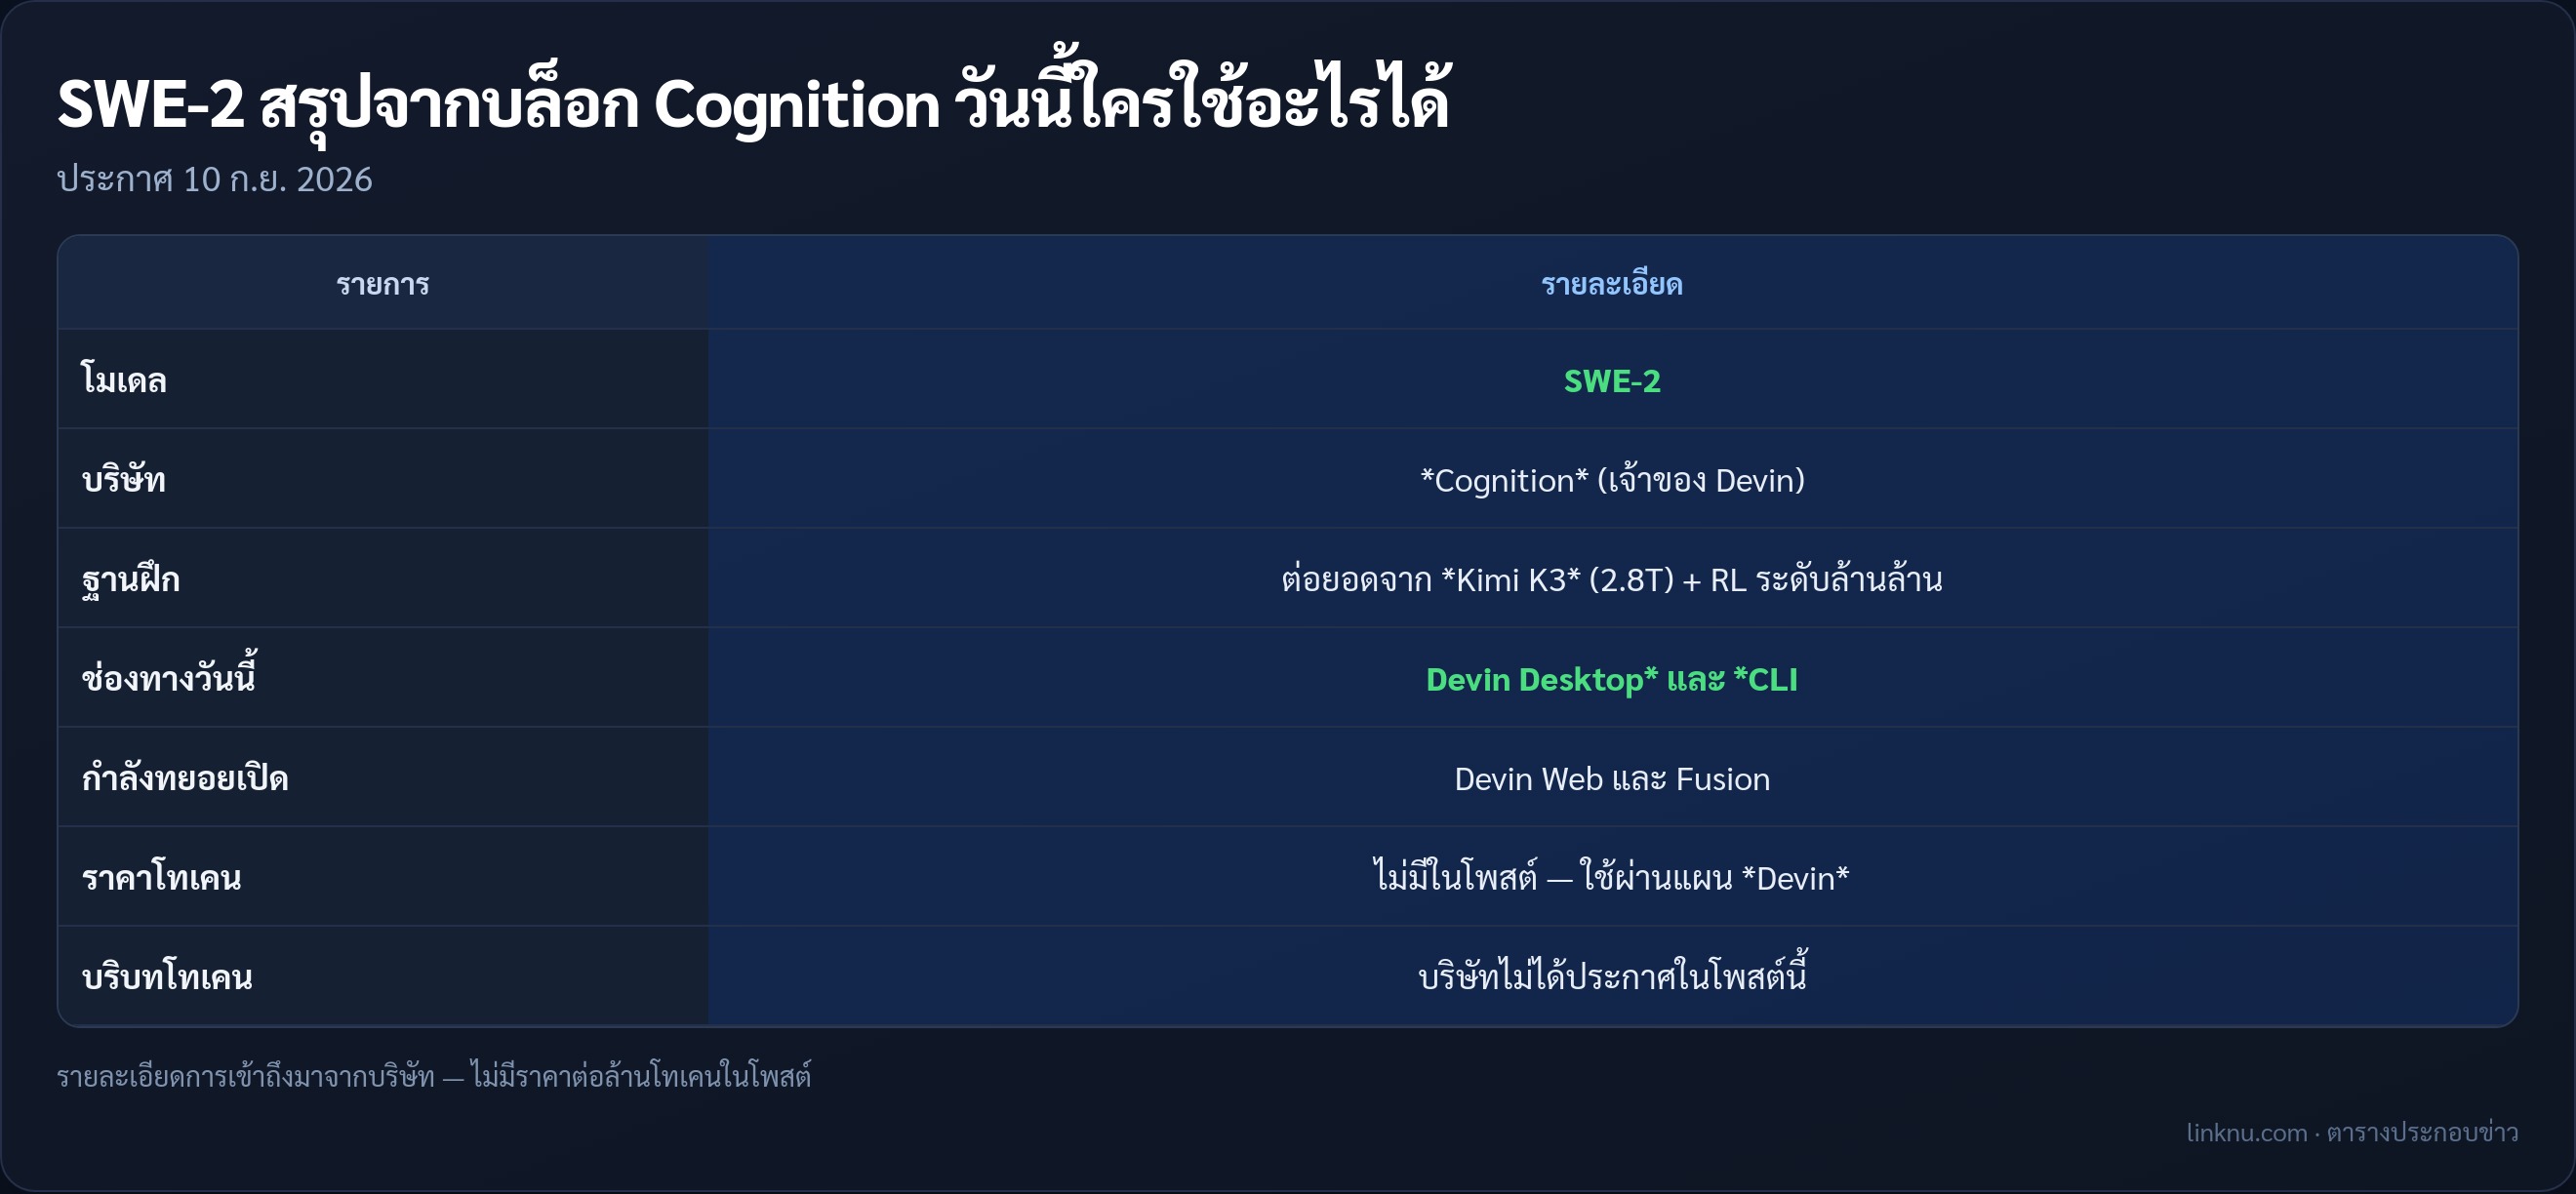
- Cognition ลงบล็อกประกาศเปิดตัว SWE-2 โดยเรียกมันว่าโมเดลเขียนโค้ดที่ก้าวหน้าที่สุดของบริษัทจนถึงวันนี้
- โมเดลตัวนี้ต่อยอดจาก Kimi K3 โมเดลตั้งต้นขนาด 2.8 ล้านล้านพารามิเตอร์ แล้วฝึกเสริมด้วยวิธี RL คือให้โมเดลลองทำโจทย์ไปเรื่อย ๆ ทำได้ก็ได้รางวัลแล้วปรับตัวตาม บริษัทบอกว่าขยายการฝึกแบบนี้ถึงระดับล้านล้านรอบ
- วันนี้ใช้ได้เลยใน Devin Desktop กับ CLI (หน้าจอพิมพ์คำสั่ง) ส่วน Devin Web กับ Fusion กำลังทยอยเปิดตามมา
ตัวเลขที่บริษัทเผย
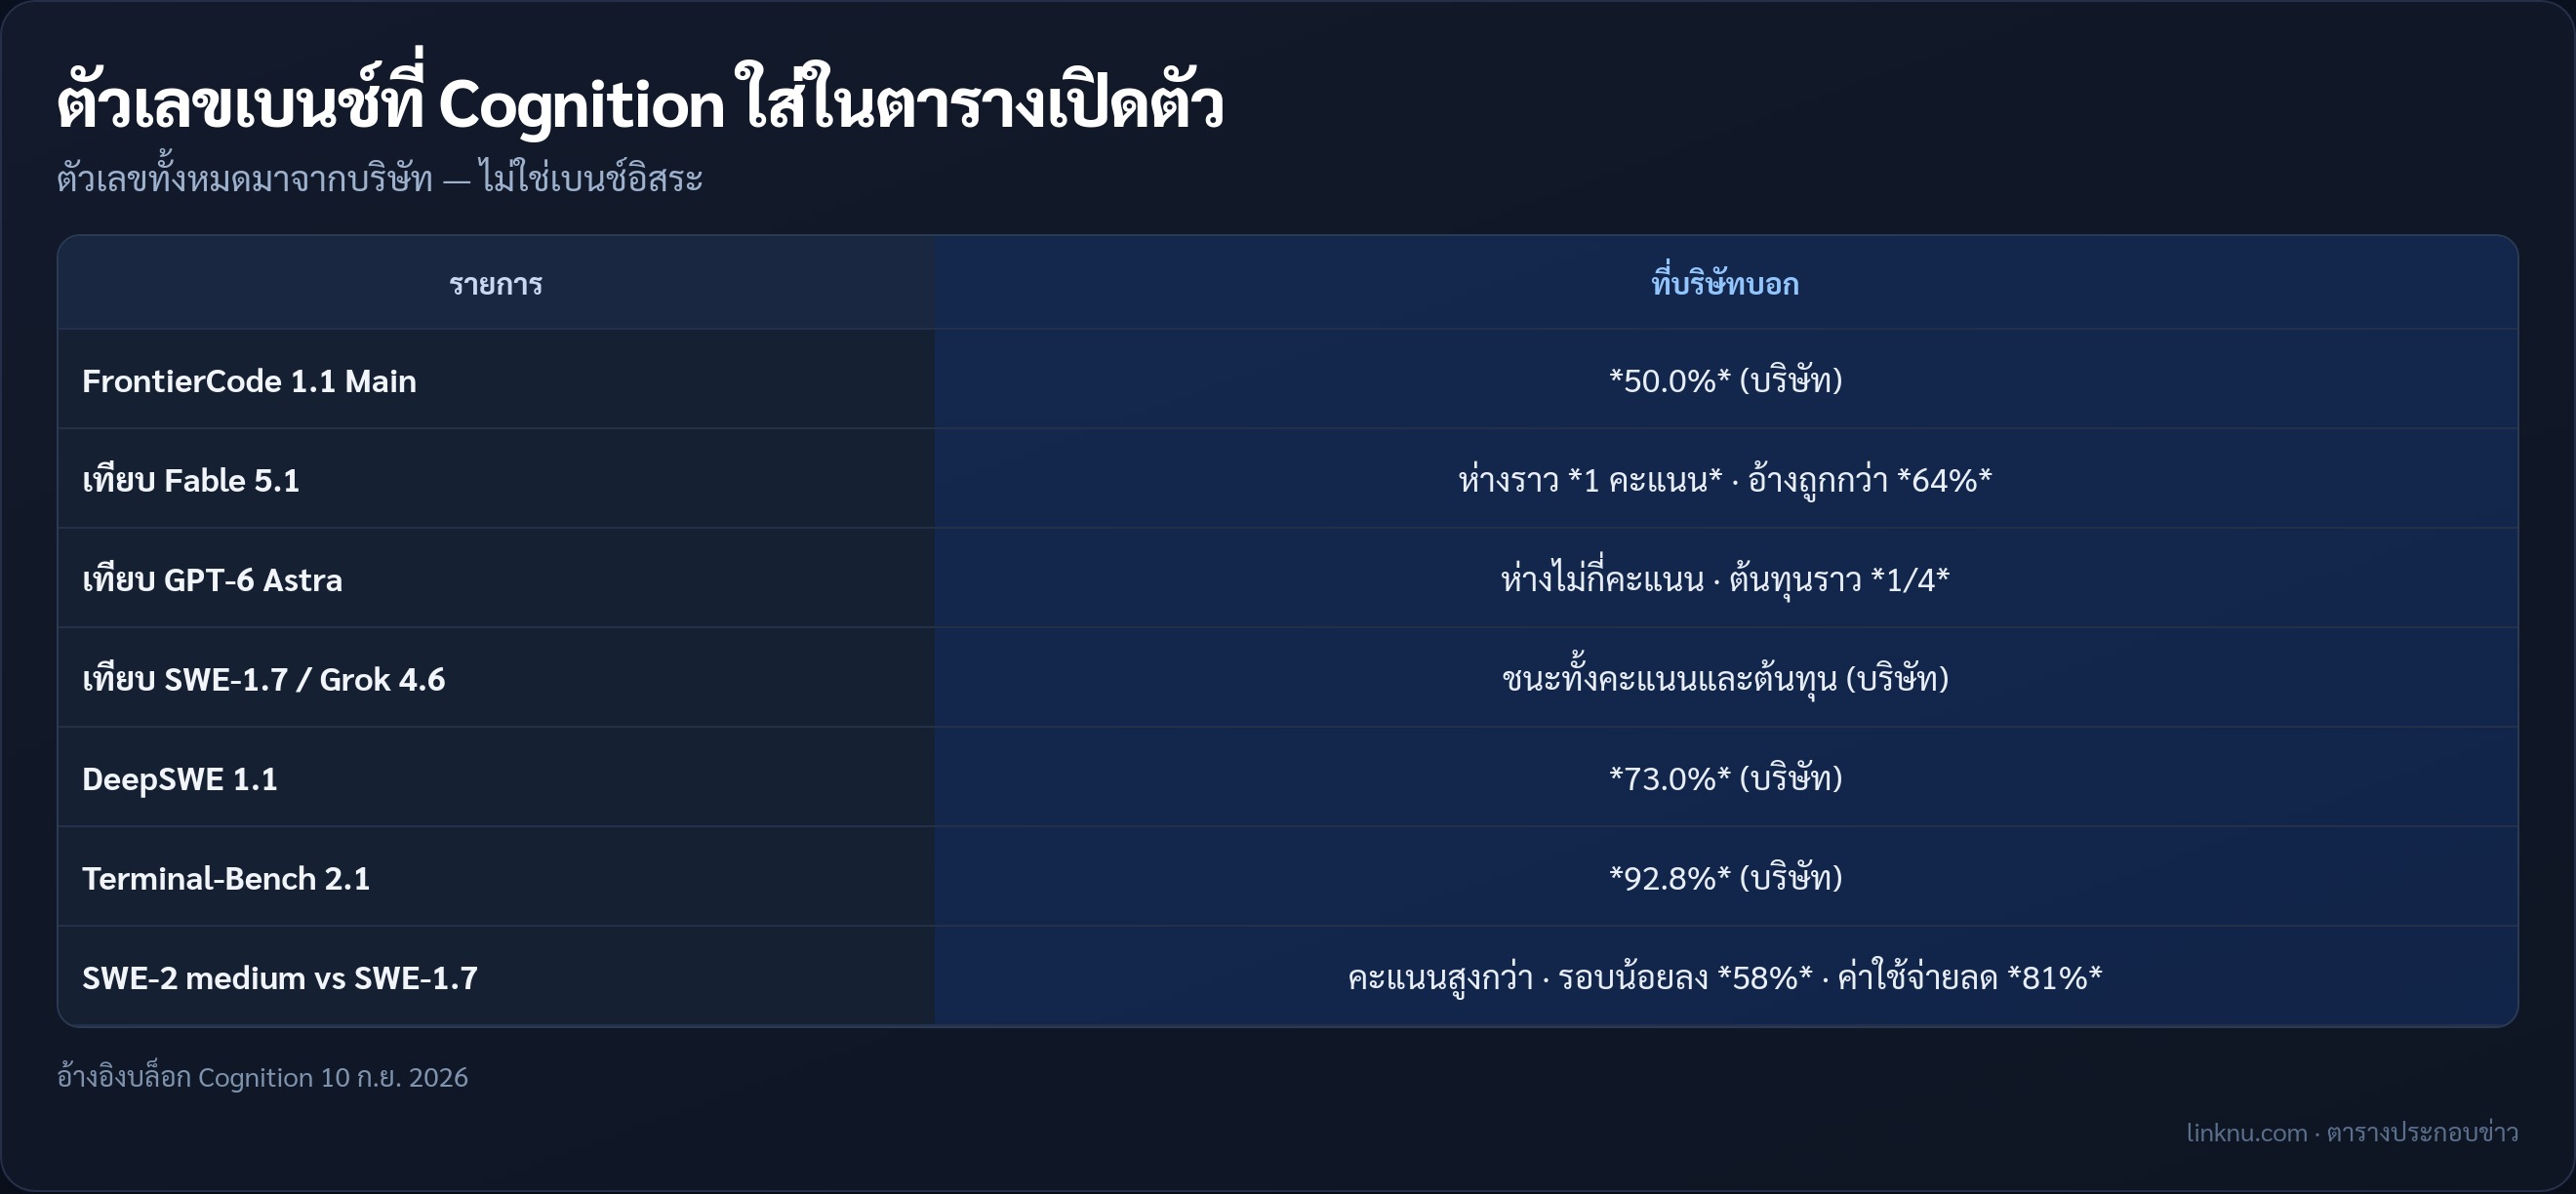
- ทำคะแนน 50.0% บนข้อสอบงานโค้ดจริงชื่อ FrontierCode 1.1 Main (ตัวเลขจากบริษัท)
- ห่างจาก Anthropic Fable 5.1 แค่ราว 1 คะแนน โดยบริษัทอ้างว่าถูกกว่าถึง 64%
- เทียบ GPT-6 Astra บริษัทบอกว่าห่างไม่กี่คะแนน ที่ต้นทุนราวหนึ่งในสี่
- ชนะ SWE-1.7 กับ Grok 4.6 ทั้งด้านคะแนนและต้นทุน
- ตารางในบล็อกยังระบุ DeepSWE 1.1 ที่ 73.0% กับ Terminal-Bench 2.1 ที่ 92.8%
ทำอะไรได้ดีขึ้น
- บนเกณฑ์ FrontierCode บริษัทเทียบรุ่น medium กับ SWE-1.7 แล้วพบว่าได้คะแนนสูงกว่า
- ใช้รอบการทำงานน้อยลง 58% คือโมเดลไม่ต้องลองไปลองมาหลายรอบกว่าจะจบงาน
- ค่าใช้จ่ายต่องานลดลง 81%
ราคาเท่าไหร่
- โพสต์นี้ไม่มีราคาต่อล้านโทเคน โทเคนคือหน่วยที่โมเดลอ่านงานเป็นชิ้น ๆ
- ทางเข้าคือแผนของ Devin คิดตามการใช้งาน ไม่มีตารางราคาโทเคนแยกมาให้ดู
- บริษัทไม่ได้บอกขนาดหน้าต่างบริบทด้วย ใครเห็นตัวเลขส่วนนี้ลอย ๆ ให้ระวัง
อย่าเข้าใจผิด
- ตัวเลขทั้งหมดเป็นการอ้างของบริษัทเอง ยังไม่มีฝ่ายอิสระออกมายืนยัน
- เรื่องถูกกว่าให้ยึดแค่คำอ้างเรื่องคะแนนเทียบต้นทุนในโพสต์ อย่าแปลงเป็นราคาโทเคนเป็นดอลลาร์เอง
- อย่าเอาสเปกของ Kimi K3 อย่างขนาดบริบทมาใส่ให้ SWE-2 เพราะบริษัทไม่ได้พูดเรื่องนั้น
สรุป
ถ้าใครถามว่าข่าว AI วันนี้มีอะไร บอกได้ว่า Cognition โยนโมเดล SWE-2 มาเคลมว่าเก่งระดับแนวหน้าในต้นทุนที่ถูกกว่า แต่ยังเป็นตัวเลขของบริษัทเอง ค่อย ๆ เชื่อแล้วรอดูงานจริงก็ไม่เสียหาย
แหล่ง: Cognition · 10 ก.ย. 2026