สิ่งที่ควรรู้
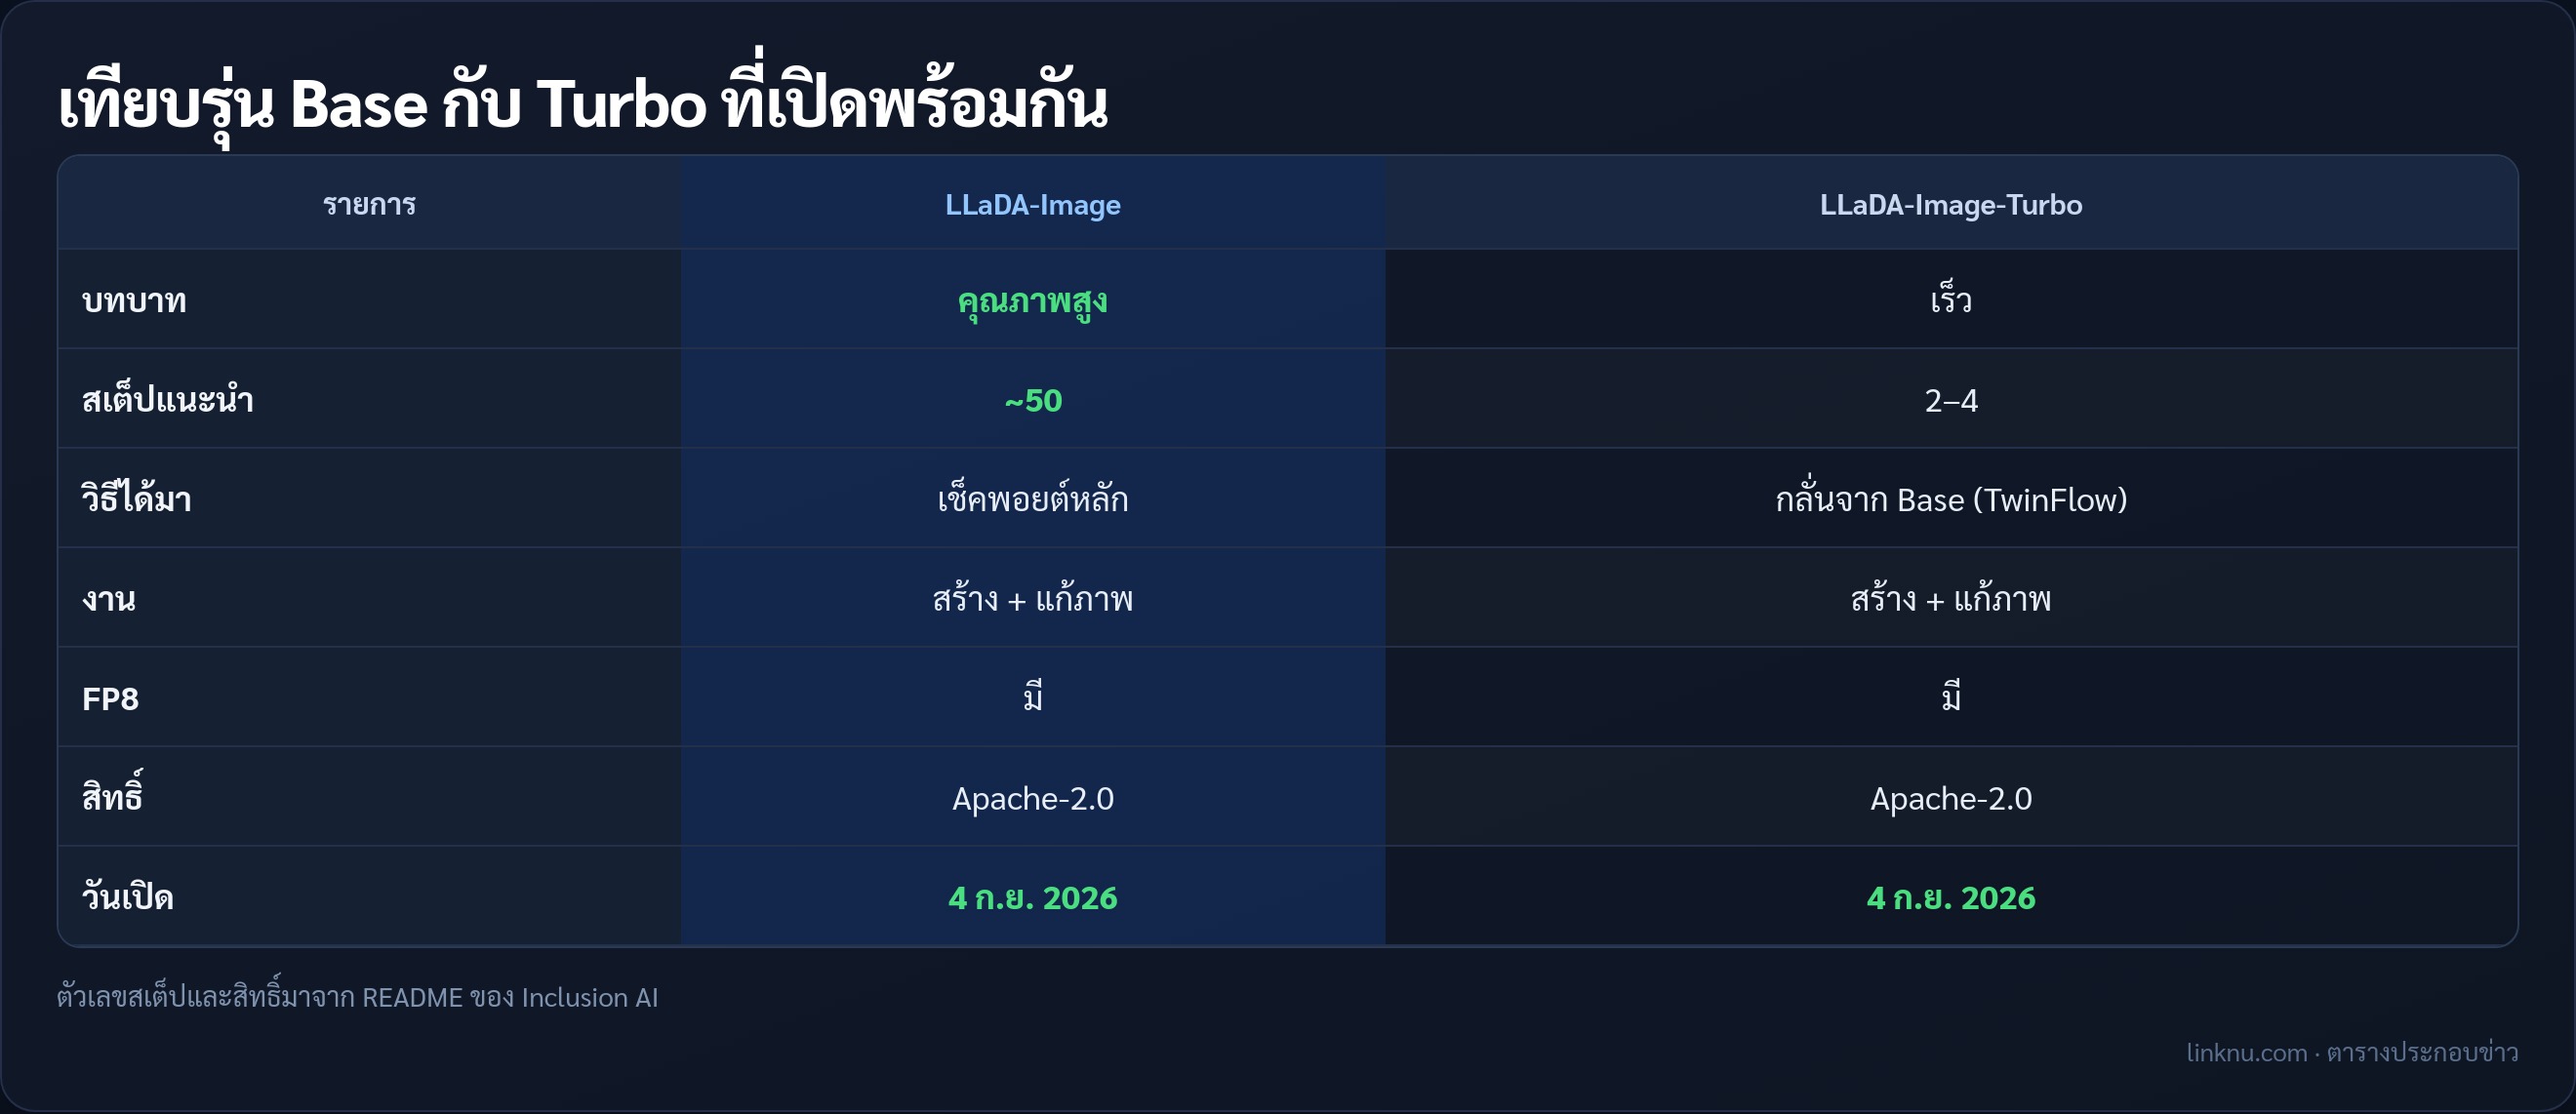
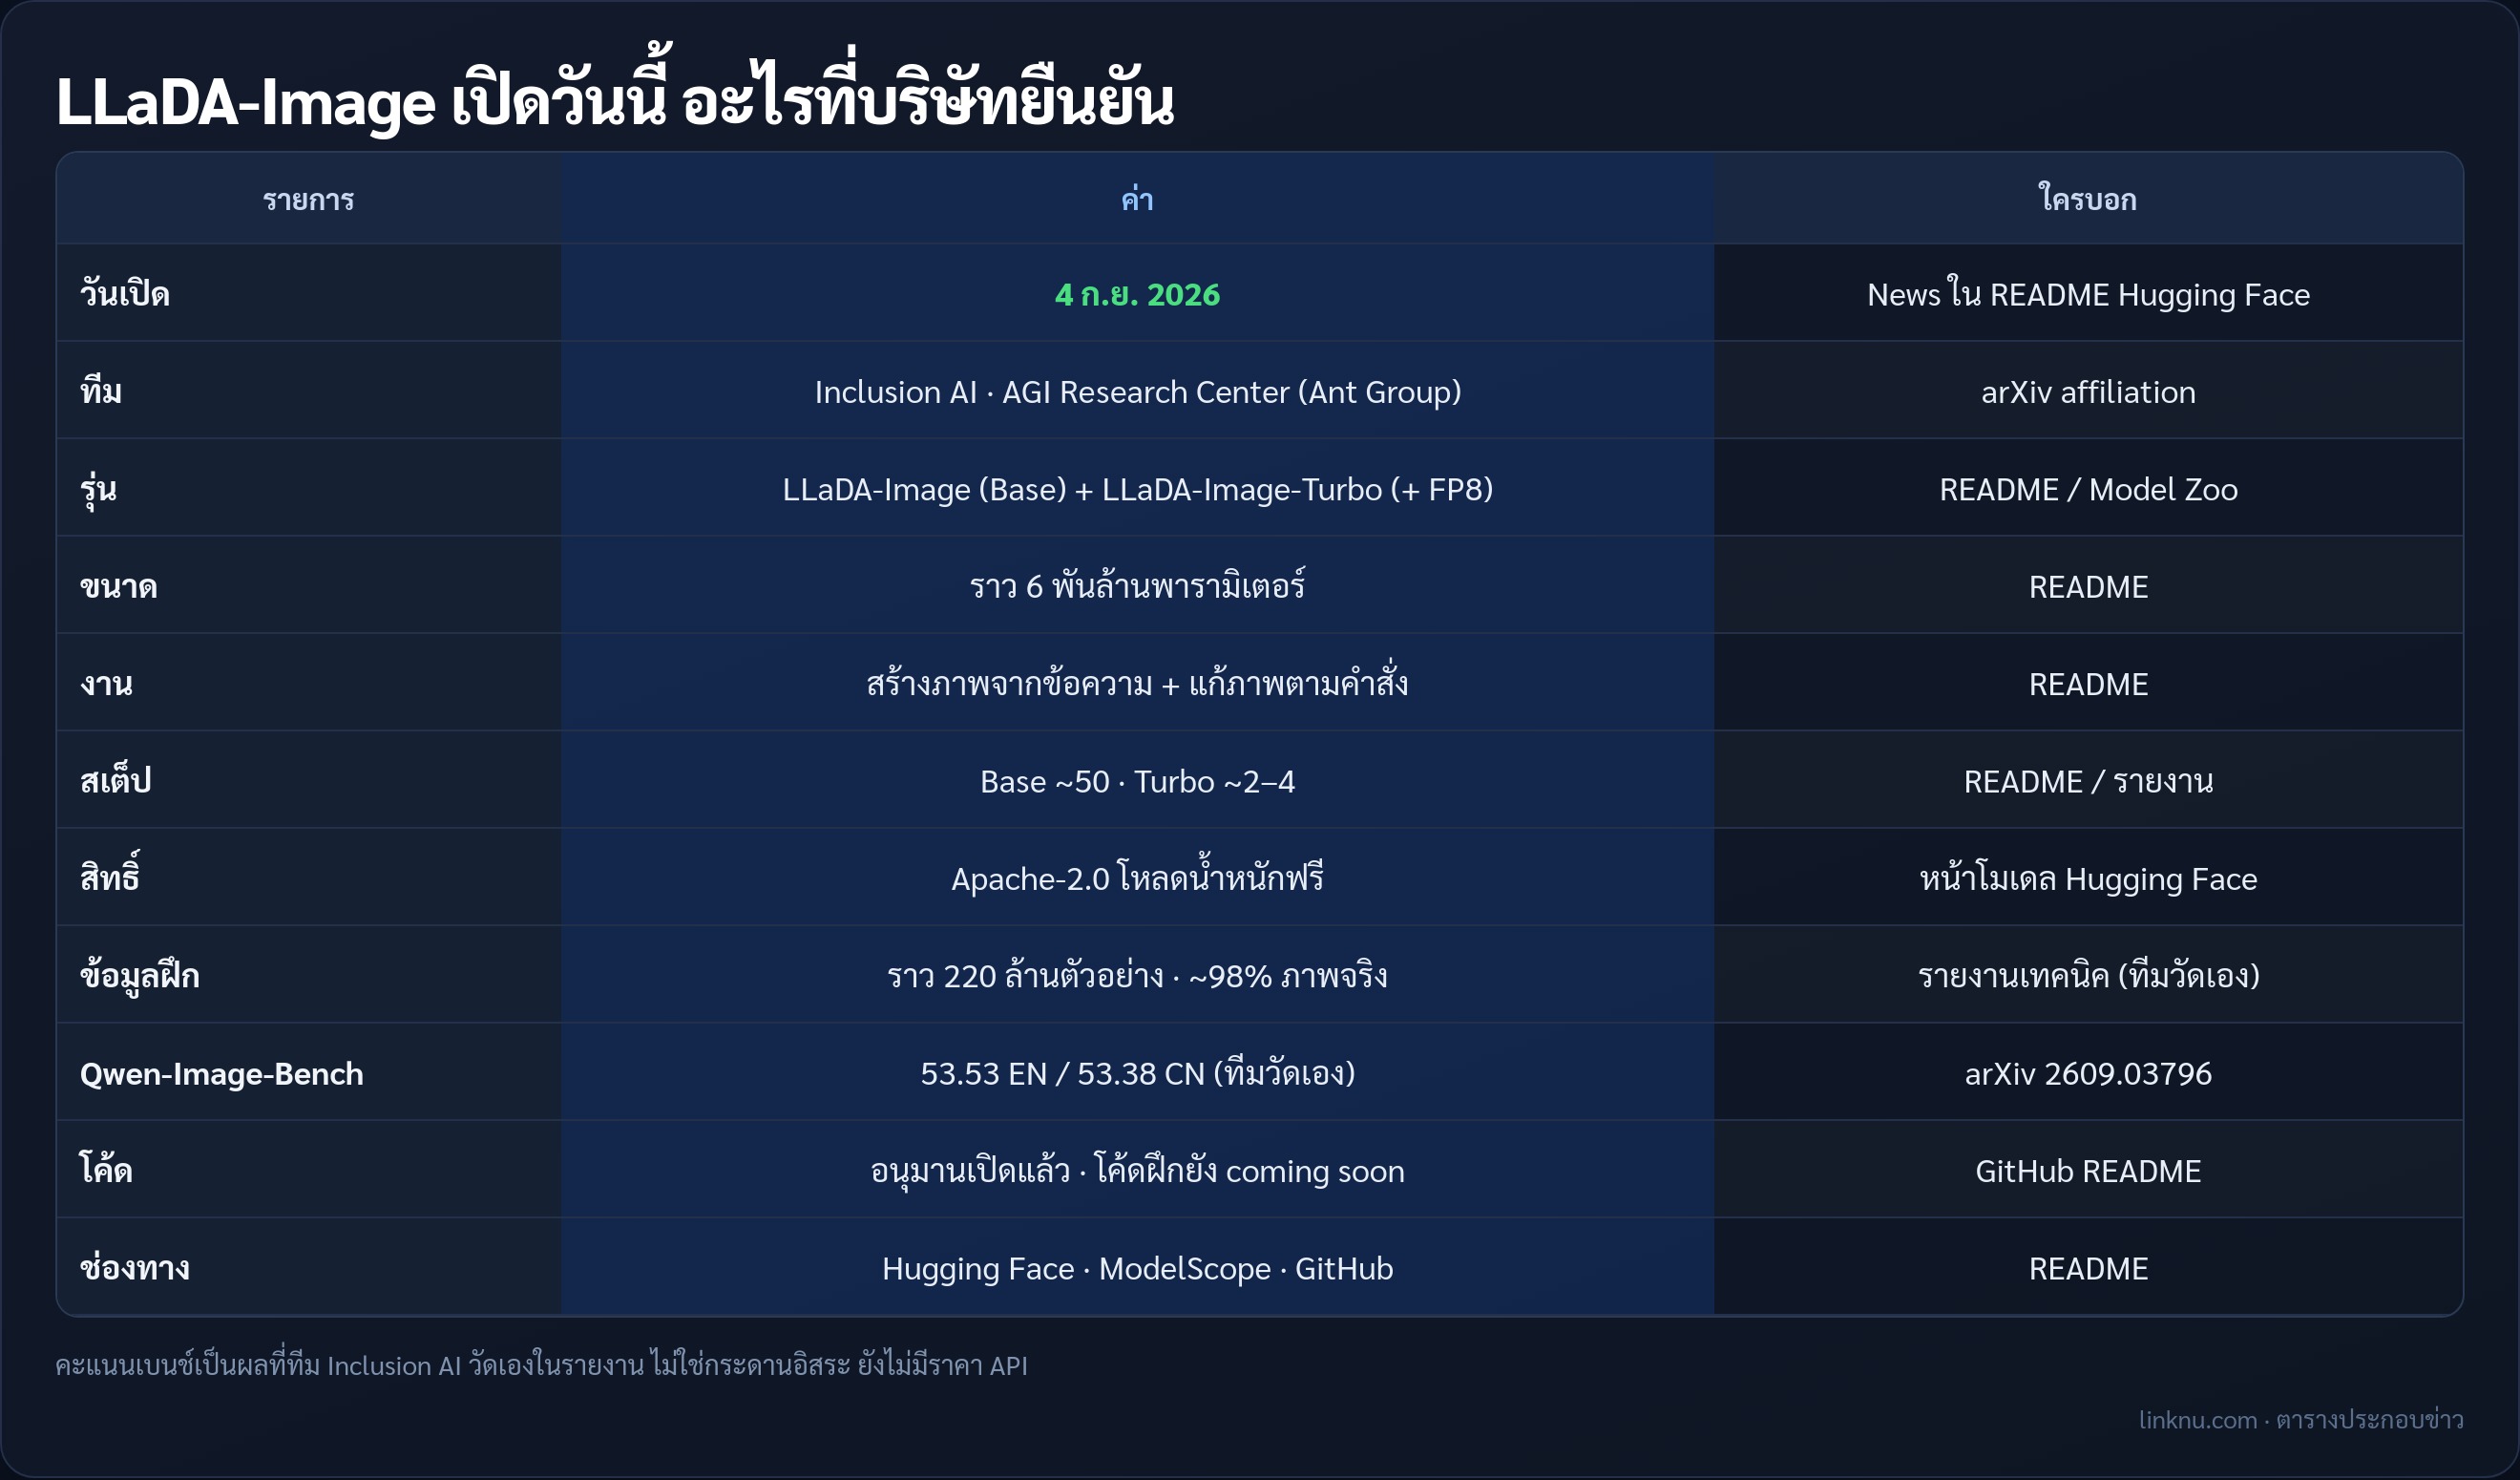
- ออกมาสองรุ่น รุ่นปกติแนะนำให้รันราว 50 สเต็ป ส่วนรุ่นเร็ว (Turbo) ผ่านการกลั่นโมเดลด้วยวิธี TwinFlow กับ Twin-DMD เหลือแค่ 2–4 สเต็ป (เอกสารบริษัท)
- ใส่ตัวอักษรภาษาจีนและอังกฤษลงในภาพได้ (รายงานเทคนิค arXiv:2609.03796)
- ขนาดราว 6 พันล้านพารามิเตอร์ มีไฟล์น้ำหนักแบบกินหน่วยความจำน้อยลง (FP8) ให้ทั้งสองรุ่น (หน้าโมเดลบน Hugging Face)
- ปล่อยทั้งน้ำหนักและโค้ดแบบสิทธิ์ Apache-2.0 (หน้าโมเดลบน Hugging Face)
- คะแนนจากชุดทดสอบ Qwen-Image-Bench อยู่ที่ 53.53 ฝั่งอังกฤษ และ 53.38 ฝั่งจีน เป็นตัวเลขที่ทีมวัดเองและอ้างว่าอันดับหนึ่งในกลุ่มโอเพนซอร์สที่เทียบในรายงาน ยังไม่ใช่ผลจากกระดานอิสระ (รายงานเทคนิคของบริษัท)
- ฝึกด้วยข้อมูลราว 220 ล้านตัวอย่าง ส่วนใหญ่ราว 98% เป็นภาพจริง ตัวเข้ารหัส-ถอดรหัสภาพ (VAE) ยืมชุดของ FLUX.2 มาใช้ (รายงานเทคนิคของบริษัท)
- โค้ดสำหรับรัน (อนุมาน) มาพร้อมแล้ว แต่โค้ดฝึกยังเขียนไว้ในไฟล์ README ว่ากำลังจะตามมา ยังไม่ได้เปิดครบ (GitHub)
- โหลดได้จากเว็บแชร์โมเดล Hugging Face และ ModelScope รุ่นปกติอยู่ที่รีโป inclusionAI/LLaDA-Image ส่วนรุ่นเร็วใช้ชื่อ LLaDA-Image-Turbo (Hugging Face)
สรุป
โมเดลวาดภาพที่โหลดมาลงเครื่องตัวเองได้ ทั้งวาดใหม่ แก้ภาพ ใส่ตัวอักษรจีน-อังกฤษ ครบในตัวเดียว จะเก่งจริงแค่ไหน เอามาวาดเล่นดูเองคงรู้เร็วกว่ารอใครมารีวิว
แหล่ง: Inclusion AI (Hugging Face · GitHub · arXiv 2609.03796) · 4 กันยายน 2026