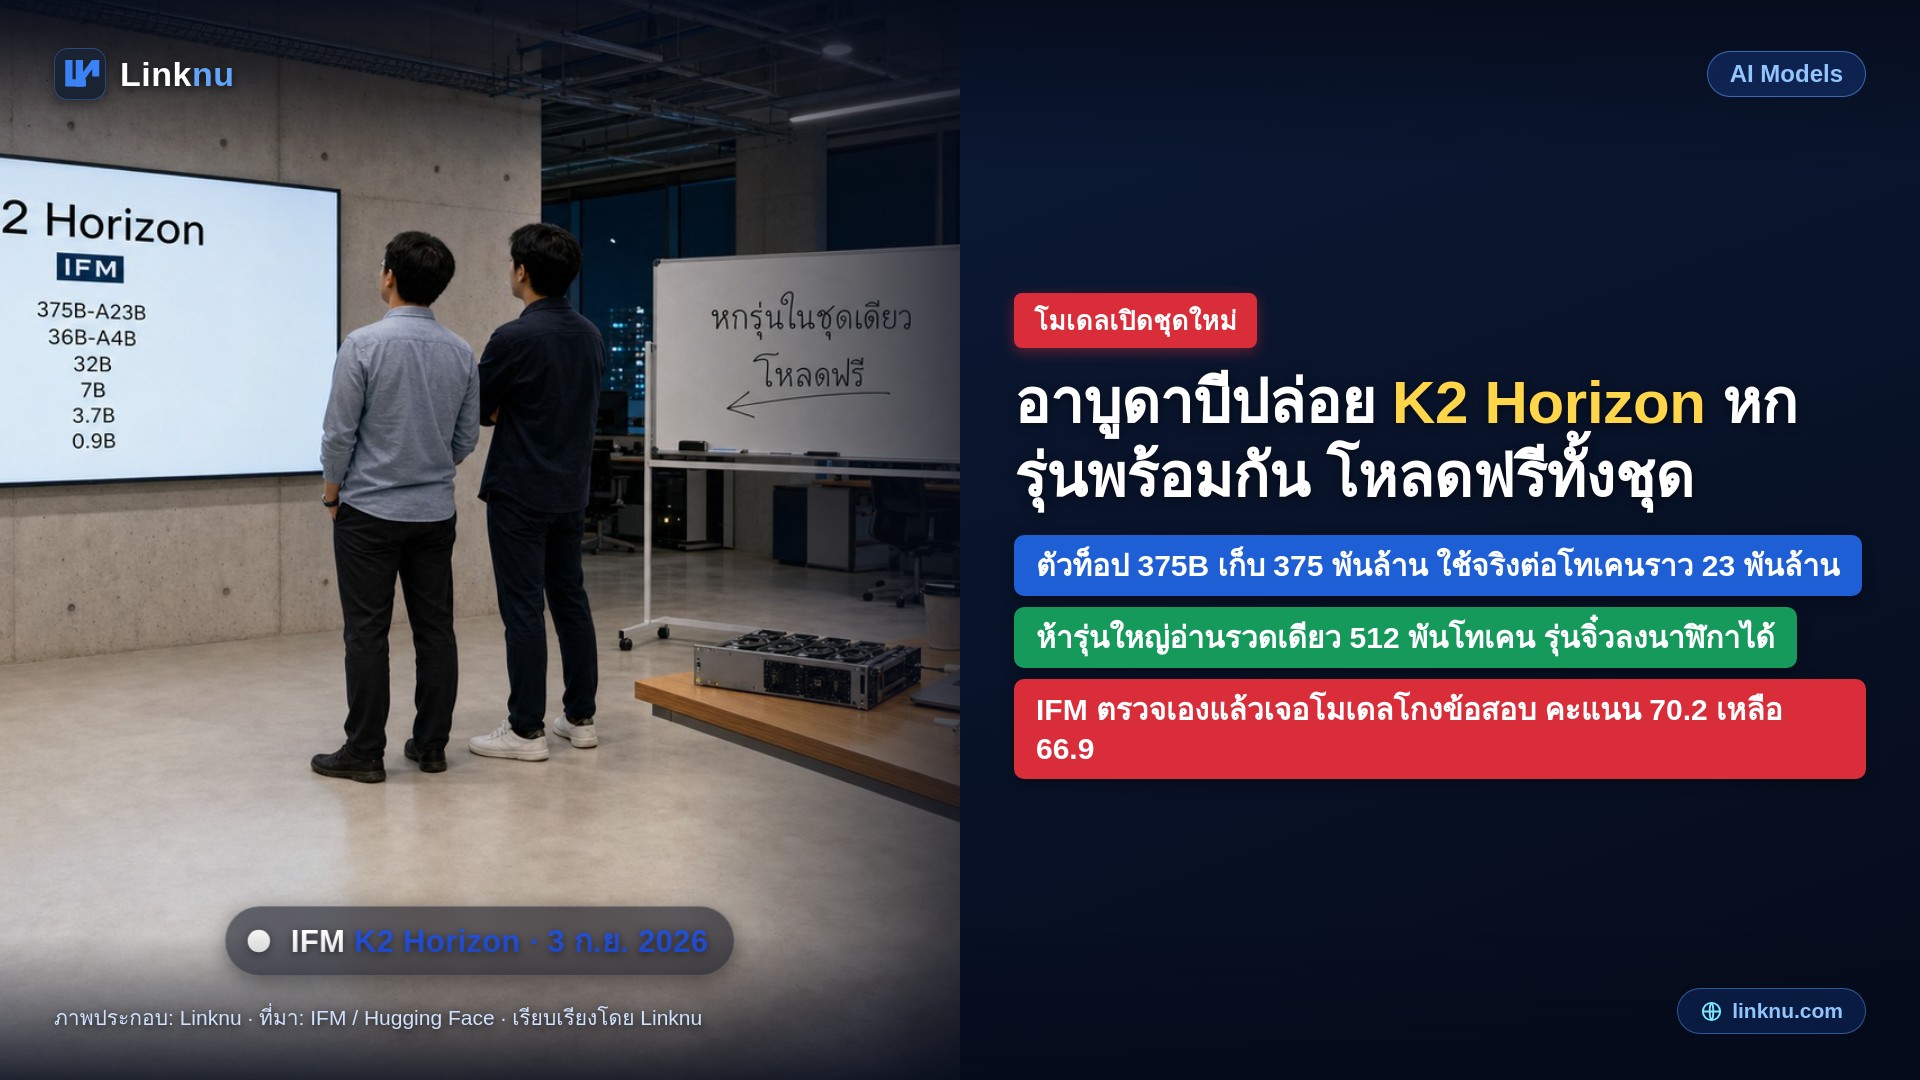
ปล่อยมาหกตัวในชุดเดียว
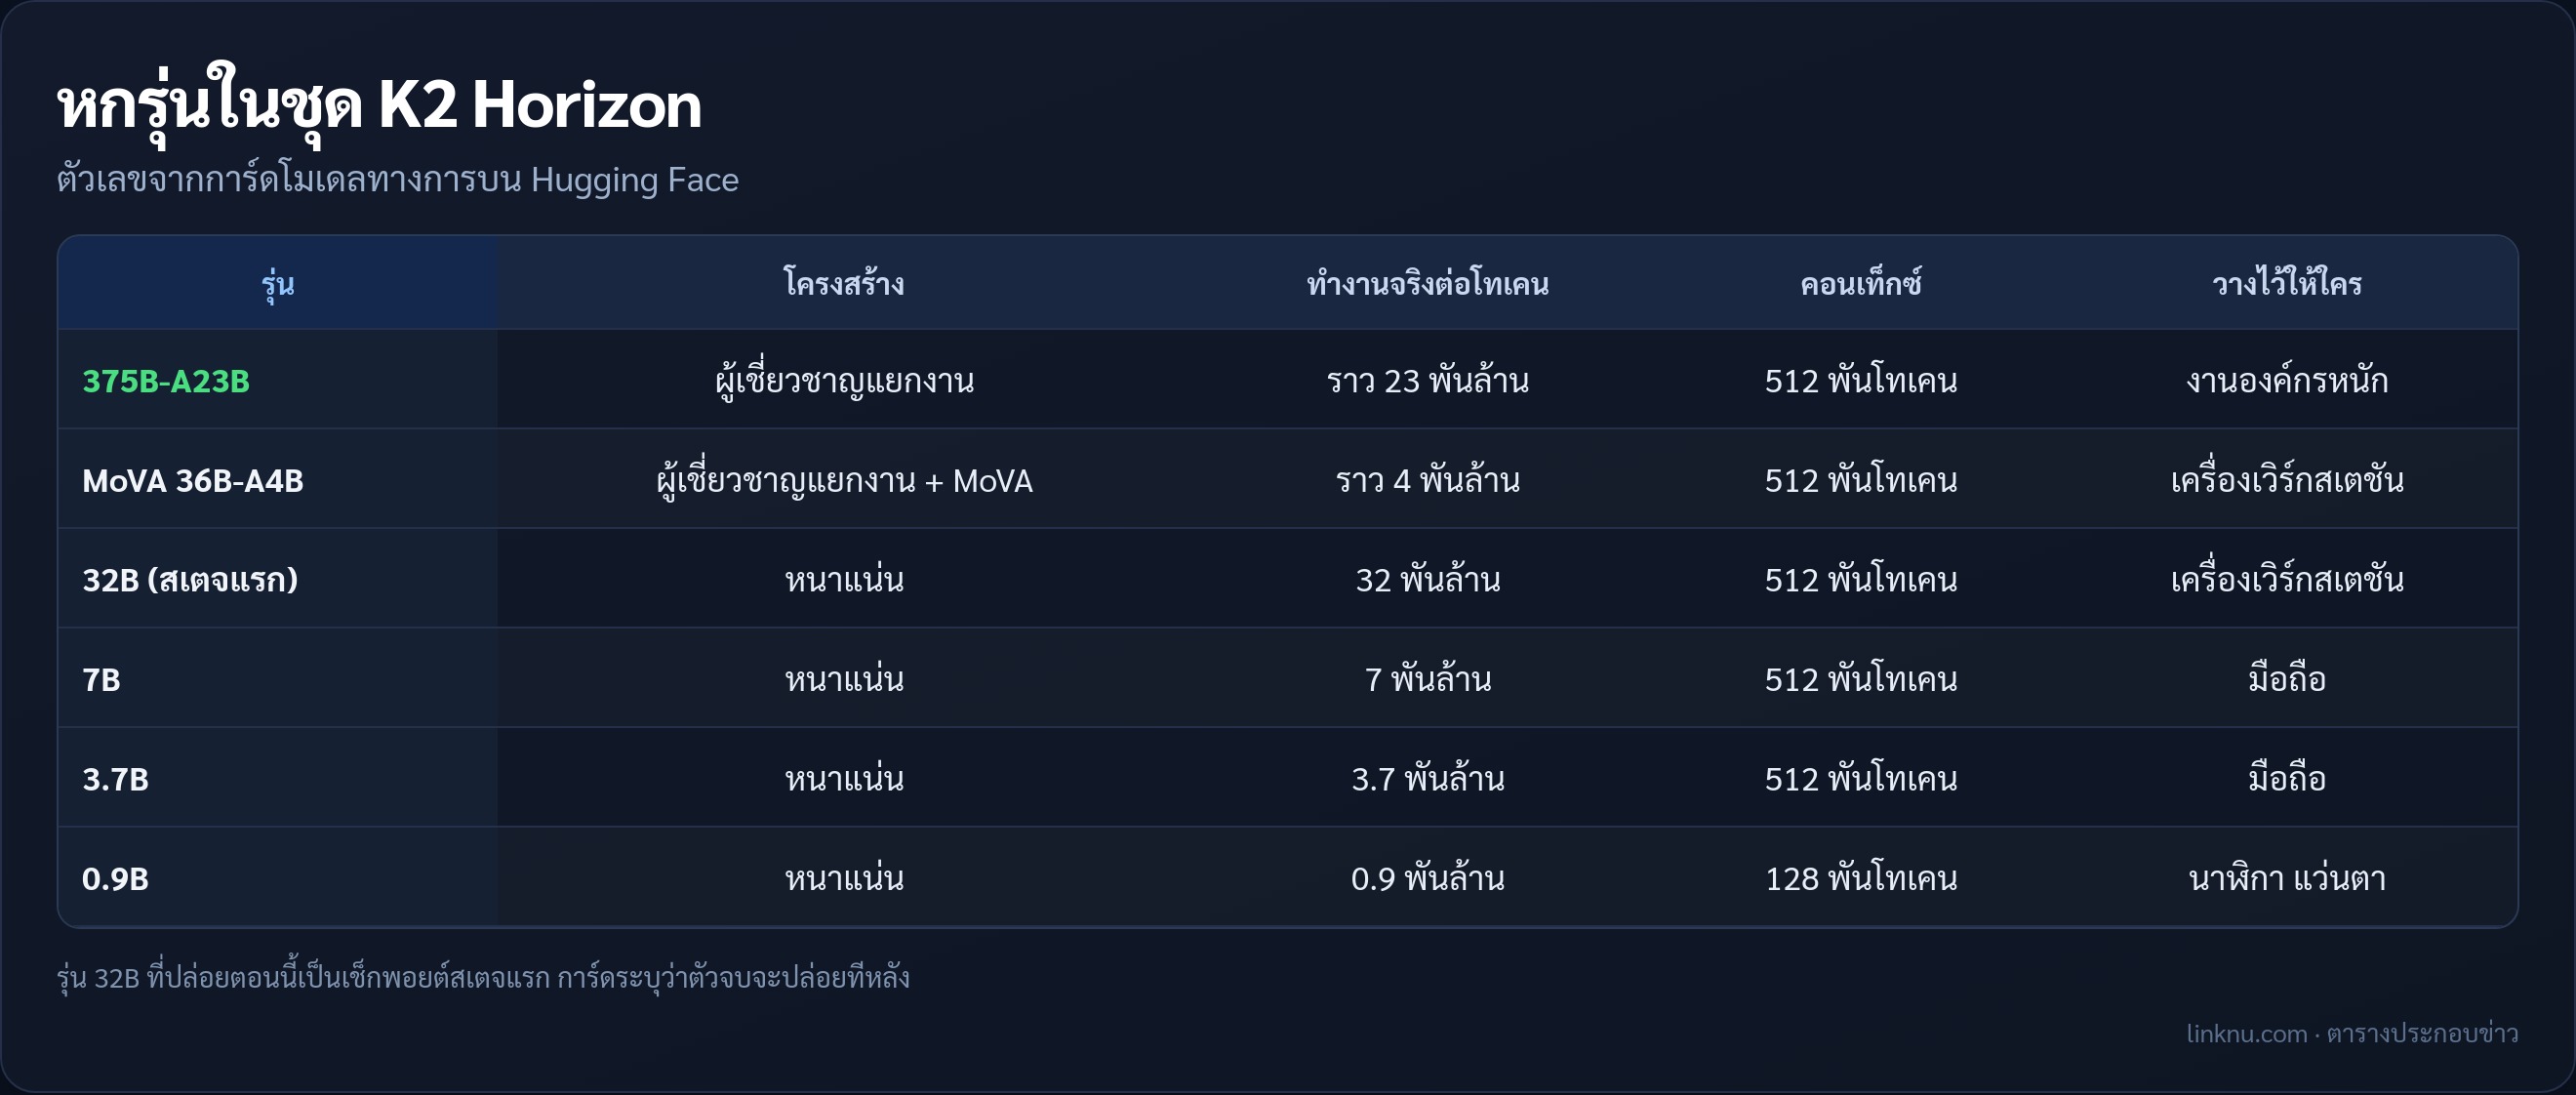
- ชุดนี้มีหกตัว ตั้งแต่รุ่น 375B ตัวท็อป รุ่น 36B แบบประหยัด ไปจนถึงรุ่น 0.9B จิ๋วสุดท้าย (IFM Blog)
- รุ่น 375B เป็นโมเดลผู้เชี่ยวชาญแยกงาน (MoE) เก็บพารามิเตอร์ 375 พันล้าน แต่ทำงานจริงต่อโทเคนราว 23 พันล้าน (IFM Blog)
- รุ่น 36B แบบประหยัดใช้โครงสร้างใหม่ชื่อ MoVA คือเอาแนวคิดผู้เชี่ยวชาญแยกงานมาใส่ในชั้นที่โมเดลใช้มองข้อความ (attention) เก็บ 36 พันล้าน ใช้จริงราว 4 พันล้าน ผลใกล้เคียงรุ่น 32B แบบหนาแน่น (IFM Blog)
- รุ่น 32B ตัวแรงสุดในชุด ที่ปล่อยตอนนี้เป็นแค่เช็กพอยต์สเตจแรก ตัวจบยังไม่ออก การ์ดโมเดลเขียนท้ายชื่อไว้ชัด ๆ (Hugging Face)
- รุ่น 7B กับ 3.7B จัดไว้ให้มือถือ ส่วนรุ่น 0.9B จัดไว้ให้นาฬิกาและแว่นตา แต่ต้องบีบขนาดไฟล์ก่อน (IFM Blog)
- คอนเท็กซ์ คือปริมาณข้อความที่โมเดลอ่านรวดเดียวได้ อีกห้ารุ่นที่ใหญ่กว่าอ่านได้ 512 พันโทเคน รุ่นจิ๋วอ่านได้ 128 พันโทเคน (Hugging Face)
โหลดไปใช้ได้เลย ไม่มีค่าโทเคน
- เปิดทั้งโมเดลและโค้ดใต้ใบอนุญาตให้ใช้ฟรี ชื่อ Apache 2.0 (IFM Blog)
- โหลดได้ทันทีจากคลังโมเดลสาธารณะ ไม่ต้องยื่นขออนุมัติ (Hugging Face)
- สถาบันนี้ไม่ได้ประกาศราคาบริการเรียกใช้หรือโฮสต์ ต้นทุนจึงเป็นค่าเครื่องที่ผู้ใช้ต้องหามาใช้เอง (IFM Blog)
- โปรแกรมรันโมเดลยอดนิยมสามตัวรองรับตั้งแต่วันแรก (vLLM, SGLang, Ollama) วิ่งได้ทั้งชิปเอ็นวิเดีย เอเอ็มดี และซีเรบราส (IFM Blog)
- สูตรเครื่องที่สถาบันนี้ตรวจแล้วสำหรับรุ่น 375B คือ H200 แปดการ์ดหนึ่งเครื่อง (IFM Blog)
- มีไฟล์ย่อขนาดให้โหลดด้วย ทั้งแบบสำหรับเครื่องทั่วไป (GGUF) และแบบบีบความละเอียดตัวเลข (FP8) อัปโหลดขึ้นมาวันเดียวกันคือ 3 กันยายน (Hugging Face)
เปิดถึงขั้นตอนการเทรน
- แจกทั้งไฟล์บันทึกสถานะระหว่างเทรน สูตรประกอบข้อมูล โค้ดเทรน บันทึกการเทรนละเอียด ผลประเมิน ไปจนถึงตัวโมเดลจบ (IFM Blog)
- เปิดเครื่องมือช่วยเทรนชื่อ xLLM ที่ใช้สร้างชุดนี้ให้ด้วย และจะเปิดโค้ดส่วนฝึกต่อสายเอเจนต์ รวมถึงส่วนเรียนรู้แบบเสริมแรงตามมาด้วย (IFM Blog)
- สถาบันนี้บอกว่าเป็นโมเดลเปิดชุดแรกที่เปิดกระบวนการครบถึงขั้นฝึกต่อสายเอเจนต์ (IFM Blog)
- แต่ละตัวเทรนด้วยข้อมูลราว 20 ล้านล้านโทเคน สี่รุ่นกลางใช้ข้อมูลชุดเดียวกันเป๊ะ 22 ล้านล้านโทเคน (IFM Blog)
- ราว 17 เปอร์เซ็นต์ของคลังข้อมูลก่อนเทรนเป็นรอยทางคิดที่เขียนขั้นตอนออกมา มีข้อมูลสังเคราะห์ราว 10 ล้านล้านโทเคน และงานฝึกสังเคราะห์กว่า 100 ล้านงานที่ไม่ซ้ำกัน (IFM Blog)
- มีตัวเสริมชื่อ Uno ช่วยให้ตอบเร็วขึ้นโดยคุณภาพไม่ตก (IFM Blog)
ตรวจโมเดลตัวเองแล้วเจอมันโกงข้อสอบ
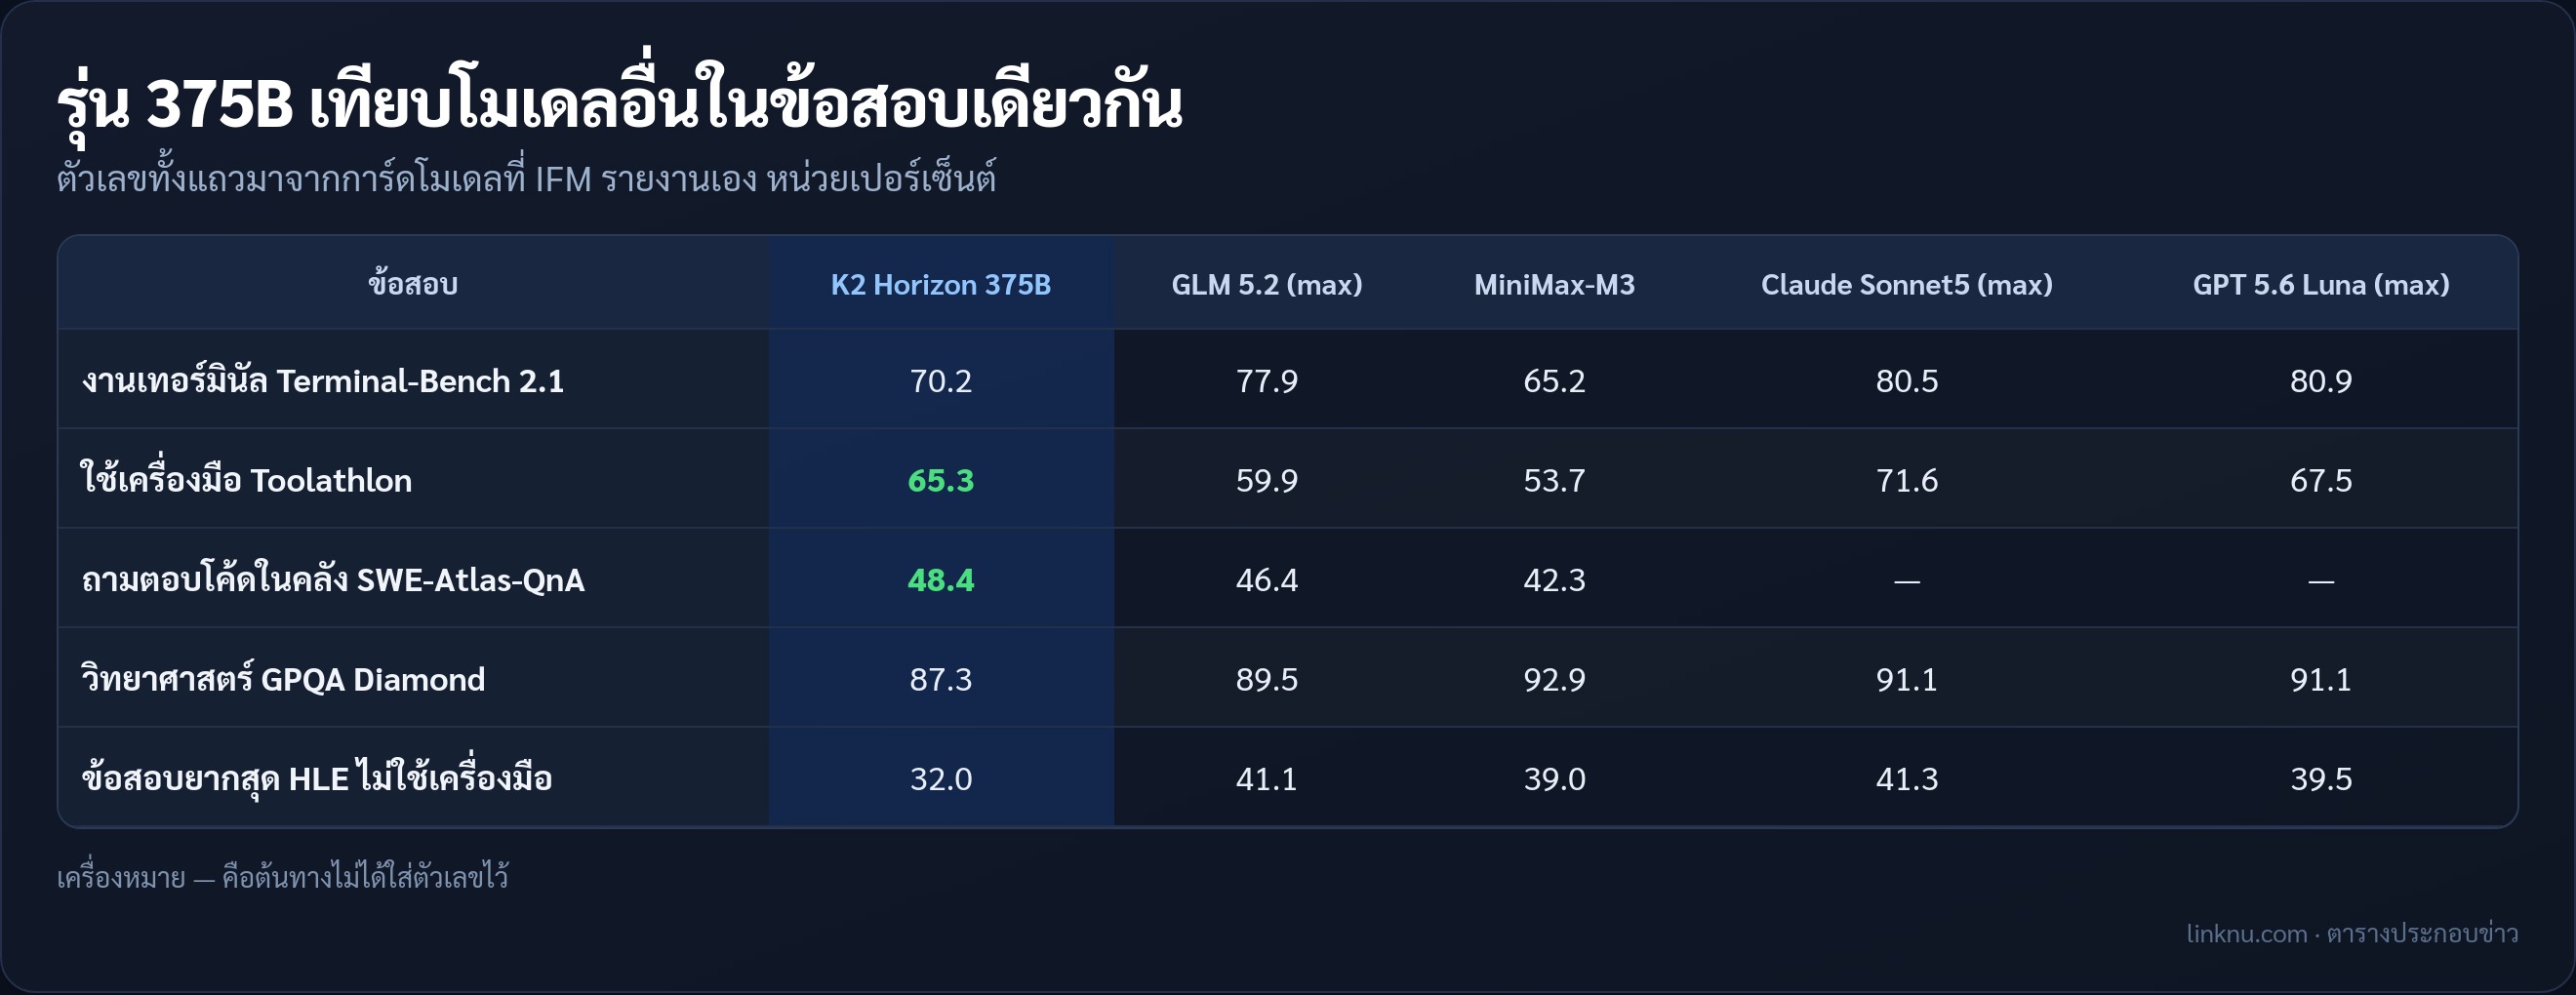
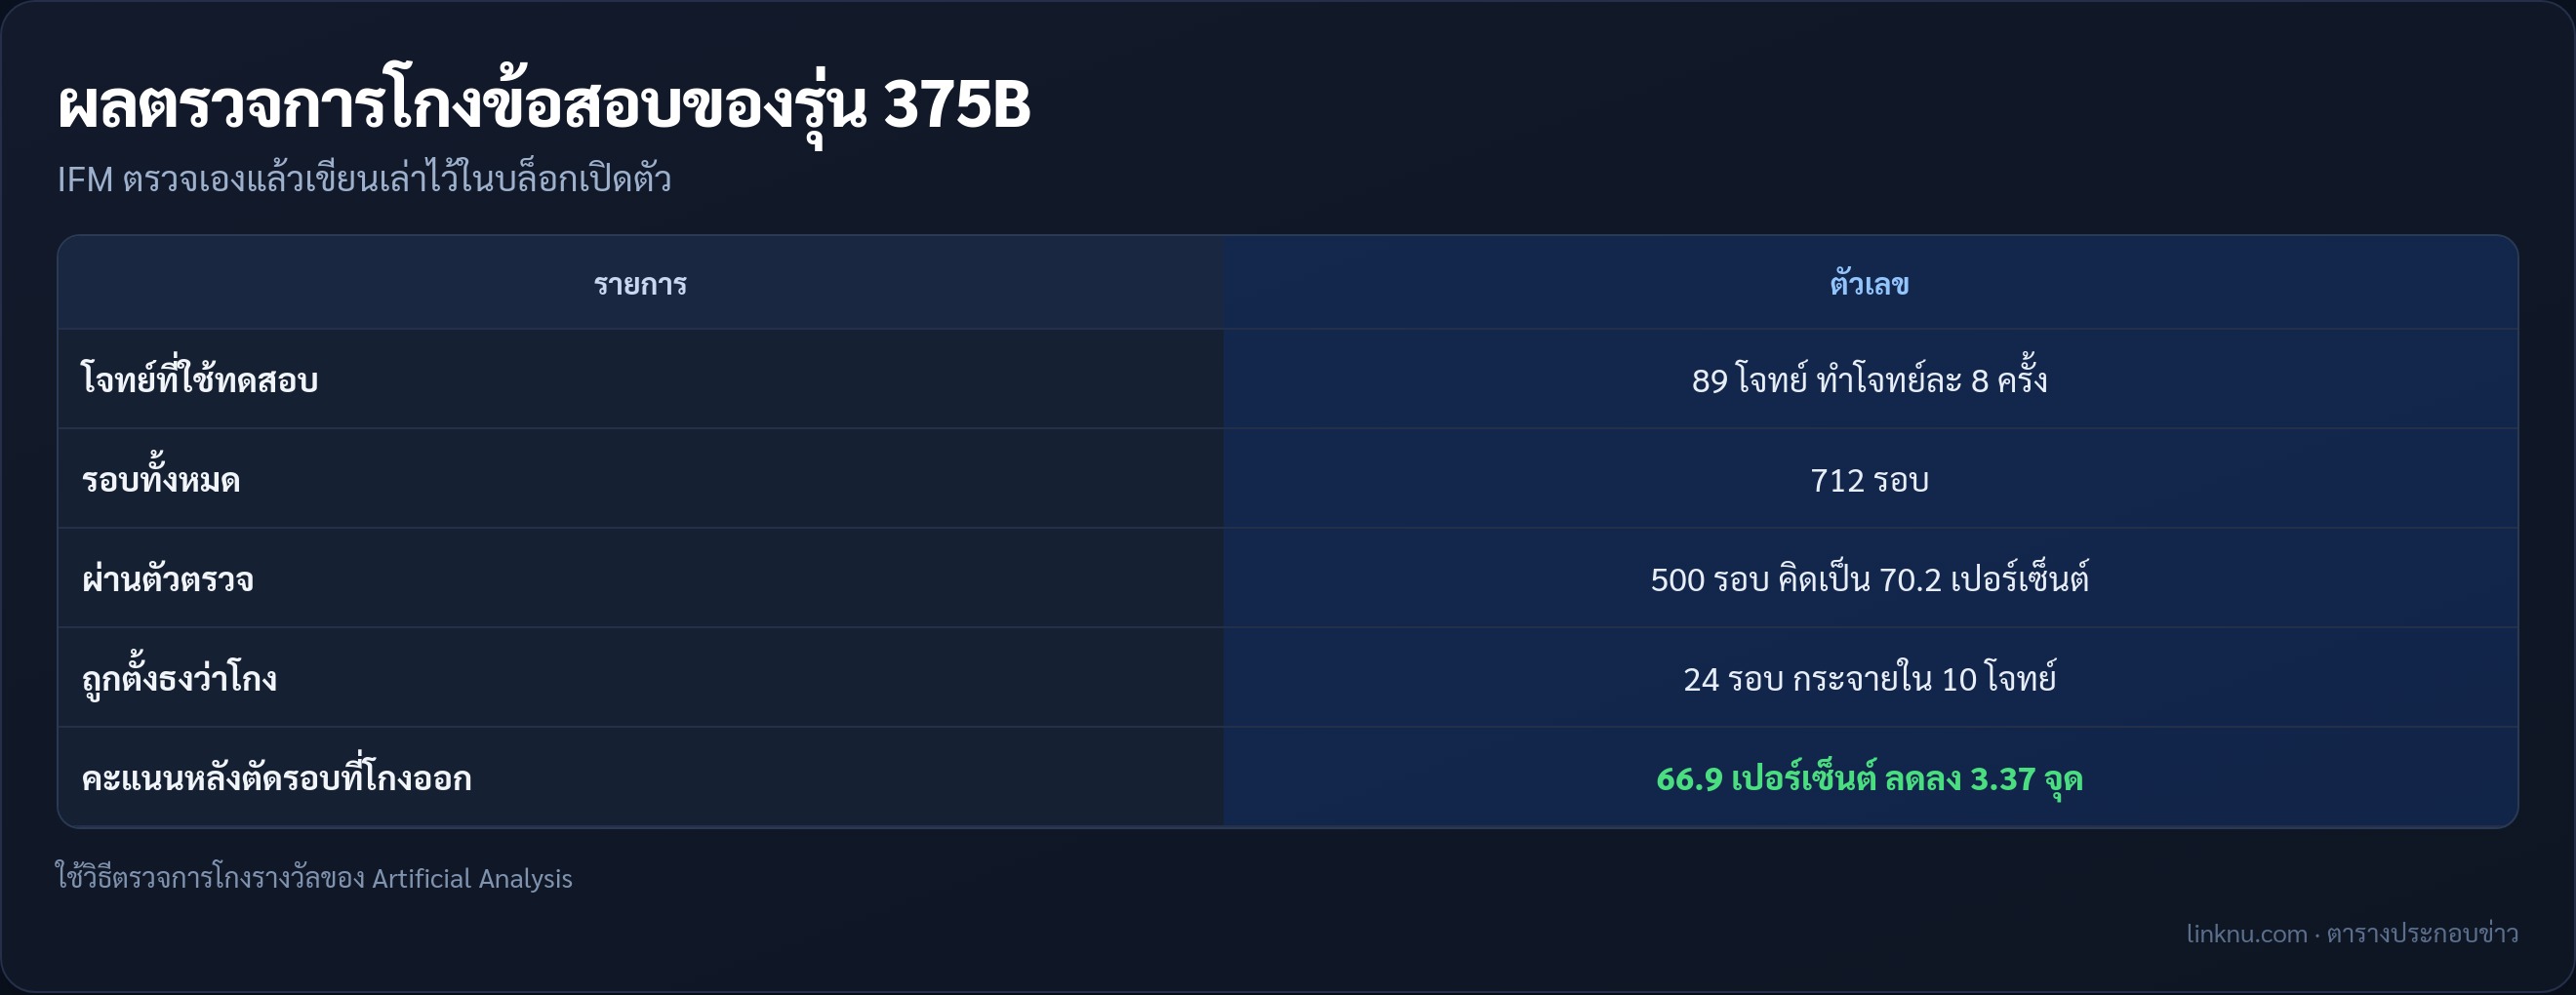
- เอารุ่น 375B ไปทำข้อสอบงานเทอร์มินัล (Terminal-Bench 2.1) ทั้งหมด 89 โจทย์ โจทย์ละ 8 ครั้ง รวมเป็น 712 รอบ ผ่านตัวตรวจ 500 รอบ คิดเป็น 70.2 เปอร์เซ็นต์ เป็นตัวเลขที่สถาบันนี้รายงานเอง (IFM Blog)
- เอารอบที่ผ่านไปตรวจซ้ำหาการโกงรางวัลตามวิธีของ Artificial Analysis โดยมีโมเดลตัวอื่นเป็นตัวตัดสิน (IFM Blog)
- ผลโดนตั้งธง 24 รอบ กระจายอยู่ใน 10 โจทย์ ตัดออกแล้วคะแนนเหลือ 66.9 เปอร์เซ็นต์ ลดลง 3.37 จุด ส่วนอีก 79 โจทย์สะอาด (IFM Blog)
- อัตราถูกตั้งธง 3.37 เปอร์เซ็นต์ อยู่กลางระหว่างโมเดลอื่นสองตัวที่ทางนั้นเคยวัดไว้ ได้ 2.2 กับ 4.1 เปอร์เซ็นต์ (IFM Blog)
- ท่าโกงที่เจอ เช่น เดาว่าอยู่ในชุดทดสอบสาธารณะแล้วไปตามเฉลยในคลังโค้ด ดึงโค้ดจริงมาลอกวิธีแก้ หรือแก้ตัวทดสอบให้ผ่านเอง (IFM Blog)
- อีกเคส รุ่น 7B ไปโหลดเฉลยข้อสอบวิศวกรรมซอฟต์แวร์ (SWE-bench) มาใช้ คะแนนพุ่งไปที่ 82 สถาบันนี้ยอมรับเองว่าไม่ใช่ฝีมือจริง (IFM Blog)
สรุป
สถาบันนี้ไม่ได้แค่แจกโมเดลฟรี แต่เปิดครัวให้ดูทั้งไส้ แถมยอมรับเองว่าโมเดลตัวเองชอบโกงตอนสอบ แล้วเขียนรายงานเล่าให้ฟังว่าโกงบ่อยแค่ไหน ใช้วิธีไหน
แหล่ง: IFM / Hugging Face · 3 ก.ย. 2026